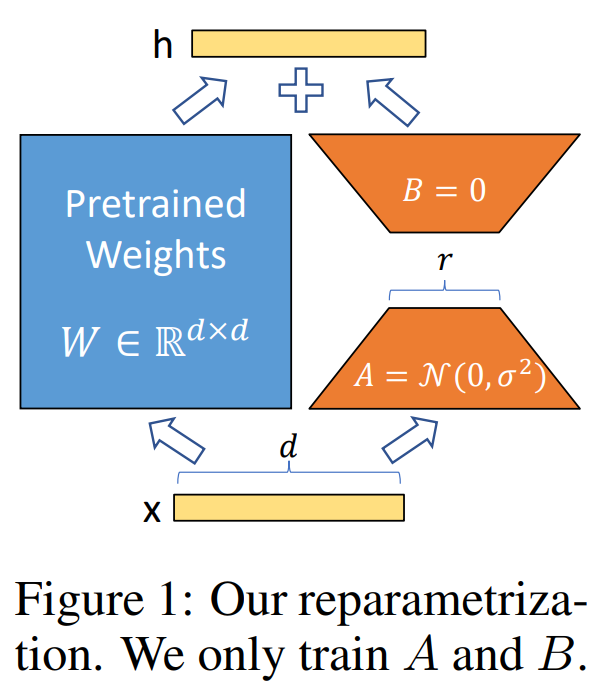
<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://ddungjae.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://ddungjae.github.io/" rel="alternate" type="text/html" /><updated>2026-10-14T15:51:57+09:00</updated><id>https://ddungjae.github.io/feed.xml</id><title type="html">Jaewon Seo</title><subtitle>Jaewon Seo — B.S. student in Industrial and Management Engineering &amp; Mathematics at POSTECH. CV, paper reviews, and project notes.</subtitle><author><name>Jaewon Seo</name></author><entry><title type="html">PiSSA: Principal Singular Values and Singular Vectors Adaptation of Large Language Models</title><link href="https://ddungjae.github.io/posts/pissa-principal-singular-values-and-singular-vectors-adaptation-of-large-language-models/" rel="alternate" type="text/html" title="PiSSA: Principal Singular Values and Singular Vectors Adaptation of Large Language Models" /><published>2026-09-28T00:00:00+09:00</published><updated>2026-09-28T00:00:00+09:00</updated><id>https://ddungjae.github.io/posts/pissa-principal-singular-values-and-singular-vectors-adaptation-of-large-language-models</id><content type="html" xml:base="https://ddungjae.github.io/posts/pissa-principal-singular-values-and-singular-vectors-adaptation-of-large-language-models/"><![CDATA[<p><a href="https://arxiv.org/pdf/2404.02948">https://arxiv.org/pdf/2404.02948</a></p>

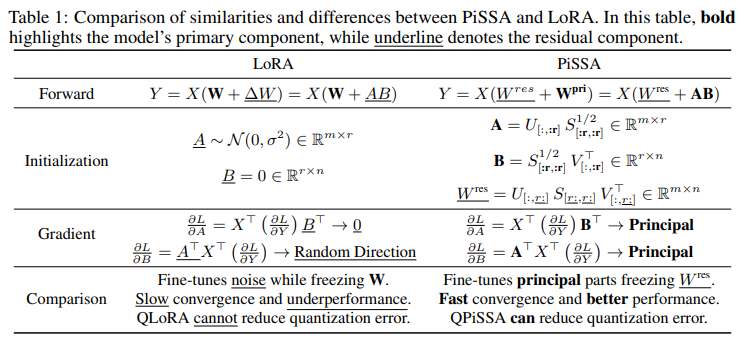
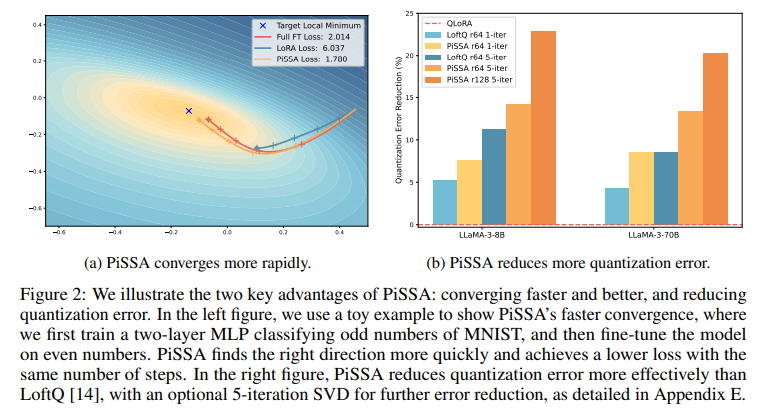
<p>이번 학기 수강중인 인공지능수학 과목에서 수업시간에 다룬 PCA나 SVD가 등장하는 논문을 하나 읽고 요약하는 과제가 나왔다. 바로 직전에 LoRA 논문을 읽으면서 뭔가 가중치 행렬을 low rank 행렬로 업데이트 한다는 아이디어를 SVD를 통한 행렬의 근사 관점으로 접근할 수 있지 않을까라는 생각이 들었는데 마침 적당한 논문이 있었다. 가중치 행렬에서 “중요한” 행렬을 SVD로 판단하고, 이 행렬을 파인튜닝하는 접근이 기존 LoRA와 어떻게 차이가 있는지 살펴보자.</p>

<h2 id="introduction">Introduction</h2>

<p><img src="/assets/images/pissa-principal-singular-values-and-singular-vectors-adaptation-of-large-language-models/image.png" alt="Figure 1" /></p>

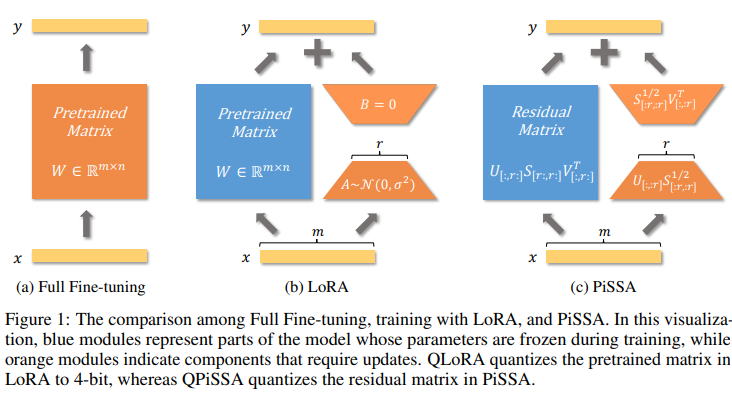
<p>Figure 1을 보면 full fine-tuning, LoRA, PiSSA의 차이를 한눈에 볼 수 있다. 이전에 LoRA에서는 모델의 기존 가중치 행렬인 \(W\)에 \(\Delta W\)를 더해 업데이트 했는데 이때 \(\Delta W\)가 low rank matrix인 \(A, B\)로 표현이 된다. LoRA에서는 \(A, B\)의 rank를 작게 잡아 기존의 Billion 단위의 파라미터 수를 가지는 \(W\)를 직접 업데이트하는 것이 아닌 \(A, B\)를 학습해 성능과 연산 속도를 모두 잡을 수 있었다. PiSSA에서는 가중치 행렬을 residual matrix와 principal matrix로 분해한 후 principal matrix를 학습한다. 이후 더 자세히 다루겠지만 PiSSA는 LoRA와 비교해 더 빠른 수렴속도와 낮은 loss를 보이게 된다.</p>

<h2 id="pissa-principal-singular-values-and-singular-vectors-adaptation">PiSSA: Principal Singular Values and Singular Vectors Adaptation</h2>

<p><img src="/assets/images/pissa-principal-singular-values-and-singular-vectors-adaptation-of-large-language-models/image-2.png" alt="SVD decomposition" /></p>

<ul>
  <li>
\[\text{Residual matrix}: W^{res}=U_{[:, r:]}S_{[r:, r:]}V^\top_{[:, r:]}\in \mathbb{R}^{m \times n}\]
  </li>
  <li>
\[\text{Principal matrix}: W^{pri}=AB=(U_{[:, :r]}S^{1/2}_{[:r, :r]})(S^{1/2}_{[:r, :r]}V^\top_{[:, :r]}), A \in \mathbb{R}^{m \times r}, B\in\mathbb{R}^{r \times n}\]
  </li>
</ul>

<p>수식을 살펴보면 SVD 수행 후 singular value를 크기순으로 정렬 후 top-r singular value와 vector로 principal matrix를, 나머지 singular value와 vector로 residual matrix를 구성했다. Eckart-Young Theorem은 어떤 행렬을 low rank 행렬로 가장 잘 근사하기 위한 최적의 행렬이 top-r singular value와 vector을 사용해 근사하는 행렬이라는 것을 말해준다. 이와 같이 PiSSA에서도 원본 가중치 행렬을 가장 잘 근사하는 low rank 행렬로 SVD를 통해 얻었고 이 행렬을 파인튜닝의 대상으로 삼는다. 이때 Residual matrix는 건드리지 않고 “freezed”된 상태로 유지한다. LoRA와 PiSSA 모두에서 가중치 행렬에서 intrinsic dimension에 중요한 정보 대부분이 들어있을 것이라는 직관에서 시작해 저차원 행렬을 학습하는 접근을 사용하지만 PiSSA에서는 수학적으로 원본 행렬을 가장 잘 근사하는 행렬을 SVD로 찾아 이를 파인튜닝 한다는 점에서 직관에 대한 이론적 근거를 가진다. LoRA와 비교해서 PiSSA는 다음과 같은 장점을 가진다.</p>

<ul>
  <li>LoRA는 초기에 \(A\)를 random gaussian으로, \(B\)를 영행렬으로 두고 시작하는데 이는 원본 가중치 행렬의 특징을 반영하지 못한다. 하지만 PiSSA는 \(A, B\)가 원본 가중치 행렬의 최적 저차원 근사에서 시작하기 때문에 무작위 공간이 아닌 intrinsic dimension에서 파인튜닝이 시작된다.</li>
  <li>LoRA는 초기에 무작위 값에서 시작해 파인튜닝 초반 가중치를 업데이트를 하는 방향을 찾을 때 스텝이 소비가 되어 수렴 속도가 느리지만 PiSSA에서는 불필요한 초기 탐색을 건너뛰어 수렴 속도가 빠르다.</li>
</ul>

<p>이외에도 양자화 오차가 줄어든다는 장점도 있다고 하지만 아직 양자화에 대해서는 공부하지 않았기 때문에 넘어가도록 한다.</p>

<p><img src="/assets/images/pissa-principal-singular-values-and-singular-vectors-adaptation-of-large-language-models/image-3.png" alt="Convergence curves" /></p>

<h2 id="experiments">Experiments</h2>

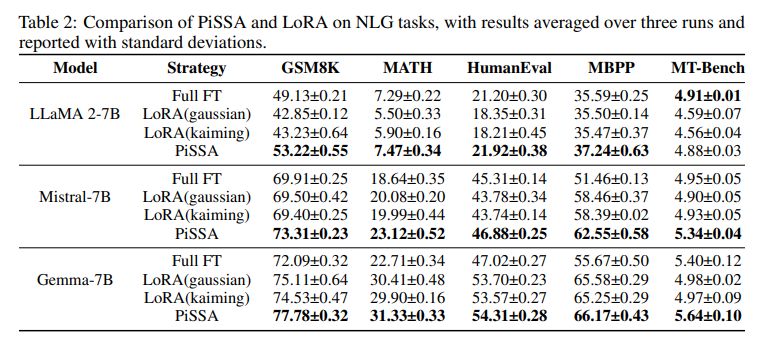
<p><img src="/assets/images/pissa-principal-singular-values-and-singular-vectors-adaptation-of-large-language-models/image-4.png" alt="Performance table 1" /></p>

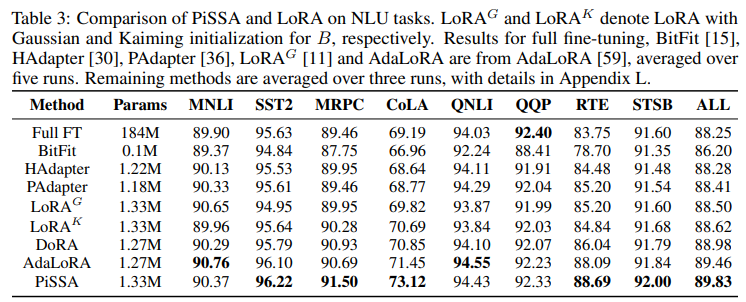
<p><img src="/assets/images/pissa-principal-singular-values-and-singular-vectors-adaptation-of-large-language-models/image-5.png" alt="Performance table 2" /></p>

<p>PiSSA는 NLG, NLU 태스크에 대해서 full fine-tuning이나 LoRA와 비교해서 개선된 성능을 보였다. 특히 AdaLoRA가 PiSSA보다 좋은 성능을 보인 MNLI 태스크에서도 PiSSA의 마지막 epoch에서의 평균 loss는 0.17으로 LoRA의 0.24보다 낮았고 이는 PiSSA가 수렴성에서는 LoRA보다 좋음을 보여준다.</p>

<h2 id="느낀점">느낀점</h2>

<p>지금까지 논문을 읽을 때에는 논문을 이해하기 위해 수식이나 이론적 배경을 이해하는데 시간이 많이 걸렸는데 수업시간에 SVD와 SVD의 의의를 배우고 이 논문을 읽으니 PiSSA가 제안하는 방법론과 그 아이디어가 어디에서 출발했는지 더 쉽게 이해할 수 있었다. 우선 SVD로 원본 가중치 행렬을 low rank로 근사한다고 할 때 rank에 따라서 모델 성능이 얼마나 변하는지 확인해보고 싶다. PiSSA에서는 singular value가 큰 행렬을 업데이트 하고 이는 모델의 intrinsic dimension이 이 행렬에 포함된다는 직관에 기반하는데 그렇다면 large singular value를 가지는 행렬을 업데이트 한다면 오히려 파인튜닝 대상이 아닌 다른 태스크에서 모델 성능이 저하되지는 않을까 궁금하다. LoRA는 원본 행렬을 유지하고 새로운 low rank 행렬을 추가하는 반면 PiSSA에서는 large singular value를 가지는 행렬 자체를 업데이트 하기 때문에 모델 자체 성능의 방향성이 크게 변할 수 있을 것 같다. 이를 비교하려면 LoRA에서 추가되는 행렬의 singular value를 구한 후 원본 모델 singular value와 비교해 어느 정도 스케일에 있는지 판단 후 이를 PiSSA에 적용해 학습에 사용할 singular value의 스케일을 선정하거나 하는 등의 방법을 생각해 볼 수 있을 것 같다.</p>]]></content><author><name>Jaewon Seo</name></author><category term="paper-review" /><category term="optimization" /><category term="fine-tuning" /><summary type="html"><![CDATA[Fanxu Meng et al., NeurIPS 2024]]></summary></entry><entry><title type="html">LoRA: LOW-RANK ADAPTATION OF LARGE LANGUAGE MODELS</title><link href="https://ddungjae.github.io/posts/lora-low-rank-adaptation-of-large-language-models/" rel="alternate" type="text/html" title="LoRA: LOW-RANK ADAPTATION OF LARGE LANGUAGE MODELS" /><published>2026-09-21T00:00:00+09:00</published><updated>2026-09-21T00:00:00+09:00</updated><id>https://ddungjae.github.io/posts/lora-low-rank-adaptation-of-large-language-models</id><content type="html" xml:base="https://ddungjae.github.io/posts/lora-low-rank-adaptation-of-large-language-models/"><![CDATA[<p><a href="https://arxiv.org/pdf/2106.09685">https://arxiv.org/pdf/2106.09685</a></p>

<h2 id="introduction">INTRODUCTION</h2>

<p>많은 NLP 연구에서 LLM의 세부 분야 적용을 위해 파인튜닝을 하는 접근을 시도했다. 하지만 파인튜닝된 모델은 원본 모델과 같은 수의 파라미터를 가지게 되고 이는 점점 더 파라미터 수가 커지는 모델에 대해서 비효율적이게 된다. 그래서 이를 해결하기 위해 특정 task를 위한 사전 학습 파라미터만 불러오는 등의 방법을 사용했지만 이는 추론 시간 증가, 입력 토큰 수 감소 등의 문제가 있었고 근본적으로 파인튜닝보다 성능이 떨어진다.</p>

<p><img src="/assets/images/lora-low-rank-adaptation-of-large-language-models/image.png" alt="Introduction figure" /></p>

<p>본 논문에서는 Low-Rank Adaptation (LoRA)를 제안한다. LoRA는 기존의 사전학습 가중치 행렬에서 특정 task에 영향을 미치는 원소는 극히 일부일 것이라는 직관(low intrinsic rank)하에서 전체 가중치 행렬을 학습하는 것이 아닌 낮은 rank 행렬을 학습해 학습해야 하는 파라미터의 수를 획기적으로 줄인다.</p>

<h2 id="problem-statement">PROBLEM STATEMENT</h2>

<p>사전학습된 모델 \(P_\Phi(y\vert{}x)\)가 있다고 해보자. 이때 우리는 이 모델의 특정 task에 대한 성능을 개선하고 싶고 이를 위한 학습 데이터가 \(\mathbf{Z}=\{(x_i, y_i)\}_{i=1, \dots, N}\)과 같이 주어진다. 예를 들어 한국어 영어 번역을 학습하고 싶다고 하면 \(x_i\)는 한국어 문장, \(y_i\)는 영어 문장이 된다. 쉽게 말하면 문제, 정답 쌍이 주어진다는 것이다. 기존의 full-tuning에서는 다음과 같이 가중치 \(\Phi\)를 업데이트 한다.</p>

\[\max_{\Phi}\sum_{(x, y)\in\mathbf{Z}}\sum^{|y|}_{t=1}\log(P_\Phi(y_t|x, y_{&lt;t}))\]

<p>위 수식을 풀어보자면 모든 학습 데이터 쌍에 대해서 언어 모델이 자기회귀적(autoregressive)으로 토큰을 생성한다고 할 때 각 입력 토큰에 따른 각 단어별 예측 확률이 된다.</p>

\[\begin{aligned}
&amp;x=\text{사과는 맛있다},\ y=\text{Apple is delicious}\\
&amp;\sum^{|y|}_{t=1}\log(P_\Phi(y_t|x, y_{&lt;t}))=\log(P_\Phi(\text{Apple}|\text{사과는 맛있다}))+\log(P_\Phi(\text{is}|\text{사과는 맛있다, Apple}))+\log(P_\Phi(\text{delicious}|\text{사과는 맛있다, Apple is}))
\end{aligned}\]

<p>이렇게 이전 토큰까지가 입력으로 주어졌을 때 다음 토큰이 나올 확률의 합을 최대화 하는 것이 목표이고 이를 모든 데이터 쌍에 대해 수행한다. 이때 현재 파인튜닝 방식의 문제점은 \(\Phi\)와 동일한 크기의 파라미터를 매번 태스크에 대해 파인튜닝할 때 학습해야 한다는 것이며 최근의 모델들은 billion 단위의 파라미터 수를 가지기 때문에 이는 매우 비효율적이다.</p>

\[\max_{\Theta}\sum_{(x, y)\in\mathbf{Z}}\sum^{|y|}_{t=1}\log(P_{\Phi_0+\Delta\Phi(\Theta)}(y_t|x, y_{&lt;t}))\]

<p>본 논문에서는 \(\Phi\) 대신 \(\Theta\)라는 원본 모델의 파라미터 수보다 훨씬 적은 수의 가중치를 학습해 연산량과 메모리 효율성을 높이는 방법을 제안한다.</p>

<h2 id="our-method">OUR METHOD</h2>

\[W_0+\Delta W=W_0+BA\]

<h3 id="low-rank-parameterized-update-matrices">LOW-RANK-PARAMETERIZED UPDATE MATRICES</h3>

<p>기존의 가중치 행렬 \(W_0\)을 업데이트할 때 우리는 \(\Delta W\)를 더하는 방식으로 생각할 수 있는데 이때 \(\Delta W=BA\)와 같이 분해한다. 예를 들어 \(W_0\)가 100 by 100 행렬이라고 해보자. 그러면 \(W_0\)는 10000개의 원소를 가지고 있고 \(\Delta W\)를 구할 때에도 10000개의 원소를 학습해야 한다. 이때 우리가 \(B\)가 100 by 1, \(A\)가 1 by 100으로 두고 \(B, A\)를 학습시킨다면 각각 100개씩 총 200개의 원소만 학습을 해도 \(BA\)는 100 by 100이 되어 가중치를 업데이트할 수 있다. 이때 \(B\)는 0행렬로, \(A\)는 가우시안 분포를 따르게 해 초기 \(BA\)가 0행렬이 되게 만들어 초기값에서도 baseline 모델의 성능을 그대로 보존한 상태에서 출발할 수 있도록 한다.</p>

<p>이러한 접근은 특정 task에 맞게 모델을 튜닝하기 위해서는 intrinsic dimension에 해당하는 부분만 건드려도 충분하다는 직관에서 나온다. 즉 수십억개 이상의 파라미터 중 특정 파라미터 몇 개(low intrinsic dimension)만 조정해도 전체 파라미터를 업데이트 하는 것과 동일한 성능이 나온다는 것이다.</p>

<p>LoRA에서는 \(r &lt;\min(d, k)\)로 설정한다. 즉 원래 파라미터보다 작은 rank를 사용해 학습해야 하는 파라미터 수를 줄여 계산상의 이점을 취한다. 하지만, 이때 \(r=\min(d, k)\)이라면 이는 원본 가중치 행렬과 같은 rank의 행렬을 학습시키는 것과 같고 사실상 기존 파인튜닝과 동일하다. 따라서 LoRA는 full fine-tuning의 일반화된 버전이라고 할 수 있다. LoRA는 기존 가중치 행렬에 학습된 행렬 \(BA\)를 선형 결합하기 때문에 연산 속도에 거의 차이가 없다. 또한 여러 가지 task에 대해서 LoRA 파인튜닝 가중치를 변경하는 것이 자유롭기도 하다. 이는 추가 학습 레이어를 붙이는 등의 접근과 달리 연산량과 편의성 모두에서 이점이 있다.</p>

<h3 id="applying-lora-to-transformers">APPLYING LoRA TO TRANSFORMERS</h3>

<p>LoRA를 트랜스포머에 적용할 때 어텐션 레이어의 가중치 \((W_q, W_k, W_v, W_o)\)에만 적용하도록 했다. LoRA를 적용했을 때 필요한 VRAM 용량이 감소했고, model checkpoint가 35MB로 감소했으며(low-rank 행렬만 저장하면 되기 때문에 기존 350GB에서 큰 감소) full-tuning과 비교해서 학습 속도도 25%나 빨라졌다. 그럼에도 LoRA는 서비스 측면에서 봤을 때에는 \(B_1A_1\) 가중치가 필요한 질문과 \(B_2A_2\) 가중치가 필요한 질문이 들어왔을 때 두 가지 입력을 동시에 처리할 수는 없다는 문제점을 가지기는 한다.</p>

<h2 id="understanding-the-low-rank-updates">UNDERSTANDING THE LOW-RANK UPDATES</h2>

<p>다른 추가 학습 기법과 비교해서 LoRA는 좋은 성능을 보이는 것을 실험을 통해 확인할 수 있었다. 그렇다면, 트랜스포머를 사용하는 모델에서, 어느 가중치에 LoRA를 적용해야 할까? LoRA에서 “rank”를 얼마로 설정해야 할까? \(\Delta W\)와 \(W\)는 얼마나 큰 연관성과 차이를 가질까?</p>

<h3 id="which-weight-matrices-in-transformers-should-we-apply-lora-to">WHICH WEIGHT MATRICES IN TRANSFORMERS SHOULD WE APPLY LoRA TO</h3>

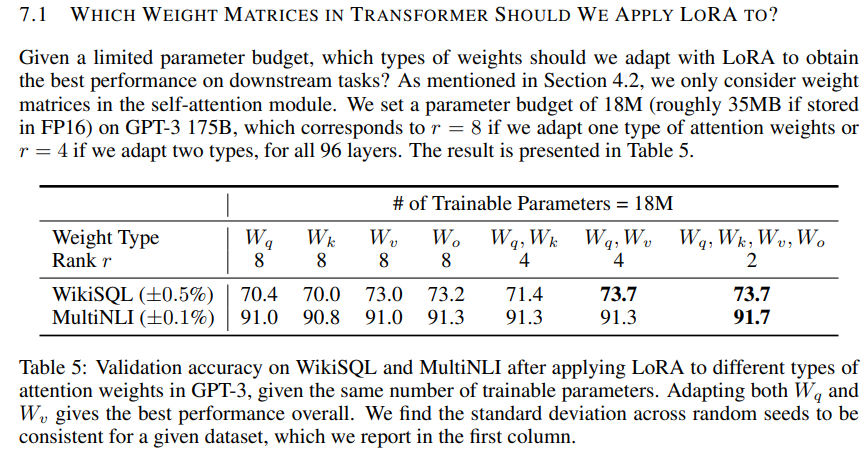
<p><img src="/assets/images/lora-low-rank-adaptation-of-large-language-models/image-2.png" alt="Table 5" /></p>

<p>Table 5를 보면 학습 파라미터 수를 고정한 상태에서 rank와 LoRA를 적용하는 가중치 종류(\(W_q, W_k, W_v, W_o\)) 조합을 변경해가며 실험했을 때 하나의 가중치에 큰 \(r\)을 몰아주는 것보다 여러 종류의 가중치에 낮은 \(r\)을 나누어 적용하는 것이 더 좋은 성능을 보였다. 따라서 큰 rank로 가중치 하나만 학습하는 것보다 낮은 rank로 여러 종류의 가중치를 함께 학습하는 것이 효과적이다.</p>

<h3 id="what-is-the-optimal-rank-r-for-lora">WHAT IS THE OPTIMAL RANK \(r\) FOR LoRA</h3>

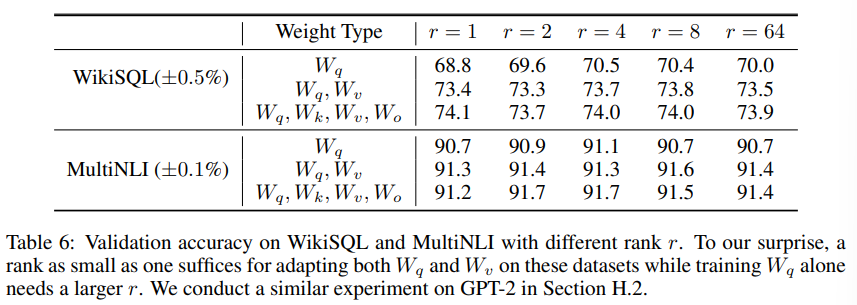
<p><img src="/assets/images/lora-low-rank-adaptation-of-large-language-models/image-3.png" alt="Optimal rank analysis" /></p>

<p>rank를 변경하며 실험했을 때 작은 r에서도 충분한 학습 성능을 보였다. 이는 \(\Delta W\)가 아주 작은 intrinsic rank를 가지고 있음을 보이며 유의미한 subspace를 구성하기 위해서 큰 rank가 필요하지 않음을 보인다.</p>]]></content><author><name>Jaewon Seo</name></author><category term="paper-review" /><category term="optimization" /><category term="fine-tuning" /><summary type="html"><![CDATA[Edward Hu et al., ICLR 2022]]></summary></entry><entry><title type="html">Adam: A Method for Stochastic Optimization</title><link href="https://ddungjae.github.io/posts/adam-stochastic-optimization/" rel="alternate" type="text/html" title="Adam: A Method for Stochastic Optimization" /><published>2026-09-19T00:00:00+09:00</published><updated>2026-09-19T00:00:00+09:00</updated><id>https://ddungjae.github.io/posts/adam-stochastic-optimization</id><content type="html" xml:base="https://ddungjae.github.io/posts/adam-stochastic-optimization/"><![CDATA[<p><a href="https://arxiv.org/pdf/1412.6980">https://arxiv.org/pdf/1412.6980</a></p>

<h2 id="introduction">INTRODUCTION</h2>

<p>머신러닝 등에서 손실함수를 최적화 할 때에는 gradient descent를 주로 사용하는데 이 중 널리 쓰이는 방법이 stochastic gradient descent (SGD)이다. SGD는 전체 data point가 아니라 subsample에 대해서 gradient descent를 수행해 연산량, 수렴성 등에서 이점이 있었다. 이때 subsampling, dropout을 통해 목적함수에 노이즈가 생길 수 있으며 파라미터 수가 많은 고차원 공간에서 일차 미분만을 효율적으로 다루는 알고리즘이 필요하다. 본 논문에서는 Adam이라는 최적화 방법을 제안한다. Adam은 1, 2차 모멘텀을 활용해 learning rate를 능동적으로 조절하는 알고리즘을 제안한다.</p>

<h2 id="algorithm">ALGORITHM</h2>

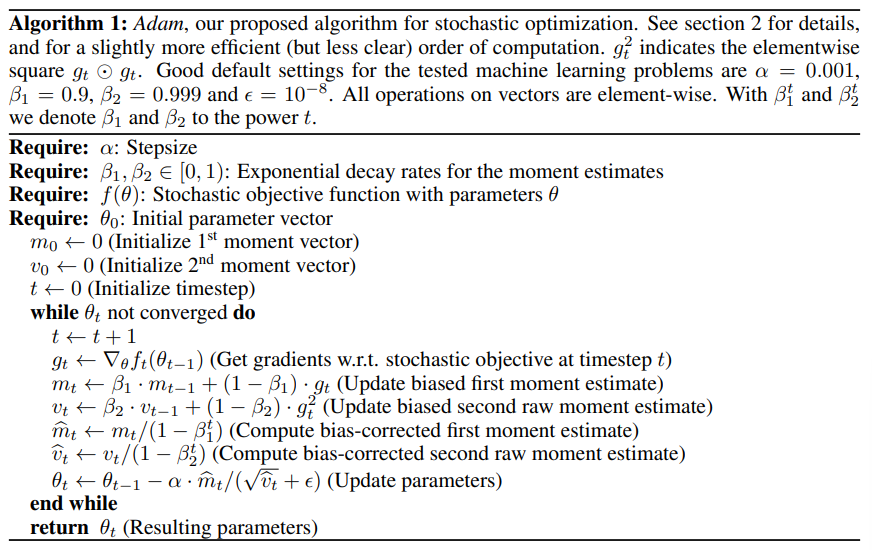
<p><img src="/assets/images/adam-stochastic-optimization/algorithm.png" alt="Adam algorithm pseudocode" /></p>

<p>Adam의 알고리즘을 따라가보자. \(f(\theta)\)는 노이즈를 포함하는 목적함수이고 이 목적함수의 기댓값 \(\mathbb{E}[f(\theta)]\)을 최소화하는 파라미터 \(\theta\)를 찾기를 원한다. 우리는 \(f_1(\theta), \dots, f_T(\theta)\)의 각 스텝마다의 목적함수에서 sampling이나 함수 자체의 원인으로 인해 노이즈가 발생할 수 있음을 알고 각 시점에서의 sampling (minibatch)을 사용해 \(g_t=\nabla_\theta f_t(\theta)\) 그래디언트를 계산할 것이다. Adam은 각 시점의 그래디언트를 독립적으로 사용하지 않고 이전 시점 그래디언트의 1, 2차 이동 평균을 반영한다.</p>

<ul>
  <li>
\[m_t=\beta_1m_{t-1}+(1-\beta_1)g_t,\quad \hat{m}_t=m_t/(1-\beta_1^t)\]
  </li>
  <li>
\[v_t=\beta_2v_{t-1}+(1-\beta_2)g_t^2,\quad \hat{v}_t=v_t/(1-\beta_2^t)\]
  </li>
  <li>
\[\theta_t=\theta_{t-1}-\alpha\,\hat{m}_t/(\sqrt{\hat{v}_t}+\epsilon)\]
  </li>
</ul>

<p>위 식을 합의 형태로 쓰면 다음과 같이 나타난다.</p>

<ul>
  <li>
\[m_t=(1-\beta_1)\sum^t_{i=1}\beta_1^{t-i}g_i\]
  </li>
  <li>
\[v_t=(1-\beta_2)\sum^t_{i=1}\beta_2^{t-i}g_i^2\]
  </li>
</ul>

<p>합의 형태로 보면 \(t\)에서 가까운 시점에서 계산된 그래디언트가 큰 비중을 차지하고 멀어질수록 그 비중이 지수적으로 감쇠한다. 그러나 여전히 이전 스텝에서의 그래디언트의 영향이 남아 있음을 볼 수 있다. \(\theta\)를 업데이트하는 수식을 보면 \(m_t\)는 그래디언트 자체의 지수 이동평균이므로 방향을 나타내고 \(v_t\)는 제곱의 지수 이동평균이므로 스케일을 나타냄을 알 수 있다. \(m_t\)는 그래디언트가 스텝마다 일관된 방향일 때 그 방향으로 파라미터를 업데이트 하게 해준다. \(v_t\)는 그래디언트의 스케일을 보정해 학습률을 조정하게 해준다. 따라서 Adam은 분자(방향)와 분모(크기) 모두 같은 그래디언트 스케일로 만들어지므로, 스케일이 서로 다른 함수들에 대해서도 learning rate 재튜닝 없이 일관된 학습을 보장한다.</p>

<h2 id="initialization-bias-correction">INITIALIZATION BIAS CORRECTION</h2>

<ul>
  <li>
\[m_t=(1-\beta_1)\sum^t_{i=1}\beta_1^{t-i}g_i\]
  </li>
  <li>
\[v_t=(1-\beta_2)\sum^t_{i=1}\beta_2^{t-i}g_i^2\]
  </li>
</ul>

<p>Adam에서는 위의 식을 통해 그래디언트의 1, 2차 모멘텀의 기댓값을 추정하기를 원한다. \(\mathbb{E}[m_t], \mathbb{E}[v_t]\)를 계산할 때 \(\mathbb{E}[g_i]\approx\mathbb{E}[g_t]\)을 가정하면 다음과 같이 표현된다.</p>

\[\begin{aligned}
\mathbb{E}[m_t] &amp;= (1-\beta_1)\sum^t_{i=1}\beta_1^{t-i}\,\mathbb{E}[g_i] = (1-\beta_1^t)\,\mathbb{E}[g_t]+\zeta \\
\mathbb{E}[v_t] &amp;= (1-\beta_2)\sum^t_{i=1}\beta_2^{t-i}\,\mathbb{E}[g_i^2] = (1-\beta_2^t)\,\mathbb{E}[g_t^2]+\zeta
\end{aligned}\]

<p>\(\beta_1, \beta_2\)를 0.9, 0.999으로 설정하면 \(t\)가 작을 때 \((1-\beta_1^t), (1-\beta_2^t)\)는 0에 가깝기 때문에 초기 그래디언트가 과소 추정되는 문제가 발생한다. 이를 보정하기 위해 \(\hat{m}_t=m_t/(1-\beta_1^t), \hat{v}_t=v_t/(1-\beta_2^t)\)로 사용한다.</p>

<h2 id="related-work">RELATED WORK</h2>

<p>Adam은 RMSProp과 AdaGrad와 연관성을 가진다.</p>

<ul>
  <li>AdaGrad: \(\theta_{t+1}=\theta_t-\alpha g_t/\sqrt{\sum^t_{i=1}g_i^2}\)와 같이 학습률을 조정하는 방식을 사용한다. 이는 Adam에서 \(\beta_1=0, \beta_2\approx1\)인 설정과 같다. 하지만 학습 후반부에는 스텝이 커져 분모가 증가해 학습률이 거의 0이 되는 문제가 발생한다.</li>
  <li>RMSProp: AdaGrad의 학습률 소멸 문제를 해결하기 위해 Adam과 같이 \(v_t=\beta_2v_{t-1}+(1-\beta_2)g_t^2\)와 같은 지수 이동평균을 사용한다. 하지만 1차 모멘텀과 편향 보정은 사용하지 않았다.</li>
</ul>

<p>Adam은 AdaGrad의 파라미터별 학습률 적응 아이디어와 RMSProp의 지수 이동 평균을 통한 학습률 소멸 방지, 1차 모멘텀 적용, bias correction을 하나로 통합한 알고리즘이라고 볼 수 있다.</p>

<h2 id="extensions">EXTENSIONS</h2>

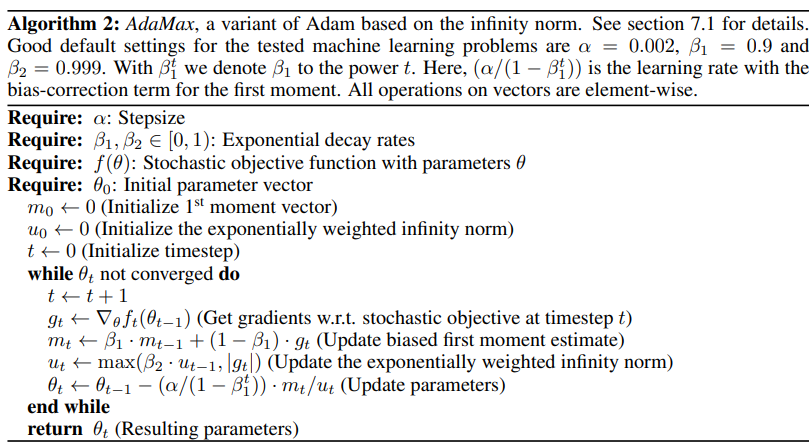
<p><img src="/assets/images/adam-stochastic-optimization/adamax-algorithm.png" alt="AdaMax algorithm pseudocode" /></p>

<p>본 논문에서는 추가적으로 AdaMax라는 방법도 제시한다. Adam과 다른 부분은 \(u_t\)인데 \(u_t=\max(\beta_2u_{t-1}, \lvert g_t\rvert)\)를 사용한다. 이는 기존의 \(v_t\)에서 그래디언트의 제곱의 이동평균을 사용한 것과 달리 일반화된 \(L^p\) norm을 적용한다.</p>

\[v_t=\beta_2^p v_{t-1}+(1-\beta_2^p)\lvert g_t\rvert^p=(1-\beta_2^p)\sum^t_{i=1}\beta_2^{p(t-i)}\lvert g_i\rvert^p\]

\[\begin{aligned}
u_t &amp;= \lim_{p\rightarrow\infty}(v_t)^{1/p} \\
&amp;= \lim_{p\rightarrow\infty}(1-\beta_2^p)^{1/p}\left(\sum^t_{i=1}\beta_2^{p(t-i)}\lvert g_i\rvert^p\right)^{1/p} \\
&amp;= \lim_{p\rightarrow\infty}\left(\sum^t_{i=1}\beta_2^{p(t-i)}\lvert g_i\rvert^p\right)^{1/p} \\
&amp;= \max\!\left(\beta_2^{t-1}\lvert g_1\rvert,\ \beta_2^{t-2}\lvert g_2\rvert,\ \dots,\ \beta_2\lvert g_{t-1}\rvert,\ \lvert g_t\rvert\right) \\
&amp;= \max(\beta_2 u_{t-1}, \lvert g_t\rvert)
\end{aligned}\]

<p>이와 같은 형태는 이전에 Adam에서 요구했던 bias correction이 필요하지 않으며, \(u_t \ge \beta_2 u_{t-1}\)이 항상 성립하기 때문에 그래디언트가 갑자기 작아지더라도 \(u_t\)가 \(\beta_2\) 배율보다 빠르게 줄어들지 않는다는 성질을 제공한다.</p>

<h2 id="conclusion">CONCLUSION</h2>

<p>Adam은 RMSProp와 AdaGrad의 장점을 혼합해 효율적인 SGD를 수행할 수 있도록 했다. Adam은 1차 모멘텀으로 파라미터 업데이트 방향의 일관성을 제공하고 2차 모멘텀으로 학습 스케일을 동적으로 조정한다. 이는 계산량이 적고 메모리도 효율적이며 다양한 최적화 문제에서 모두 좋은 성능을 보인다.</p>

<h2 id="느낀점">느낀점</h2>

<p>SGD나 Adam 모두 기본적인 gradient descent에서 연산량 감소, 수렴성을 위한 다양한 시도의 결과물이라고 생각이 든다. 직관적으로 생각해 볼때 Adam은 학습 초반에는 adaptive learning rate로 빠른 수렴이 가능하게 하지만 학습 후반 단계에서 급격한 그래디언트의 변화가 발생하는 경우 수렴 구간을 벗어날 수도 있을 것 같다. 이와 같은 관점에서 볼 때 learning rate scheduling과 같이 optimizer scheduling도 적용해 학습 초반과 후반에서의 최적 optimizer 조합을 찾아볼수도 있을 것 같다. 특히 학습 후반에는 어느 정도 수렴이 일어난 상태에서 해당 파라미터의 neighborhood에서 최적점을 찾아야 하는데 neighborhood 안에서의 최적점을 찾는 방법에 대해서도 생각해보면 좋을 것 같다.</p>]]></content><author><name>Jaewon Seo</name></author><category term="paper-review" /><category term="optimization" /><summary type="html"><![CDATA[Diederik P. Kingma et al., ICLR 2015]]></summary></entry><entry><title type="html">Attention Is All You Need</title><link href="https://ddungjae.github.io/posts/attention-is-all-you-need/" rel="alternate" type="text/html" title="Attention Is All You Need" /><published>2026-09-15T00:00:00+09:00</published><updated>2026-09-15T00:00:00+09:00</updated><id>https://ddungjae.github.io/posts/attention-is-all-you-need</id><content type="html" xml:base="https://ddungjae.github.io/posts/attention-is-all-you-need/"><![CDATA[<p><a href="https://arxiv.org/pdf/1706.03762">https://arxiv.org/pdf/1706.03762</a></p>

<p>이 논문은 너무 유명해서 여러 매체에서 “세상을 바꾼 논문”이라고 표현한다. 기억상으로 ChatGPT를 처음 접한게 2023년이고 현재 GPT-6 Astra가 또 엄청난 성능으로 주목을 받고 있는데 이 모든 것의 시초가 되는 논문이 바로 “Attention Is All You Need”이다. 논문 제목과 명성은 알고 있었지만 읽어보는 것은 처음인데 다른 논문을 읽을 때와는 살짝 다른 마음가짐으로 읽어봐야겠다.</p>

<h2 id="introduction">Introduction</h2>

<p>기존까지는 RNN, LSTM, Gated-RNN과 같은 모델이 번역과 같은 시퀀스 모델링에서 가장 좋은 성능을 보였다. 이후에도 recurrent language model(순환 언어 모델)과, 인코더-디코더 구조를 개선하려는 노력이 있었다.</p>

<p>순환 모델은 hidden state \(h_t\)를 \(h_{t-1}\)과 \(t\)번째 입력으로 만들어낸다. 이러한 구조의 단점은 \(h_1, \dots , h_n\)을 생성하는 과정이 순차적이며 병렬화할 수 없다는 점이다. 최근 이러한 문제를 해결하기 위해 factorization이나 conditional computation 등의 방법을 사용했지만 근본적인 “순차적”이라는 문제는 해결할 수 없었다. 어텐션 매커니즘은 시퀀스 모델링에서 입력, 출력 시퀀스의 거리에 관계 없이 의존 관계를 모델링할 수 있게 해주었다. 하지만 어텐션 매커니즘은 여전히 순환 신경망과 같이 사용되었다. 이에 본 연구에서 제안하는 Transformer는 입력, 출력 의존 관계를 어텐션 매커니즘에만 의존하도록 한다.</p>

<p>다음으로 넘어가기 전에 RNN의 구조를 조금 살펴보자.</p>

<p>“The capital city of Korea is” 우리는 이 문장이 입력으로 들어왔을 때 “Seoul”이라는 단어가 출력 되게 하고 싶다. 위 문장은 총 6개의 토큰으로 구성이 되어 있고 우리는 이를 벡터로 임베딩한다.</p>

\[\text{[The, capital, city, of, Korea, is]} \rightarrow [x_1, x_2, x_3, x_4, x_5, x_6] \text{ where }x_t=E[\text{token}_t]\]

<p>이후 우리는 토큰을 순차적으로 입력으로 넣어 hidden state을 생성한다.</p>

\[h_t=\text{tanh}(W_x x_t+W_h\,h_{t-1}+b_h)\]

<p>\(t\)번째 hidden state에는 \(t\)번째 토큰과, \((t-1)\)번째 state인 \(h_{t-1}\)이 사용이 되며 \(h_{t-1}\)은 \((t-1)\)번째 토큰의 정보까지 포함하기 때문에 문맥을 반영할 수 있다. 이제 \(h_6\)을 사용해서 7번째로 등장할 단어인 “Seoul”을 출력해야 한다. 이때 출력층은 \(\hat{y}_t=f(W_y\,h_t+b_y)\)의 형태로 나와 우리는 다음 단어를 예측할 수 있게 된다.</p>

<p>이러한 유형에서 우리가 “Seoul”이라는 단어를 출력하기 위해 가장 유심히 보아야 하는 단어는 “Korea”일 것이다. 하지만 위와 같은 짧은 예시의 문장이 아니라 긴 문장에서는 \(h_i\)를 거치면서 “Korea”와 “Seoul”의 거리가 멀다면 그 관계가 희석될 수 있다. 또한, \(h_i\)를 계산하기 위해서는 반드시 \(h_{i-1}\)이 필요하다는 점에서 병렬 계산이 어렵다는 문제를 확인할 수 있다.</p>

<h2 id="background">Background</h2>

<p>순차적 계산을 줄이기 위해서 모든 입력/출력 위치에 대해 병렬 연산을 수행하려는 시도(ByteNet, ConvS2S)가 있었으나 단어 사이의 거리가 멀수록 연산량이 증가해 학습하기가 여전히 까다로웠다. 트랜스포머는 이를 상수번의 연산으로 고정하는 방식으로 해결할 수 있었다.</p>

<h2 id="model-architecture">Model Architecture</h2>

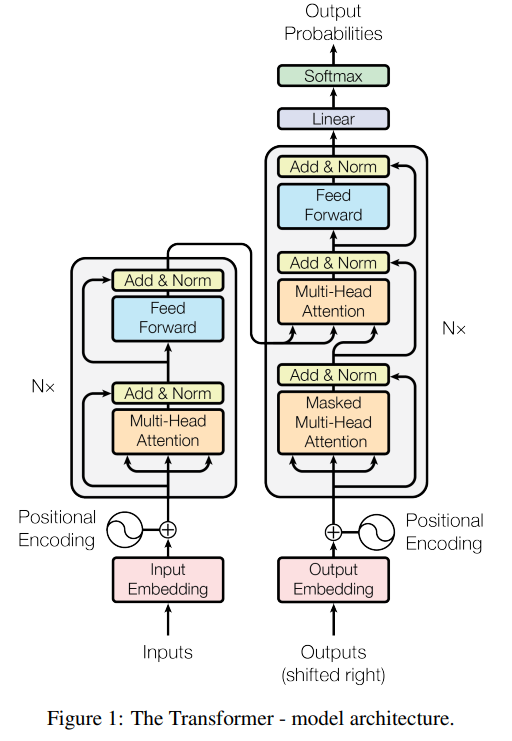
<p><img src="/assets/images/attention-is-all-you-need/transformer-architecture.png" alt="Transformer model architecture" /></p>

<p>트랜스포머는 위와 같은 인코더-디코더 구조를 가진다. 인코더에서는 입력 문자열을 \(\mathbf{z}\)라는 연속적인 표현으로 변환하고 디코더는 \(\mathbf{z}\)와 shifted right outputs (이전 단계까지 생성된 문자열)을 가지고 다음 출력을 순차적으로 생성한다. 인코더와 디코더에 대해 알아보기 전에 인코더와 디코더를 구성하는 요소들을 먼저 살펴보자.</p>

<h3 id="attention">Attention</h3>

<p>Attention은 RNN의 한계를 개선하기 위해 등장한 개념으로 다음 출력을 예측하기 위해서 중요한 토큰에 높은 가중치를 부여한다. “The capital city of Korea is”라는 입력에 “Seoul”을 출력하려면 “Korea”가 중요할 것이고 여기에 가중치를 더 부여하는 것이다.</p>

\[e_{t, i}=\text{score}(s_t, h_i)\]

<p>여기서 \(e_{t, i}\)가 \(t\)번째 출력 위치와 \(i\)번째 입력 위치의 관련도 점수라고 하면 이는 \(s_t\)라는 디코더의 현재 상태와 \(h_i\)라는 인코더 상태로 표현이 된다. 이후 소프트맥스를 통해 \(t\)번째 출력을 위해 몇 번째 토큰이 중요한지를 수치화 한 후 context vector를 다음과 같이 생성한다.</p>

\[c_t=\sum_i a_{t, i}\,h_i\text{ where }a_{t, i}=\frac{\text{exp}(e_{t, i})}{\sum_j \text{exp}(e_{t, j})}\]

<p>이제 \(c_t\)는 토큰의 중요도를 반영하는 벡터가 되었고 디코더에서는 \(c_t, s_t\)를 사용해서 출력 토큰을 예측한다.</p>

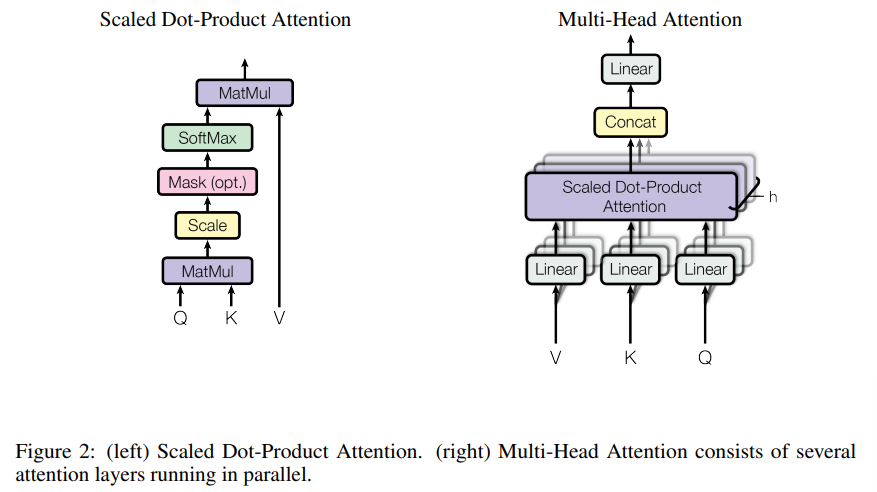
<p><img src="/assets/images/attention-is-all-you-need/attention-diagram.png" alt="Attention mechanism diagram" /></p>

<h3 id="scaled-dot-product-attention">Scaled Dot-Product Attention</h3>

<p>그렇다면, \(e_{t, i}=\text{score}(s_t, h_i)\)에서 관련성을 나타내는 \(\text{score}\)을 정의해야 한다. 본 논문에서 제안하는 scaled dot-product attention에서는 다음과 같은 구조를 사용한다.</p>

\[\text{Attention}(Q, K, V)=\text{softmax}\!\left(\frac{QK^T}{\sqrt{d_k}}\right)V\]

<p>\(Q,K, V\)는 각각 입력 벡터에 가중치 \(W^Q, W^K, W^V\)를 곱해서 만들어진다. 비유하자면 다음과 같이 표현할 수 있다.</p>

<ul>
  <li>\(Q\): Query (다른 단어와의 관계를 표현하는 정도를 계산할 때 사용)</li>
  <li>\(K\): Key (쿼리와의 비교를 통해 다른 단어가 현재 단어를 판별하는 기준이 되는 벡터)</li>
  <li>\(V\): Value (query, key의 관계성에 따라 최종 출력을 만들기 위해 사용)</li>
</ul>

<p>즉 dot product인 \(QK^T\)는 두 단어의 유사도(관련도)를 제공하고, 이 값에 softmax를 취해 확률 분포로 변환 후 value를 곱해주는 형태이다. 여기서 \(\sqrt{d_k}\)로 나눠주는 이유는 내적으로 인해 특정 값이 너무 커지게 되면 소프트맥스를 취했을 때 특정 값에 확률이 쏠리게 되는데 이를 방지하기 위해 분산을 1로 맞추고자 \(\sqrt{d_k}\)로 스케일링을 해준다.</p>

<h3 id="multi-head-attention">Multi-Head Attention</h3>

\[\begin{aligned}
\text{MultiHead}(Q, K, V) &amp;= \text{Concat}(\text{head}_1, \dots, \text{head}_h)\,W^O \\
\text{where } \text{head}_i &amp;= \text{Attention}(QW_i^Q, KW_i^K, VW_i^V)
\end{aligned}\]

<p>어텐션 매커니즘은 단어 간의 관계를 수치화 하지만 어텐션을 한 번만 수행하게 된다면 단어 간의 다양한 관계가 소프트맥스를 취하며 소실될 수 있다. 위와 같은 multi-head attention은 기존에 512차원 임베딩 내에서 수행하던 attention을 64차원 8개로 나누어 수행한 후 결과를 합쳐 다시 512차원으로 만든다. 8개의 sub-attention을 수행하며 문장 내에서 단어간의 관계를 더 풍부하게 학습할 수 있다.</p>

<h3 id="position-wise-feed-forward-networks">Position-wise Feed-Forward Networks</h3>

\[\text{FFN}(x)=\max(0, xW_1+b_1)W_2+b_2\]

<p>Figure 2를 보면 multi-head attention 레이어를 통과한 후에는 feed forward network로 간다. Feed forward network에서는 선형 변환 후 ReLU 활성화 함수를 거쳐 두 번째의 선형 변환이 일어난다. 어텐션 매커니즘에서 토큰간의 문맥적 의미를 학습한 후 FFN에서 이를 비선형 활성화 함수로 융합해 단어 간의 상호 작용을 모델링하게 된다.</p>

<h3 id="positional-encoding">Positional Encoding</h3>

\[\begin{aligned}
PE_{(pos,\,2i)} &amp;= \sin\!\left(\dfrac{pos}{10000^{2i/d_{\text{model}}}}\right) \\
PE_{(pos,\,2i+1)} &amp;= \cos\!\left(\dfrac{pos}{10000^{2i/d_{\text{model}}}}\right)
\end{aligned}\]

<p>입력 토큰의 시퀀스 내부에서의 순서 정보를 제공하기 위해 positional encoding을 사용한다. Positional encoding을 위해 각 토큰마다 토큰의 순서에 따라서 순차적으로 값을 부여할수도 있지만(1, 2, 3, …) 이렇게 된다면 시퀀스가 길어질수록 위치 정보가 큰 값이 부여됨에 따라 원래 토큰의 임베딩 값을 약화시킬 수 있다. 또한 시퀀스 길이가 달라질 때에도 같은 위치의 토큰에는 같은 위치 정보가 부여되어야(10토큰 중 5번째와 100토큰 중 5번째가 같은 값을 가져야 함) 한다. 이러한 특성을 충족하기 위해 positional encoding에서는 삼각함수를 사용한다. 삼각함수는 -1~1의 값을 가지기 때문에 토큰 임베딩에 영향을 주지 않는 선에서 위치 정보를 추가할 수 있게 해준다. 또한 임베딩에서 각 차원마다 다른 주기의 삼각함수가 더해지는데 이는 서로 겹치지 않게 위치 정보를 추가할 수 있게 해준다.</p>

<h2 id="why-self-attention">Why Self-Attention</h2>

<p>Self-attention은 다음과 같은 장점을 가진다.</p>

<ul>
  <li>레이어당 연산 복잡도 감소</li>
  <li>병렬화될 수 있는 연산량 증가</li>
  <li>장기 의존성 사이의 경로 길이 감소</li>
</ul>

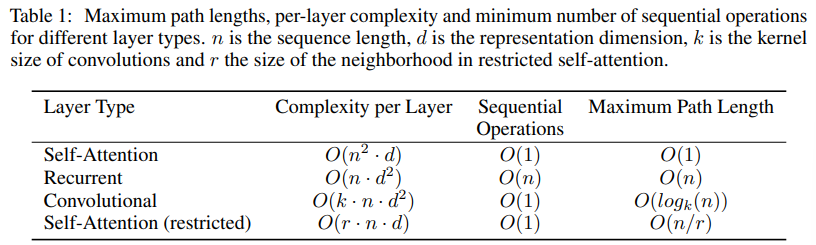
<p><img src="/assets/images/attention-is-all-you-need/complexity-table.png" alt="Complexity comparison table" /></p>

<p>우선 기존의 RNN과 같은 sequential model은 \(n\)번째 토큰을 계산하려면 이전 \((n-1)\)번째 토큰까지의 계산 결과가 모두 필요하기에 \(O(n)\)의 시간복잡도를 가지지만 self-attention은 이것을 query-key-value 연산으로 한번에 처리하기 때문에 \(O(1)\)의 시간복잡도를 가진다. 마찬가지로 maximum path length에서도 self-attention에서는 한 번의 내적 연산으로 이를 계산하기 때문에 연산 시간복잡도에서 이점을 가진다. 총 시간복잡도는 \(O(n^2d) \text{ vs }O(nd^2)\)인데 일반적으로 512차원 임베딩을 하게 되면 입력 시퀀스는 512보다 작은 토큰 수가 들어오기 때문에 시간복잡도에서도 이점을 가진다. 물론 최근에는 입력 시퀀스가 증가함에 따라서 연산량이 폭발하기도 하는데 이는 local attention 방식으로 해결할 수 있다는 것을 향후 과제로 제시하였다.</p>

<h2 id="training--results">Training &amp; Results</h2>

<p><img src="/assets/images/attention-is-all-you-need/translation-results.png" alt="Machine translation results (BLEU scores and training cost)" /></p>

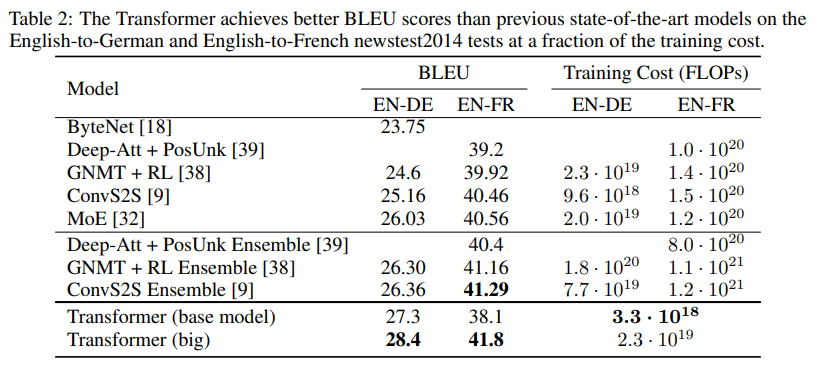
<p>Transformer의 학습은 WMT 2014 English-German dataset과 8 NVIDIA P100 GPU, Adam optimizer이 사용되었고 기존의 기계 번역 모델인 ByteNet, ConvS2S 등을 적은 훈련 비용으로도 능가하는 성능을 보여주었다.</p>

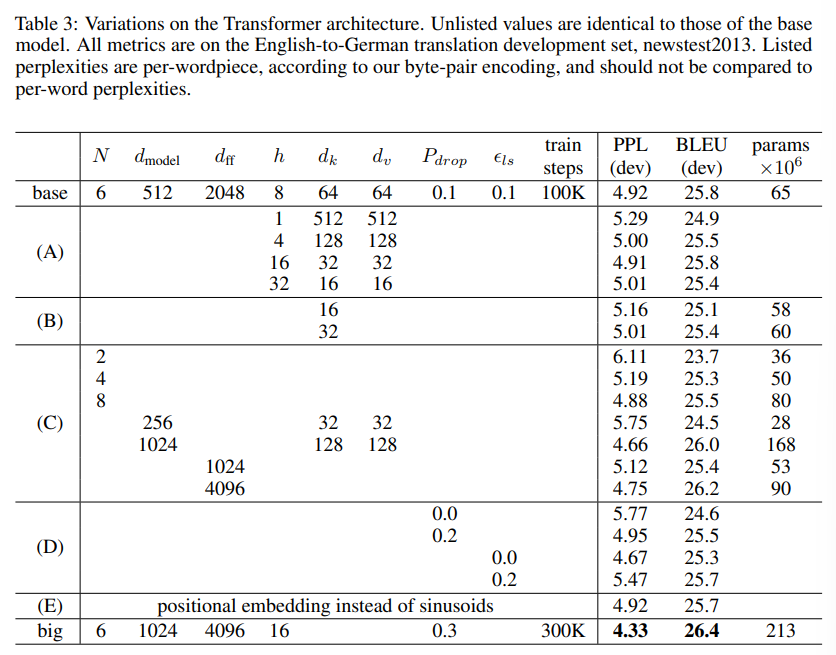
<p><img src="/assets/images/attention-is-all-you-need/model-variations.png" alt="Model variations (Table 3)" /></p>

<p>Table 3을 보면 임베딩 차원, attention layer 수, head 수와 같이 모델 아키텍처를 변경하며 실험한 결과 head 수가 너무 많거나 적으면 BLEU 점수가 떨어졌고 \(h=8\)이 가장 이상적임을 보였다. 또한, \(d_k\)가 축소 되면 모델 품질이 저하 되어 64보다 작아지면 성능이 떨어졌다. 이후 \(N, d_{\text{model}}, d_{\text{ff}}, h\)를 모두 증가한 big model에서 모델 성능이 일관되게 향상되었으며 이는 scaling law의 가능성을 보여준다.</p>

<h2 id="느낀점">느낀점</h2>

<p>트랜스포머의 구조를 완전히 이해하지는 못한 것 같지만 왜 query, key, value를 사용하는 방식이 토큰 간의 관계성을 적은 연산 시간 안에 빠르게 계산할 수 있게 되는지를 알 수 있었고 기존 sequence 기반 모델의 한계를 대부분 개선한 것처럼 보인다. 하지만 아직 multi-head attention에서 저차원에서 수행한 attention을 concat하는 것 만으로 추가적인 의미, 문맥 정보를 반영한다는 효과에 대해서는 의문이 남는다. 단순히 concat하는 것이 아닌 이때 각 attention 결과 사이에도 추가적인 연관성을 추가할 수 있을 것 같다. 또한 positional encoding에서 위치 정보를 나타내는 벡터를 임베딩 벡터에 더해주는 것 만으로 위치 정보가 충분히 반영이 된다는 것이 신기하다. 여기에서도 단순 선형 결합이 아니라 가중합 등의 방식을 사용할 수 있을 것 같은데 이 부분에 대해서 더 알아보고 싶다.</p>]]></content><author><name>Jaewon Seo</name></author><category term="paper-review" /><category term="llm" /><category term="NLP" /><summary type="html"><![CDATA[Ashish Vaswani et al., NIPS 2017]]></summary></entry><entry><title type="html">Finetuned Language Models Are Zero-Shot Learners</title><link href="https://ddungjae.github.io/posts/flan-instruction-tuning/" rel="alternate" type="text/html" title="Finetuned Language Models Are Zero-Shot Learners" /><published>2026-09-10T00:00:00+09:00</published><updated>2026-09-10T00:00:00+09:00</updated><id>https://ddungjae.github.io/posts/flan-instruction-tuning</id><content type="html" xml:base="https://ddungjae.github.io/posts/flan-instruction-tuning/"><![CDATA[<p><a href="https://arxiv.org/pdf/2109.01652">https://arxiv.org/pdf/2109.01652</a></p>

<h2 id="introduction">INTRODUCTION</h2>

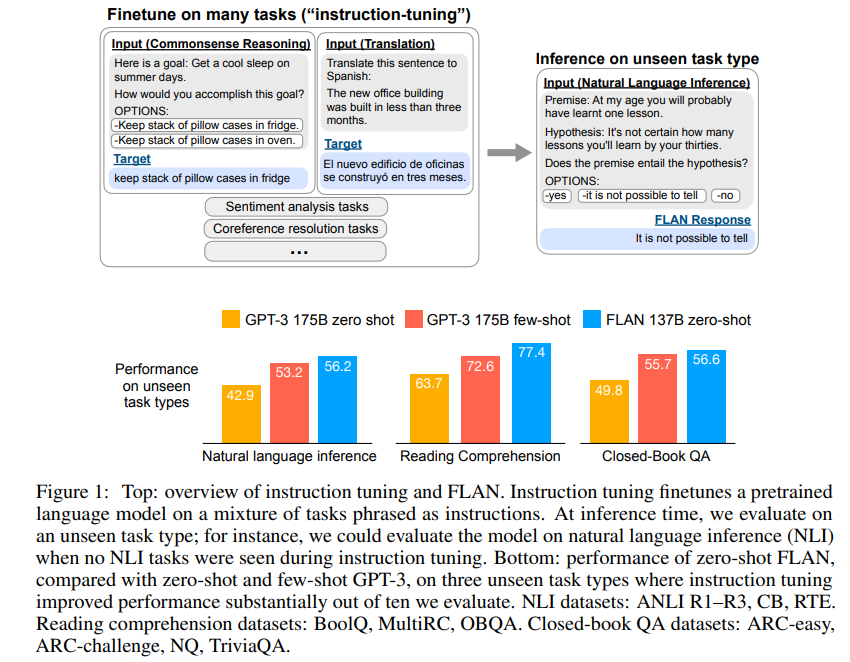
<p><img src="/assets/images/flan-instruction-tuning/fig1-flan-vs-gpt3.png" alt="Figure 1: FLAN zero-shot vs. GPT-3 zero-shot and few-shot" /></p>

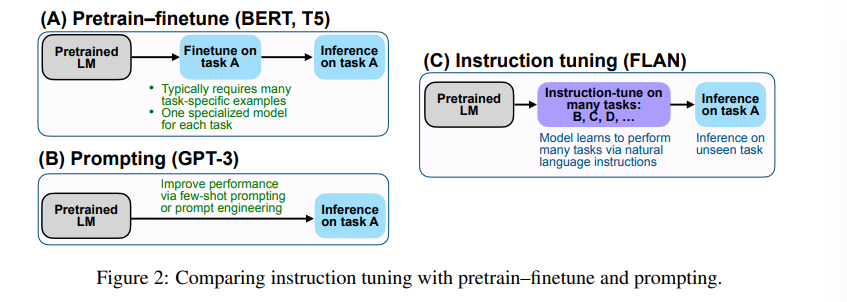
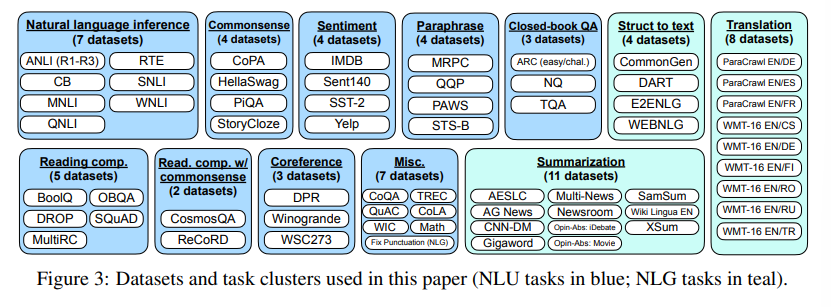
<p>GPT-3과 같은 언어 모델은 few-shot learning(모델 프롬프트에 입력-정답 예시를 몇 개 보여주고 문제를 푸는 것)에서 좋은 성능을 내는 것을 보였다. 하지만 zero-shot에서는 few-shot보다 많이 떨어지는 성능을 보였다. 이러한 원인으로 few-shot learning에서 제공하는 예시 프롬프트가 없으면, 모델이 사전학습시에 사용된 프롬프트와 다른 형식의 프롬프트에 대응을 하지 못하는 것이 지적되었다. 본 논문에서는 LLM의 zero-shot 성능을 개선할 수 있는 방법으로 Finetuned Language Net (FLAN)을 제시한다. 이는 자연어 처리 과제가 자연어 지시문으로 설명될 수 있다는 아이디어에서 착안해 60개 이상의 NLP 데이터셋으로 모델에 대한 instruction tuning을 수행한다.</p>

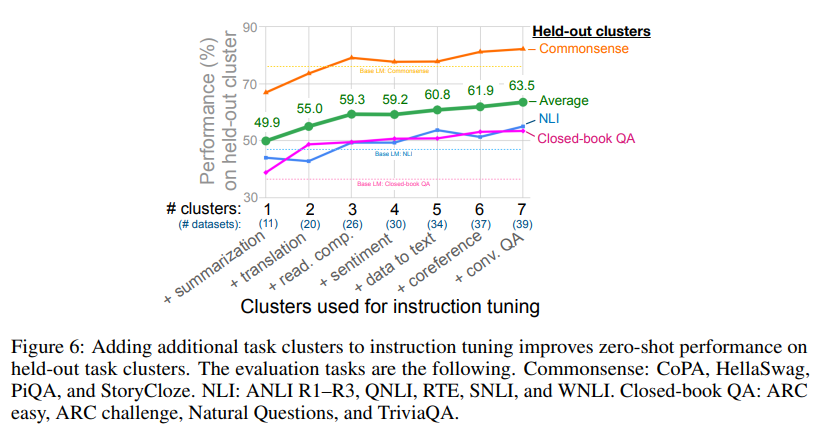
<p>FLAN의 zero-shot 성능을 평가하기 위해서 NLP 데이터셋을 문제 유형에 따라서 나누고 모델 파인튜닝에 몇 개 유형의 데이터셋을 사용한 후 파인튜닝에 사용하지 않은 유형으로 성능을 평가한다. 예를 들어 번역, 감정 분석, 상식 추론 유형의 데이터셋이 있다고 했을 때 번역과 감정 분석으로 파인튜닝된 모델로 상식 추론 능력을 평가하는 것이다. 이는 모델 학습에 사용되지 않은 유형의 문제에 대해서도 추론 능력이 전이된다는 것을 보여준다. FLAN 137B zero-shot은 figure 1에서 볼 수 있듯이 더 많은 파라미터수를 가지는 모델인 GPT-3 175B를 zero-shot과 few-shot에서 압도했다. 또한 파인튜닝을 할 때 문제 유형을 다양화하면(more task clusters) 새로운 문제 유형에서도 성능 개선이 더 잘 일어난다.</p>

<p><img src="/assets/images/flan-instruction-tuning/fig2-instruction-tuning.png" alt="Figure 2: instruction tuning compared with pretrain-finetune and prompting" /></p>

<h2 id="flan-instruction-tuning-improves-zero-shot-learning">FLAN: INSTRUCTION TUNING IMPROVES ZERO-SHOT LEARNING</h2>

<p>Instruction tuning은 언어 모델을 instruction 형태로 제시된 문제로 파인튜닝 한다면 전반적인 자연어 추론 능력이 향상되어 학습에 사용되지 않은 유형의 문제에서도 성능 개선을 보일 것이라는 의도를 가진다.</p>

<p><img src="/assets/images/flan-instruction-tuning/fig3-task-clusters.png" alt="Figure 3: datasets and task clusters used in the paper" /></p>

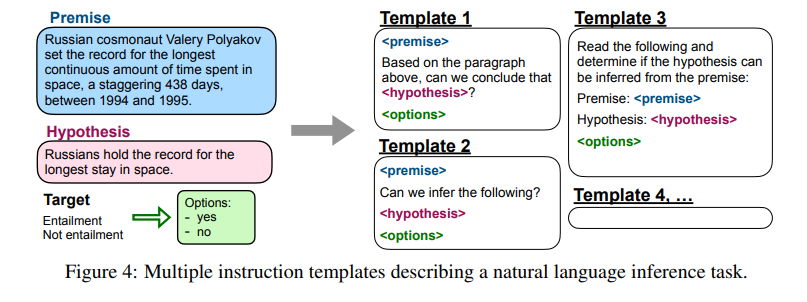
<p>Figure 3과 같이 연구진은 기존의 데이터셋을 instruction 형태로 재가공했으며 12개의 유형으로 분류하였다. 또한 각 데이터셋에 대해 해당 과제를 자연어 지시문으로 설명하는 템플릿 10개를 구현했으며 원래 과제와 다른 형태로 변형하기도 했다.</p>

<p><img src="/assets/images/flan-instruction-tuning/fig4-instruction-templates.png" alt="Figure 4: multiple instruction templates for one dataset" /></p>

<p>Figure 4와 같이 기존의 문제에 대해서 표현을 바꾼 다양한 instruction으로 데이터셋을 변형한 것이다. 이때 문제의 핵심 표현이나 정답은 변하지 않는다.</p>

<p>FLAN이 학습에 사용되지 않는 데이터셋에서도 성능 향상을 보인다는 것이 꽤나 흥미로운 점인데 이를 검증하기 위해서 tuning과 evaluation 분리가 중요했다. 일반적으로는 tuning에서 A라는 데이터셋이 사용되지 않았으면 평가시에 A라는 데이터셋을 사용하는데 FLAN에서는 데이터셋 단위가 아니라 클러스터 단위로 tuning, evaluation을 분리했다. 예를 들어 figure 3에 natural language inference 클러스터가 있는데 이에 해당하는 데이터셋 7개 전부를 tuning에서 제외하고 evaluation에서만 사용한 것이다. 즉, tuning, evaluation을 구분할 때 데이터셋 단위가 아니라 유형 단위로 구분을 했으며 이는 FLAN이 “새로운 유형”의 성능 향상에 효과가 있는 것을 보이는데 유용하다.</p>

<h2 id="results">RESULTS</h2>

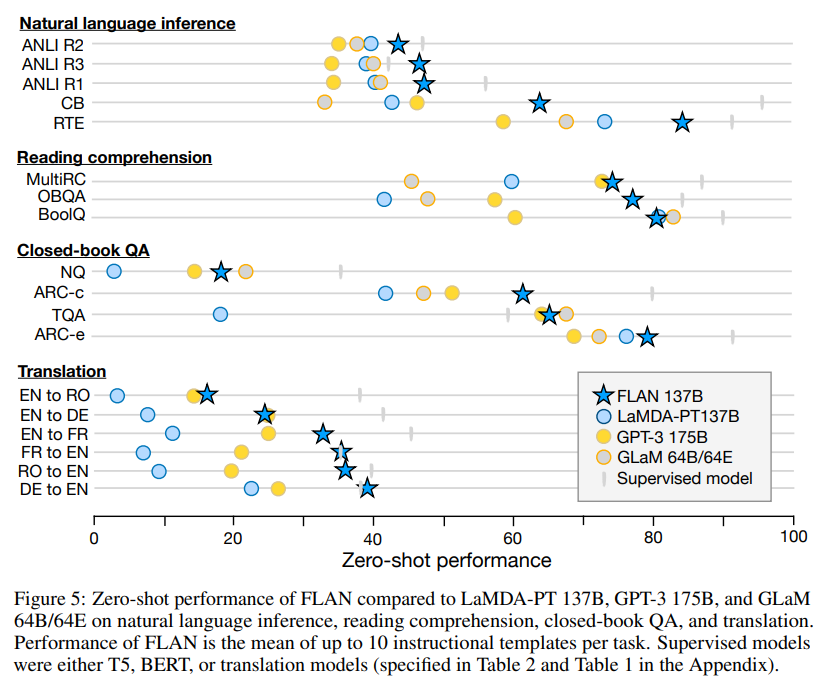
<p><img src="/assets/images/flan-instruction-tuning/fig5-results.png" alt="Results: FLAN compared with LaMDA-PT, GPT-3, and GLaM" /></p>

<p>FLAN을 natural language inference, reading comprehension을 포함한 7개의 자연어 처리 문제 유형에 평가한 결과 LaMDA-PT, GPT-3, GLaM 64B/64E와 비교해서 대부분의 유형에서 높은 성능을 보였다. 특히 FLAN의 베이스라인 모델이 되는 LaMDA-PT에 대해서는 zero-shot, few-shot과 비교해서 FLAN이 더 높은 성능을 보였고 이는 instruction tuning이 자연어 처리 문제에서 실제로 모델 성능을 개선할 수 있음을 보여준다. GPT-3과 비교했을 때 20/25개의 데이터셋에서 zero-shot 성능을 뛰어넘었고 10/25개에서는 few-shot 성능까지 뛰어넘었다. GLaM에 대해서는 zero-shot에서 13/19개, one-shot에서 11/19개에서 높은 성능을 보였다. 하지만 지시문이 필요 없는 문장 내 빈칸 채우기 등 언어 모델링 유형에서는 성능 개선을 보이지 못했다.</p>

<h2 id="ablation-studies--further-analysis">ABLATION STUDIES &amp; FURTHER ANALYSIS</h2>

<p>Instruction tuning의 의의는 파인튜닝에 사용되지 않은 유형의 문제에도 그 효과가 전이된다는 것이다. 이를 위해서 파인튜닝에 사용되는 클러스터(문제 유형)의 수(1~7개)에 따라서 NLI, closed-book QA, commonsense reasoning에서의 성능을 평가하기로 한다.</p>

<p><img src="/assets/images/flan-instruction-tuning/fig6-number-of-clusters.png" alt="Figure 6: performance on held-out clusters as the number of tuning clusters grows" /></p>

<p>Figure 6에서 볼 수 있듯이 파인튜닝에 사용되는 클러스터 수가 증가할수록 unseen task에 대한 성능 향상 폭이 커졌다. 7개의 클러스터에 대해서 모델 성능이 포화하지 않고 계속 상승하는 것을 볼 수 있으며 이는 더 많은 클러스터에서 추가 성능 개선 여지가 있음을 보인다. 하지만, 이 실험만으로는 어느 클러스터가 성능 향상에 가장 큰 영향을 주었는지는 알 수 없다.</p>

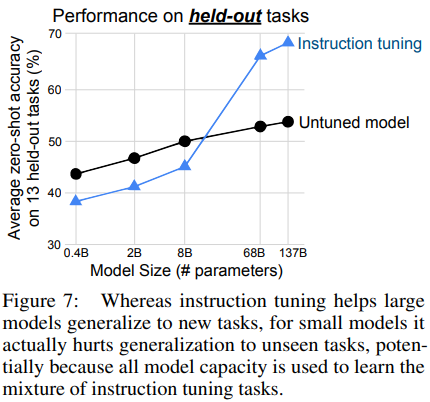
<p><img src="/assets/images/flan-instruction-tuning/fig7-model-scale.png" alt="Figure 7: effect of model scale on instruction tuning" /></p>

<p>기존의 chain of thought이나 self-consistency와 같은 프롬프팅 기반의 방법은 모델 파라미터 수가 클수록 더 큰 개선을 보였다. Instruction tuning에서도 모델 파라미터 수에 따른 성능 개선 정도를 비교하기 위해 7개 클러스터로 파인튜닝을 진행했고 figure 7과 같은 결과가 나왔다. 눈여겨 볼만한 점은 8B 이하의 모델에서는 오히려 instruction tuning이 악영향을 주었다. 이는 40개 데이터셋에 대해서 파인튜닝 하는 동안 소형 모델에서는 instruction tuning이 model capacity를 포화시켜 일종의 overfitting이 발생해 unseen task에 대해서 낮은 성능을 보인다고 해석할 수 있다. 반면 대형 모델에서는 instruction tuning이 model capacity를 개선함과 동시에 모델이 보편적인 문제 유형에서 지시문을 따라 추론 능력이 강화된다고 해석할 수 있다.</p>

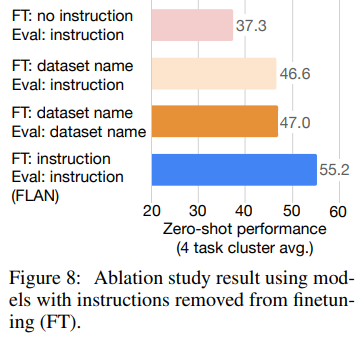
<p><img src="/assets/images/flan-instruction-tuning/fig8-role-of-instructions.png" alt="Figure 8: role of instructions in the tuning data" /></p>

<p>Instruction tuning에서 실제 지시문이 성능 개선에 영향을 주는지를 파악하기 위해 다음과 같은 설정으로 파인튜닝을 진행한 결과와 instruction tuning을 비교한다.</p>

<ul>
  <li>No template: 입력과 출력만 제공(번역 문제에서 “The dog runs.”를 입력으로, “Le chien court.”가 출력으로 제공되어 사실상 문제와 답만 제공됨)</li>
  <li>Dataset name: 데이터셋 이름과 입력을 함께 제공(입력: [Translation: WMT’14 to French] “The dog runs.”, 출력: “Le chien court.”)</li>
</ul>

<p>FLAN에서는 위의 두 가지와 달리 “Please translate this sentence to French”라는 instruction이 포함된다. Figure 8의 결과를 보면 FLAN이 no template, dataset name 조건보다 높은 성능을 보이며 지시문이 zero-shot 성능을 높이는데 학습에서 핵심적인 역할을 함을 보여준다.</p>

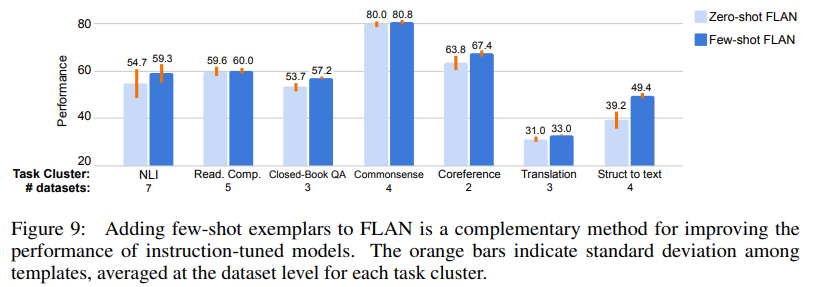
<p><img src="/assets/images/flan-instruction-tuning/fig9-few-shot.png" alt="Figure 9: instruction tuning combined with few-shot exemplars" /></p>

<p>추가적으로 instruction tuning은 few-shot exemplar와 함께 사용이 될 때에도 성능 향상을 보였다.</p>

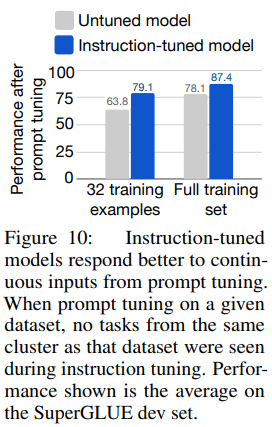
<p><img src="/assets/images/flan-instruction-tuning/fig10-prompt-tuning.png" alt="Figure 10: FLAN as a better checkpoint for prompt tuning" /></p>

<p>마지막으로 FLAN이 실제로 NLP 계열 문제를 수행하는데 적합해졌다면 soft prompt를 사용할 때에도 성능이 개선되어야 할 것이다. Soft prompt와 prompt tuning이 여기서 등장하는데 각각에 대한 설명은 다음과 같다.</p>

<ul>
  <li>Soft prompt: 임베딩된 프롬프트 앞에 붙이는 학습 가능한 연속 벡터로 모델 출력 개선을 위한 학습 대상이 됨</li>
  <li>Prompt tuning: 기존 모델의 가중치는 고정한 채 soft prompt가 loss에 미치는 영향을 back-propagation으로 계산해 soft prompt vector를 업데이트 하는 과정</li>
</ul>

<p>FLAN은 prompt tuning시에도 baseline 모델과 비교해 성능 향상을 보였으며 이는 instruction tuning이 NLP 문제 해결을 위한 더 적합한 체크포인트를 만들어 낼 수 있다는 것을 보여주는 또 다른 방식이다.</p>

<h2 id="discussion-and-conclusions">DISCUSSION AND CONCLUSIONS</h2>

<p>Instruction tuning을 통해 파인튜닝의 효과가 파인튜닝에 사용되지 않은 유형의 unseen task에도 전이됨을 보였다. 또한 ablation study를 통해서 unseen task에 대한 성능은 파인튜닝에 사용되는 문제 유형의 수(number of clusters)에 비례하고, 모델 파라미터 수가 충분히 클 때에만 그 효과가 발현되고, few-shot이나 prompt tuning과 같은 프롬프팅 기법과도 동반될 수 있음을 보였다. LLM은 지금까지 특정 도메인에 특화 하는 것(specialist model)과, 범용적 과제에 적용하는 것(generalist model) 사이에서 어느 쪽을 택해야 하는지 많은 관심을 불러일으키고 있었는데 instruction tuning은 cross task generalization을 통해 도메인 특화와 범용적 적용이 상호 보완적임을 보였고 generalist model에 대한 추가적인 연구 방향을 제시한다.</p>

<h2 id="느낀점">느낀점</h2>

<p>Instruction tuning은 파인튜닝에 사용되지 않은 유형의 unseen task에까지 그 효과가 전이된다는 의의를 가지며 instruction이 모델의 추론 성능 자체를 향상시킬 수 있음을 보여준다. 하지만 instruction을 포함하는 train set을 구축하는 것은 시간과 비용이 들며 기존의 벤치마크의 표현을 바꿔서 instruction을 생성했다고 했는데 그렇다면 본질적으로 다양한 유형에 대한 벤치마크가 충분히 갖춰져야 instruction tuning을 계속해서 확장할 수 있다. Instruction을 제공하는 것이 정답 청크를 생성하는데 유의미한 영향을 준다면 디코딩 과정에서 토큰 생성 확률에 instruction의 유무가 영향을 주고 파인튜닝을 통해 이를 개선할 수 있다는 것인데 이를 더 자세히 분석해보고 싶다.</p>]]></content><author><name>Jaewon Seo</name></author><category term="paper-review" /><category term="llm" /><category term="fine-tuning" /><summary type="html"><![CDATA[Jason Wei et al., ICLR 2022]]></summary></entry><entry><title type="html">Self-Consistency Improves Chain of Thought Reasoning in Language Models</title><link href="https://ddungjae.github.io/posts/self-consistency/" rel="alternate" type="text/html" title="Self-Consistency Improves Chain of Thought Reasoning in Language Models" /><published>2026-09-09T00:00:00+09:00</published><updated>2026-09-09T00:00:00+09:00</updated><id>https://ddungjae.github.io/posts/self-consistency</id><content type="html" xml:base="https://ddungjae.github.io/posts/self-consistency/"><![CDATA[<p><a href="https://arxiv.org/pdf/2203.11171">https://arxiv.org/pdf/2203.11171</a></p>

<h2 id="introduction">INTRODUCTION</h2>

<p>이전에 chain of thought 프롬프팅으로, 다양한 분야의 문제에서(수리, 상식, 기호 등) 대형 모델의 추론 능력을 파인튜닝 없이 프롬프팅만으로 높일 수 있다는 것이 알려졌었다. 본 논문에서는 chain of thought 프롬프팅에서 사용되는 greedy decoding을 개선한 self-consistency라는 decoding 전략을 제안한다. Self-consistency는 여러 개의 추론 경로에서 각각 답을 도출한 후(sampling) 가장 일관된(consistent) 답변을 채택한다. 이는 복잡한 문제일수록 다양한 풀이 방법이 있을 수 있고, 다양한 방법이 공통적으로 내놓는 답이 정답일 것이라는 인간의 직관과도 맞아 떨어진다.</p>

<p>이러한 self-consistency 방식은 추가적인 검증자(verifier)이나 답변 순위를 재정렬하는 것(re-ranker)을 학습할 필요 없이 비지도방식으로 파인튜닝 없이 바로 적용이 가능하다. 또한 여러 모델을 학습시킨 결과를 앙상블 하는 방식이 아니라 단일 모델의 출력을 앙상블하는 self-ensemble이라고 볼 수 있다.</p>

<p>Self-consistency 방식은 UL2-20B, GPT3-175B, LaMDA-137B, PaLM-540B의 모델에서 GSM8K, SVAMP, AQuA와 같은 벤치마크에서 SOTA를 달성했다. 이는 chain of thought 프롬프팅이 자칫 역효과를 낼 수 있는 NLP 과제에서도 self-consistency는 성능 향상을 보였다는 의의가 있고 여러 앙상블 전략(sample-and-rank, beam search)도 압도한다. 한가지 눈여겨 볼만한 점은 기존에 chain of thought 프롬프팅은 100B 이상의 모델에서만 효과를 보였는데 self-consistency는 UL2-20B에서도 성능 향상을 보였다.</p>

<h2 id="self-consistency-over-diverse-reasoning-paths">SELF-CONSISTENCY OVER DIVERSE REASONING PATHS</h2>

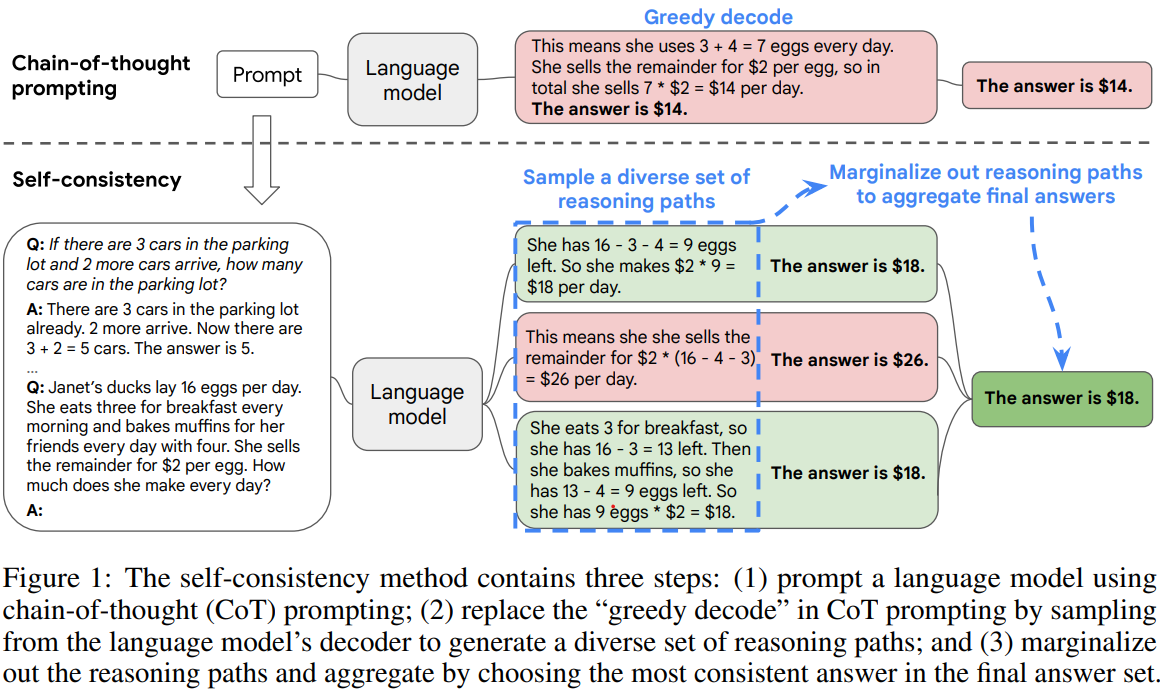
<p><img src="/assets/images/self-consistency/fig1-reasoning-paths.png" alt="Figure 1: self-consistency samples diverse reasoning paths and takes the most consistent answer" /></p>

<p>문제를 풀 때 사람마다 다른 풀이 방법을 제시하는 경우가 많고, 이는 하나의 문제에도 다양한 해결 방법이 있을 수 있다는 것을 보여준다. LLM의 디코더에서 답변을 샘플링하는 방법으로 유사한 효과를 볼 수 있다. Figure 1에서, 여러 디코딩 방식에서의 출력을 보면 모델이 문제의 정답을 맞출 수도 있고, 물론 틀린 답을 낼 수도 있다. 이처럼 LLM은 서로 다른 풀이 과정을 통해서 맞거나, 틀린 답을 낼 수 있지만 서로 다른 풀이 과정이 올바른 논리적 흐름을 따라간다면, 결국 그 답은 정답 하나로 수렴할 것이라는 가설을 세울 수 있다.</p>

<p>이 가설을 시험하기 위해 다음과 같은 실험을 설계한다.</p>

<ol>
  <li>LLM을 chain of thought 방식으로 프롬프팅한다.</li>
  <li>모델 디코더에서 여러 가지 추론 경로를 샘플링한다. 이때 다음과 같은 샘플링 방법이 사용된다.
    <ul>
      <li>Temperature sampling</li>
      <li>Top-k sampling</li>
      <li>Nucleus sampling</li>
    </ul>
  </li>
  <li>여러 추론 경로로부터 나온 답변 중 추론 경로에 관계 없이 가장 빈도가 높게 나온 답을 최종 선택한다.
    <ul>
      <li>같은 문제에서 풀이 과정은 무시하고 가장 많이 나온 답을 선택한다.</li>
      <li>즉 샘플링은 다양한 추론 경로를 만들어내기 위해서이고 추론 과정 그 자체는 답을 선정할 때 고려하지 않는다.</li>
    </ul>
  </li>
</ol>

\[\operatorname{argmax}_a \sum^m_{i=1} \mathbb{1}(a_i = a)\]

<p>수식으로 표현하면 \(r_i\)라는 추론 과정을 거쳐서 \(a_i\)라는 답변이 나온다고 할 때 이때 \(a_i\)중에서 가장 많이 나온 답을 \(a\)라고 하고 이것을 최종 답변으로 선택한다. 단순히 말하면 그냥 다수결로 답을 고르는 것이다.</p>

\[w_i = P(r_i, a_i \mid \text{prompt, question}) = \exp\!\left(\frac{1}{K}\sum^K_{k=1} \log P(t_k \mid \text{prompt, question}, t_1, \ldots, t_{k-1})\right)\]

<p>특정 프롬프트와 문제에 대해서, \(r_i\)라는 풀이 과정과 \(a_i\)라는 답을 낼 확률을 위와 같이 나타낼 수 있다. 여기서 \(\log P(t_k \mid \text{prompt, question}, t_1, \ldots, t_{k-1})\)는 \(r_i\)와 \(a_i\)에서의 \(k\)번째 토큰이 \(t_k\)일 확률로 따라서 전체 출력인 \(r_i\)와 \(a_i\)를 생성할 때 순차적으로 1번 토큰, 2번 토큰을 거쳐 마지막 토큰까지 생성될 확률을 모두 로그합으로 더한 후 토큰 개수인 \(K\)로 나누어 보정한 것이다. 이 확률을 \(w_i\)라고 하자.</p>

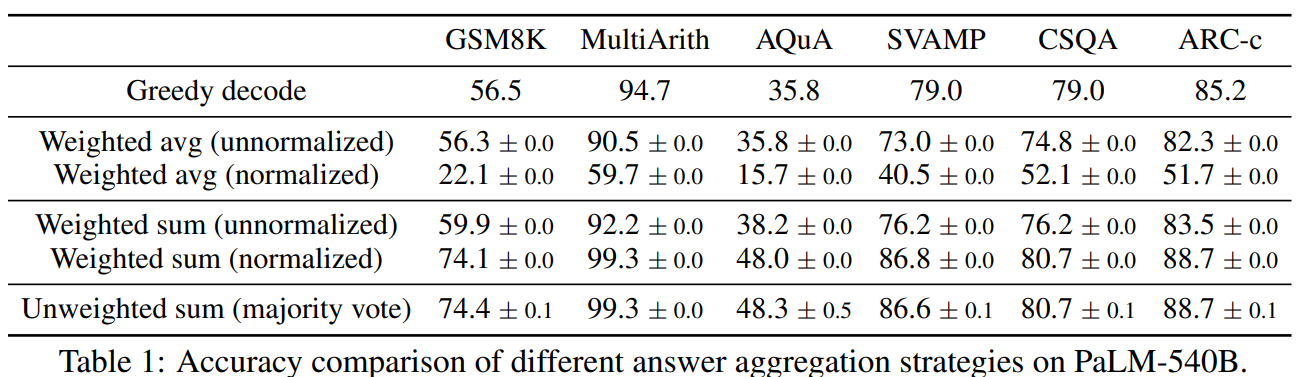
<p><img src="/assets/images/self-consistency/table-aggregation-strategies.png" alt="Table: test accuracy by aggregation strategy" /></p>

<p>위의 표를 보면 여러 aggregation strategy에 따른 각 벤치마크에서의 test accuracy를 보여준다. 가장 아래의 unweighted sum은 이전에 말한 다수결 방식이다. 이외에도 weighted 방식이 등장하는데 이는 모델이 답한 \(a_i\)라는 답에 위의 수식의에서의 \(P(r_i, a_i \mid \text{prompt, question})\)로 가중치를 부여하는 방식이다. 즉, 가장 많이 나온 답변을 고르는게 아니라 해당 답변이 나올 확률까지도 고려한다. 각 샘플링 방법별로 답을 고르는 방식은 다음과 같이 표현할 수 있다.</p>

<ul>
  <li>Weighted avg (normalized): \(\operatorname{argmax}_a \dfrac{\sum^m_{i=1} w_i\,\mathbb{1}(a_i = a)}{\sum^m_{i=1} \mathbb{1}(a_i = a)}\)</li>
  <li>Weighted sum (normalized): \(\operatorname{argmax}_a \sum^m_{i=1} w_i\,\mathbb{1}(a_i = a)\)</li>
  <li>Unweighted sum (majority vote): \(\operatorname{argmax}_a \sum^m_{i=1} \mathbb{1}(a_i = a)\)</li>
</ul>

<p>Weighted와 unweighted의 차이는 토큰 길이 만큼 보정을 하느냐 하지 않느냐 차이이다. 벤치마크 결과를 보면 normalized weighted sum과 unweighted sum의 수치가 거의 동일한데 이는 모델에서 \(w_i\)가 거의 비슷하기 때문이라고 한다. 또한 weighted sum 방식에서 normalized가 unnormalized보다 큰 성능 향상을 보이고, weighted averaged 방식은 가장 성능이 떨어짐을 볼 수 있다.</p>

<p>기존의 연구자들은 reasoning task가 정해진 답을 가지고 있다는 점에서 greedy decoding 방식을 사용했는데 답이 정해져 있어도 추론 과정을 다양화 하는 것이 좋은 성능을 낼 수 있다는 것이 이번 실험에서 입증됐다. 하지만 이러한 샘플링 방식은 답이 정해져 있는 문제에서만 사용될 수 있고 open-text generation problem(서술형 문제 등)에서는 이를 평가할 벤치마크 등이 도입되어야 한다는 한계점이 남는다.</p>

<h2 id="experiments">EXPERIMENTS</h2>

<p>이전에 chain of thought 논문에서 수행했던 것처럼 self-consistency 방식을 평가하기 위해서 arithmetic reasoning(산술 연산), commonsense reasoning(상식 추론), symbolic reasoning(기호 추론)에 대해서 벤치마크 테스트를 진행했다.</p>

<p><img src="/assets/images/self-consistency/table-benchmarks.png" alt="Table: accuracy on arithmetic, commonsense, and symbolic reasoning benchmarks" /></p>

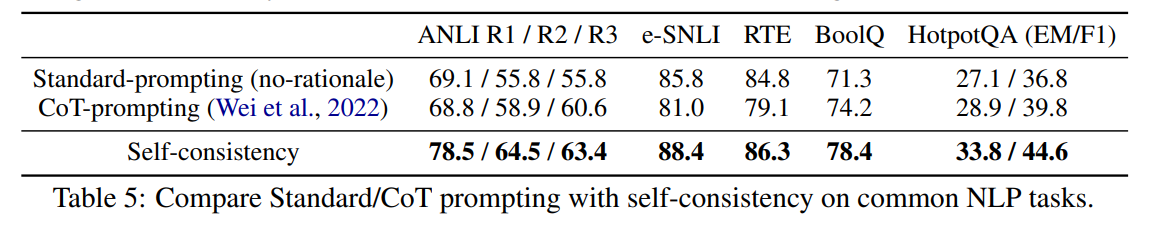
<p>Self-consistency 방식은 chain of thought과 비교해서 arithmetic reasoning, commonsense reasoning, symbolic reasoning 모두에서 성능 향상을 보였다. 특히 기존에 chain of thought이 크게 개선을 보이지 못했던 100B 이하 모델에서도 성능 향상을 보였고 GPT-3과 같은 대형 모델에서도 추가적인 성능 향상을 보였다. 위의 표에서는 샘플링 대상이 많아질수록 정답률이 높아짐을 보이며 이는 다양한 추론 경로가 중요함을 보인다.</p>

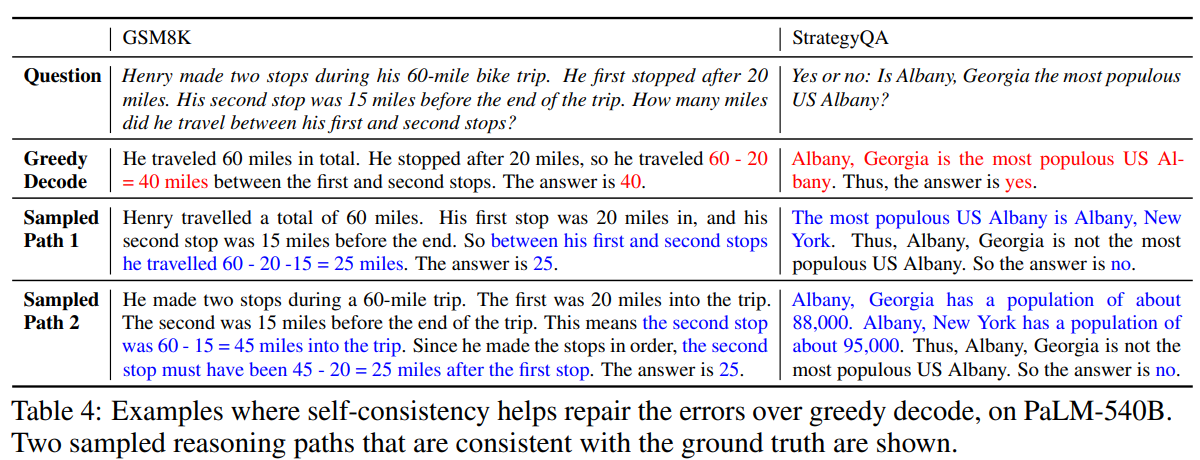
<p><img src="/assets/images/self-consistency/table-greedy-vs-sampled.png" alt="Table: greedy decoding vs. sampled reasoning paths" /></p>

<p>위의 표를 보면 greedy 디코딩에서는 틀린 답이 나온 반면 두 개의 sampled path에서는 정답이 나왔다. Greedy 디코딩은 각 단계에서 가장 높은 확률의 토큰을 선택하는데 확률이 높다고 해서 항상 정답은 아니라는 점이 신기한 것 같다.</p>

<p><img src="/assets/images/self-consistency/table-nlp-tasks.png" alt="Table: standard prompting vs. chain of thought vs. self-consistency on NLP tasks" /></p>

<p>이전에 chain of thought은 정형화된 답을 내는 문제가 아닌 자연어를 정답으로 생성하는 문제에서 역효과를 보였었다. 위의 표를 보면 chain of thought이 standard prompting보다 성능이 떨어지는 것을 볼 수 있는데 self-consistency 방식은 오히려 점수가 상승했다. 여기에서도 여러 추론 경로로부터 답을 도출하는 것이 중요함을 볼 수 있다.</p>

<p>Self-consistency는 chain of thought의 성능만을 능가하는 것이 아니라 기존의 다른 방법론들인 sample-and-rank, beam search, ensemble-based approaches보다 뛰어난 성능을 보인다.</p>

<ul>
  <li>Sample-and-rank: 디코더에서 여러 개의 출력을 샘플링 후 가장 log-probability가 높은 시퀀스를 선택한다.</li>
  <li>Beam search: 토큰 출력 후보중 beam size에 해당하는 개수의 토큰만 남기고 각 후보에서 다음 토큰을 붙여 확장한다. 이후 확장된 후보 전체에서 누적 확률이 가장 높은 beam size만큼의 후보만 남기고 이 과정을 반복한다.</li>
  <li>Ensemble-based approaches: prompt order permutation(예시를 프롬프트 내에서 순서를 변경), multiple sets of prompts(여러 개의 예시 집합으로 각각의 프롬프트 생성)의 방법으로 나온 답변 중 다수결로 선택(majority vote).</li>
</ul>

<p>기존에 모델 출력을 개선하기 위한 세 가지의 방법과 비교해도 자연어 서술 벤치마크에서 self-consistency가 가장 높은 성능 향상을 보였다.</p>

<p><img src="/assets/images/self-consistency/fig4-sampling-robustness.png" alt="Figure 4: robustness to sampling strategies and model scale" /></p>

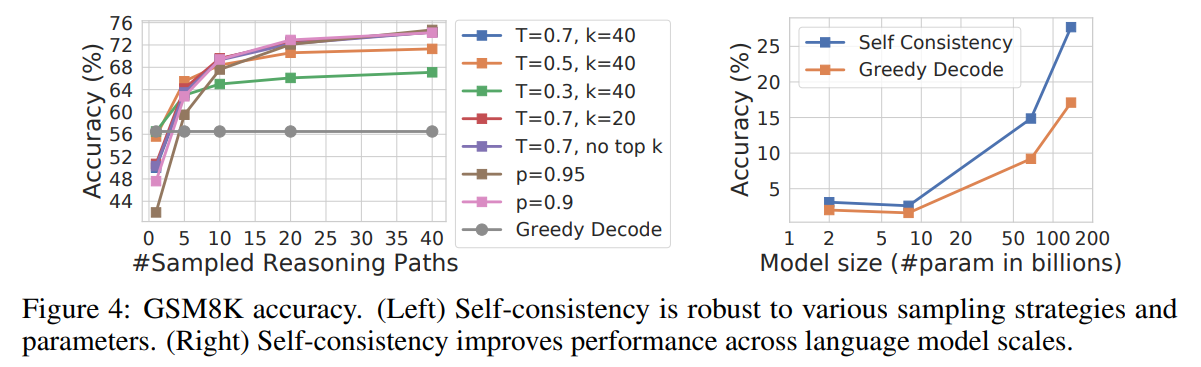
<p>Self-consistency는 기존의 chain of thought 프롬프팅이나 sample and rank, beam search, ensemble based approach와 비교해서 모두 모델 출력을 개선함을 보였다. 더불어, self-consistency는 샘플링 전략 자체에도 강건하다. 샘플링에서 temperature을 변경하거나, \(\text{top-}k\) 샘플링에서 \(k\)를 변경할 때, nucleus 샘플링에서 \(p\)를 변경할 때에도 self-consistency는 성능 향상을 보였다. 즉 self-consistency는 특정 샘플링 방법이나 파라미터에 의존적이지 않고 추론 경로 다양화 그 자체가 효과가 있음을 입증한다. 또한, 모델 파라미터 수가 커질 수록 성능 개선 폭이 커짐 역시 Figure 4에서 볼 수 있다.</p>

<p><img src="/assets/images/self-consistency/fig5-imperfect-prompts.png" alt="Figure 5: robustness to imperfect prompts, and consistency as a confidence signal" /></p>

<p>Self-consistency는 imperfect prompts에서도 강건하게 동작한다. Imperfect prompt는 프롬프트에서의 사소한 오류를 말한다.</p>

<ul>
  <li>사람이 2명 있는데 3명 더 온다. 2+3=6이므로 답은 6.</li>
</ul>

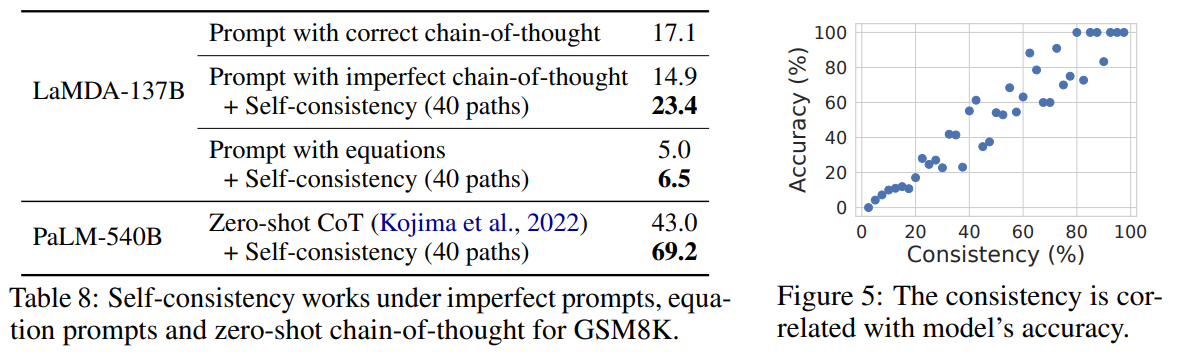
<p>위와 같이 프롬프트에서 틀린 계산이나, 표현이 있어도 self-consistency는 틀린 표현으로 인해 chain of thought에서 감소하는 정답률을 보완해준다. 프롬프트에 수식을 포함하는 방식 또한 개선을 주긴는 하지만 자연어 논리 흐름을 적는 것에 비해서는 적은 개선폭을 보인다. Figure 5에서는 consistency(전체 샘플링 개수 중 선택된 답을 포함하는 비율)와 accuracy가 비례하는 경향이 나타나는데 이는 consistency를 confidence의 지표로 사용할수도 있다는 것을 보여준다.</p>

<h2 id="conclusion-and-discussion">CONCLUSION AND DISCUSSION</h2>

<p>Self consistency는 기존의 chain of thought보다 한 단계 더 발전해 연산, 상식, 기호 등의 분야에서 뛰어난 성능을 보였다. Self consistency는 모델이 추론 과제를 수행할 때 추론의 근거를 남길 뿐만 아니라 confidence의 지표로도 사용될 수 있다는 점에서 모델의 accuracy와 confidence를 연관 짓는데 도움을 줄 수 있다. 하지만 self consistency는 샘플링을 위해 더 많은 연산을 수행해야 한다는 단점이 있다. 그러나 5~10개의 적은 샘플링 만으로도 충분한 성능 향상을 보이기는 한다. 향후 과제로 self consistency를 사용해 파인튜닝을 위한 지도학습 데이터를 구축하는 등의 방법을 고민해 볼 수 있다. 모델이 간혹 올바르지 않은 추론 경로를 따라가는 경우도 있는데 추론 근거가 사실을 더 따라가도록 개선할 필요도 있다.</p>

<h2 id="느낀점">느낀점</h2>

<p>기존의 chain of thought가 프롬프팅으로 모델 성능을 개선했다면 self consistency는 추론 경로의 다양화로 모델 성능을 개선했다. 하지만 self consistency는 컴퓨팅 용량 자체를 더 많이 사용하기 때문에 tradeoff가 발생한다고 생각이 든다. Chain of thought과 self consistency 모두 모델이 가진 잠재 성능을 극대화 하는 방법이지만 결국 모델 자체의 추론 능력이 부족하다면 큰 효과를 보기 어려운 방식이다. Self consistency에서 각각의 추론 경로는 결국 모델 파라미터 수나 성능에 의존하기 때문에 결국 더 큰, 더 똑똑한 모델이 필요하기는 하다. 그럼에도 self consistency는 여러 경로의 추론, 디코딩에서 모델이 잠재적으로 맞는 답을 낼 수 있다는 것을 여러 실험을 통해 보여줬으며 디코딩 알고리즘을 변형한다고 했을 때 동일한 컴퓨팅 용량 안에서 모델 성능이 개선될 수도 있을 것 같다.</p>]]></content><author><name>Jaewon Seo</name></author><category term="paper-review" /><category term="llm" /><category term="prompting" /><category term="reasoning" /><summary type="html"><![CDATA[Xuezhi Wang et al., ICLR 2023]]></summary></entry><entry><title type="html">Chain-of-Thought Prompting Elicits Reasoning in Large Language Models</title><link href="https://ddungjae.github.io/posts/chain-of-thought-prompting/" rel="alternate" type="text/html" title="Chain-of-Thought Prompting Elicits Reasoning in Large Language Models" /><published>2026-09-08T00:00:00+09:00</published><updated>2026-09-08T00:00:00+09:00</updated><id>https://ddungjae.github.io/posts/chain-of-thought-prompting</id><content type="html" xml:base="https://ddungjae.github.io/posts/chain-of-thought-prompting/"><![CDATA[<p><a href="https://arxiv.org/pdf/2201.11903">https://arxiv.org/pdf/2201.11903</a></p>

<h2 id="introduction">Introduction</h2>

<p>언어 모델의 크기를 키우는 것(파라미터 수가 증가하는 것)은 모델 성능 향상과 학습 효율성을 가져오기는 하지만, 연산이나 상식, 기호 추론과 같은 문제를 해결 하기에는 여전히 한계가 있다. 이러한 문제를 다음과 같은 방법으로 해결하려는 시도가 있었지만 여전히 한계를 가진다.</p>

<ol>
  <li>Natural language rationales
    <ul>
      <li>풀이 과정을 적는 것처럼 중간 과정을 포함해서 답변을 생성하도록 함</li>
      <li>복잡한 풀이 과정을 포함하는 학습 데이터를 구축하는 것은 시간과 비용이 너무 많이 소요됨</li>
    </ul>
  </li>
  <li>Input-output exemplars
    <ul>
      <li>관련된 예시(문제+답)를 프롬프트에 입력해서 LLM이 패턴을 파악하도록 함</li>
      <li>단순히 답을 내는 문제에는 잘 작동하지만, 복잡한 추론을 요구하는 문제에서는 성능이 떨어짐</li>
    </ul>
  </li>
</ol>

<p>본 논문에서는 위의 두 가지 아이디어의 강점만을 합쳐 파인튜닝 없이 복잡한 문제에 대한 논리적 추론이 가능하도록 했다.</p>

<ul>
  <li>input-chain of thought-output</li>
  <li>chain of thought: 자연어로 설명된 답을 도출하기 위한 사고 과정</li>
</ul>

<p>이러한 chain of thought 프롬프팅은 추가 학습 없이 범용적인 문제에 대해서 자연어 설명 만으로 LLM의 성능을 끌어올린다는 점에서 의의를 가진다.</p>

<h2 id="chain-of-thought-prompting">Chain-of-Thought Prompting</h2>

<p>Chain of thought 프롬프팅은 수학문제를 풀 때 풀이과정을 적는 것처럼 LLM이 사고 과정을 최종 출력에 포함할 수 있도록 한다. Chain of thought 프롬프팅은 다음과 같은 장점을 가진다.</p>

<ol>
  <li>모델이 여러 단계를 거쳐야 하는 문제를 중간 단계 여러개로 쪼개서 더 복잡한 문제에 대해서는 더 많은 연산 자원을 할당하도록 한다.</li>
  <li>모델 출력이 설명 가능하도록 하며 틀린 답변이 나온 경우 중간 단계 중 어느 부분에서 오류가 났는지 찾을 수 있도록 한다.</li>
  <li>산술 연산, 상식, 기호와 같이 자연어로 설명이 가능한 대부분의 문제에 적용 가능하다.</li>
  <li>파인튜닝과 같은 추가 학습 없이 프롬프트에 이러한 의사 결정 과정을 첨부하는 것 만으로 모델 성능을 향상시킬 수 있다.</li>
</ol>

<p><img src="/assets/images/chain-of-thought-prompting/cot-prompting-example.png" alt="Chain-of-thought prompting example (Wei et al., 2022)" /></p>

<p>위의 그림처럼 문제, chain of thought, 정답의 형식으로 중간 풀이 과정을 프롬프트에 포함해서 이와 같은 구조로 LLM에게 문제를 풀라고 지시하는 것이 chain of thought 프롬프팅이다. 이 방법은 다양한 분야의 문제 해결에 사용될 수 있다.</p>

<h2 id="arithmetic-reasoning">Arithmetic Reasoning</h2>

<p>일반적인 프롬프팅과 chain of thought 프롬프팅을 비교하기 위해 다음과 같이 모델이 추론 과정에서 참고할 프롬프트를 입력했다.</p>

<ul>
  <li>Q: Roger has 5 tennis balls. He buys 2 more cans of tennis balls. Each can has 3 tennis balls. How many tennis balls does he have now?</li>
  <li>A: Roger started with 5 balls. 2 cans of 3 tennis balls each is 6 tennis balls. 5+6=11. (The answer is 11.)</li>
</ul>

<p>Answer 부분에서 일반 적인 프롬프트에서는 괄호 안의 “The answer is 11.”만, chain of thought 프롬프트에서는 11이라는 답이 나오는 과정을 위와 같이 자세히 입력했다.</p>

<p>Arithmetic Reasoning에서 chain of thought 프롬프팅은 다음과 같은 의의를 가진다.</p>

<ol>
  <li>Chain of thought 프롬프팅은 모델 파라미터 수에 영향을 받는다. 파라미터 수가 적은 모델에 대해서는 개선이 없거나 오히려 성능이 떨어진 반면 100B 이상의 모델에서는 성능이 향상되었다.</li>
  <li>Chain of thought 프롬프팅은 복잡한 문제에서 더 높은 성능 향상을 보인다. 가장 어려운 GSM8K 벤치마크에서는 GPT, PaLM 모델에서 두 배 이상의 성능 향상을 보인 반면 가장 쉬운 MAWPS 벤치마크에서는 성능 개선이 거의 없었다.</li>
  <li>GPT-3 175B, PaLM 540B 모델에서 chain of thought은 각 태스크에 파인튜닝된 모델의 성능을 넘어 SOTA를 달성하거나 2% 이하의 거의 근접한 성능을 냈다(SOTA on GSM8K, SVAMP, MAWPS).</li>
</ol>

<p>모델이 chain of thought을 통해서 답을 내는 과정을 볼 때 정답을 맞추는 경우에는 논리적 과정을 거쳐 답을 냈고, 답이 틀린 경우에는 46%에서는 단순 계산 실수 등, 54%에서는 문제의 의미 자체를 틀리거나 논리가 맞지 않은 경우였다. 이는 파라미터가 많은 모델(큰 규모의 모델)에서는 모델 자체의 성능 개선으로 인해 발생 빈도가 줄어들며 chain of thought가 왜 큰 모델에서 더 잘 동작 하는지를 보여준다.</p>

<p>Ablation study에서는 다른 방식의 프롬프팅을 사용할 때 chain of thought 프롬프팅만큼의 성능이 나오지 않는 이유를 분석한다.</p>

<ul>
  <li>Equation only: 중간 과정에서 자연어 설명 대신 수식만 출력하도록 하는 방법은 1, 2단계로 이루어진 간단한 문제에서는 효과적이었으나 복잡한 문제(GSM8K)에서는 효과가 없었고 이는 자연어 논리 구성 단계 없이 바로 복잡한 수식으로 넘어가는 것이 어려움을 보인다.</li>
  <li>Variable compute only: Chain of thought가 출력량을 늘리면서 많은 토큰을 사용해 연산 자원을 더 많이 사용하는 것이라는 가설에 대해서 수식 계산에 필요한 만큼 점을 출력(의미는 없지만 토큰을 차지)하도록 한 결과 baseline과 비교해 성능 변화가 없었다. 즉 단순히 출력 토큰을 늘리는 것이 아니라 자연어로 논리 과정을 서술함이 중요하다.</li>
  <li>Chain of thought after answer: 모델이 정답을 먼저 출력하고 그 뒤에 chain of thought을 붙이도록 강제했는데 이 경우 baseline과 비교해 성능 개선이 없었고 정답 도출 전의 논리적 흐름이 추론에 도움을 준다고 말할 수 있다.</li>
</ul>

<p>Chain of thought은 특정 구조의 프롬프트에 의존적이지 않고 “논리적 흐름”이라는 형식을 갖추는 프롬프트에 대해 보편적으로 동작한다. 서로 다른 사람이 작성한 프롬프트여도, chain of thought의 핵심 아이디어만 포함한다면 baseline 모델보다 높은 성능을 보인다. 또한, 프롬프트에 들어가는 예시의 종류에 관계 없이도 성능 향상을 보인다.</p>

<h2 id="commonsense-reasoning">Commonsense Reasoning</h2>

<p>앞서 계산 문제에 대해 chain of thought을 적용해 성능이 개선된 사례를 보았는데, 일반적인 상식과 관련한 추론에서도 chain of thought 프롬프팅은 성능 향상에 도움이 된다. 계산 문제에서의 결과와 유사하게, 파라미터 개수가 많은 모델에서 chain of thought 프롬프팅을 적용했을 때 CSQA, StrategyQA 등에서 벤치마크 점수가 향상되었다.</p>

<h2 id="symbolic-reasoning">Symbolic Reasoning</h2>

<p>Chain of thought 프롬프팅은 기호 조작 분야에서도 좋은 성능을 나타낸다. 여기에서는 두 가지 벤치마크를 사용했다.</p>

<ul>
  <li>Last Letter Concatenation: 단어의 마지막 글자들을 조합하는 문제(Amy Brown이라면 yn)</li>
  <li>Coin flip: 여러 조작이 가해진 뒤 동전의 상태를 추정하는 문제(A coin is heads up. Phoebe flips the coin, Osvaldo does not flip the coin. Is the coin still heads up? 이 경우 앞면인 상태에서 Phoebe만 동전을 뒤집었으므로 뒷면)</li>
</ul>

<p>위의 두 가지 벤치마크에 대해 in domain 테스트에서는 exemplars에서와 동일한 횟수의 조작을 가하는 문제를(예시에서 단어 두 개, 사람 두 명이 등장하면 실제 테스트에서도 단어 두 개, 사람 두 명이 등장하도록), out of domain 테스트에서는 exemplars 보다 많은 횟수의 조작을 가하는 문제를 제시했다(단어 3, 4개를 제시하거나 동전을 뒤집는 횟수가 더 많게).</p>

<p>In domain과 out of domain에서 모두 chain of thought 프롬프팅을 적용했을 때 파라미터 수가 작은 모델에서는 성능 향상이 미미하거나 없었지만 100B 이상의 모델에서는 큰 성능 향상이 있었다. 특히 예시와 다른 기호나 표현을 사용했을 때 chain of thought의 성능이 발현하려면 큰 모델이 필요했다.</p>

<h2 id="discussion">Discussion</h2>

<p>Chain of thought 프롬프팅은 arithmetic reasoning, commonsense reasoning, symbolic reasoning에서 모두 파라미터 수가 많은 모델에 대해서 비약적인 성능 향상을 이루었고 이러한 성능 향상은 모두 파인튜닝 없이 이루어졌다. 기존의 프롬프팅 방법과 비교해서, chain of thought 프롬프팅은 모델 크기가 커질 수록 성능이 더 크게 상승하도록 하며 프롬프팅 만으로 모델이 가진 잠재력을 이끌어낼 수 있도록 한다.</p>

<p>Chain of thought이 가지는 한계로는 우선, chain of thought이 출력 결과에 사람이 추론하는 것과 유사한 답변을 나오게는 하지만 이것이 실제로 신경망 내부에서 “추론”이라는 과정에 수행되는지는 알 수 없다. 또한 프롬프트에 들어갈 예시를 몇 개 만드는 것은 비용이 크게 들지 않지만 파인튜닝을 위한 exemplar 데이터셋을 만드는 것은 많은 비용이 들다. Chain of thought이 거대 모델에서만 효과를 보이는데 비용적 측면에서 소형 모델에서도 추론 능력을 강화할 수 있는 방법을 찾는 것이 중요한 과제로 남는다.</p>

<h2 id="느낀점">느낀점</h2>

<p>Chain of thought 프롬프팅은 파인튜닝 없이 프롬프팅만으로 모델의 추론 성능을 극대화할 수 있는 의의를 가진다. 하지만, 여전히 거대 모델의 성능을 극대화 하는 것이지 소형 모델에서는 효과가 미미하며 이는 필연적으로 모델의 추론 능력은 파라미터 수에 비례함을 보인다. Chain of thought을 기점으로 프롬프팅의 중요성이 대두된 것 같고 프롬프팅을 제대로 하지 않으면 모델의 성능을 충분히 활용하지 못할 것 같다. 출력 토큰 수가 아니라 실제 의미 있는 자연어 논리 과정이 모델 출력에 영향을 준다고 하는데 중간 출력에서 나오는 의미가 최종 정답에도 어떻게 영향을 주는지를 더 알아보고 싶다.</p>]]></content><author><name>Jaewon Seo</name></author><category term="paper-review" /><category term="llm" /><category term="prompting" /><category term="reasoning" /><category term="chain-of-thought" /><summary type="html"><![CDATA[Jason Wei et al., NeurIPS 2022]]></summary></entry><entry><title type="html">Score-Based Generative Modeling through Stochastic Differential Equations</title><link href="https://ddungjae.github.io/posts/score-based-generative-modeling-through-sdes/" rel="alternate" type="text/html" title="Score-Based Generative Modeling through Stochastic Differential Equations" /><published>2025-02-06T00:00:00+09:00</published><updated>2025-02-06T00:00:00+09:00</updated><id>https://ddungjae.github.io/posts/score-based-generative-modeling-through-sdes</id><content type="html" xml:base="https://ddungjae.github.io/posts/score-based-generative-modeling-through-sdes/"><![CDATA[<p><a href="https://arxiv.org/pdf/2011.13456">https://arxiv.org/pdf/2011.13456</a></p>

<h2 id="1-introduction">1. Introduction</h2>

<ul>
  <li>Training data에 노이즈를 추가한 후, 그 노이즈를 제거하는 방법을 학습해 뛰어난 성과를 보인 생성 모델을 Score matching with Langevin dynamics(SMLD)와 Denoising diffusion probabilistic modeling(DDPM)에서 다루었다. 여기서, DDPM의 training objective는 각각의 noise scale에 대한 score를 계산하게 되고 이는 두 방법이 같은 방법을 사용한다는 것을 의미한다. 따라서, 두 가지 생성 모델의 방법 모두를 score-based generative model이라고 부르기로 한다.</li>
</ul>

<p><img src="/assets/images/score-based-generative-modeling-through-sdes/smld-ddpm-sde-overview.png" alt="" /></p>

<ul>
  <li>유한개의 노이즈 분포에 따라서 데이터에 노이즈를 추가하는 방법 대신에, 연속적인 노이즈 분포를 시간에 따라서 데이터에 추가하기로 한다(노이즈가 확산하는 것과 같아 diffusion이라 부른다). 이 과정에서 데이터 분포가 점진적으로 확산되어 노이즈로 분포가 되고, prescribed SDE의 형태로 나타나게 된다. 이 과정을 reverse해 random noise를 새로운 샘플을 만들어내도록 변형할 수 있다. 이러한 역과정은 reverse-time SDE를 만족하고, forward SDE로 부터 유도될 수 있다. 따라서, reverse-time SDE는 time-dependent neural network를 학습하는 방법을 통해 얻을 수 있고, numerical SDE solvers를 통해 샘플을 만들어낼 수 있게 된다.</li>
  <li>이와 같은 접근은 다음과 같은 장점을 가진다.
    <ul>
      <li>Flexible sampling and likelihood computation: 일반적인 SDE solver을 reverse-time SDE를 구하는데 사용할 수 있다.</li>
      <li>Controllable generation: 샘플을 만들어내는 과정을 학습 과정에서 얻을 수 없는 정보에 대해서도 수행할 수 있다. 이는 reverse-time SDE가 unconditional score에 대해서도 수행이 가능하게 하기 때문이다.</li>
      <li>Unified framework: SMLD와 DDPM을 통합하는 프레임워크를 제안한다.</li>
    </ul>
  </li>
</ul>

<h2 id="2-background">2. Background</h2>

<h3 id="21-denoising-score-matching-with-langevin-dynamicssmld">2.1 Denoising Score Matching with Langevin Dynamics(SMLD)</h3>

<ul>
  <li>\(p_\sigma(\tilde{x} \mid x) := \mathcal{N}(\tilde{x}; x, \sigma^2 I)\)를 perturbation kernel이라고 하자(노이즈을 추가하는 과정).
\(p_\sigma(\tilde{x}) := \int p_\text{data}(x) \, p_\sigma(\tilde{x} \mid x) \, dx\)에서 \(p_{data}(x)\)는 데이터의 분포를 나타낸다. \(\sigma_{min} = \sigma_1\)부터 \(\sigma_{max}=\sigma_L\)까지의 L개의 noise scale이 있다고 하자(증가하는 순서). 노이즈를 점진적으로 추가한다고 할 때 가장 작은 노이즈가 추가된 경우, \(p_{\sigma_{min}}\)는 초기 데이터, \(p_{data}\)와 거의 같고, 가장 많은 노이즈가 추가된 \(p_{\sigma_{max}}\)는 \(\mathcal{N}(x; 0, \sigma_{max}^2 I)\)를 따른다. Noise Conditional Score Network를 학습시키는데, 이는 weighted sum of denoising score matching objectives를 최소화 하는 방향으로 학습된다.</li>
</ul>

\[\theta^* := \arg \min_\theta \sum_{i=1}^N \sigma_i^2 \, \mathbb{E}_{p_\text{data}(x)} \mathbb{E}_{p_{\sigma_i}(\tilde{x} \mid x)}
\left[
\Vert{} s_\theta(\tilde{x}, \sigma_i) - \nabla_{\tilde{x}} \log p_{\sigma_i}(\tilde{x} \mid x) \Vert{}_2^2
\right]\]

<ul>
  <li>충분한 양의 데이터가 주어졌을 때, optimal score-based model은 모든 noise scale에 대하여 \(s_\theta^*(x, \sigma) \approx \nabla_x \log p_\sigma(x)\)를 만족한다. 샘플링을 위해서는, Langevin MCMC의 M 스텝에 대하여, 각각의 noise scale로부터 얻은 p의 추정치에 대해 다음과 같이 계산된다.</li>
</ul>

\[x_i^m = x_i^{m-1} + \epsilon_i s_\theta^*\left(x_i^{m-1}, \sigma_i\right) + \sqrt{2\epsilon_i} z_i^m, \quad m = 1, 2, \dots, M\]

<ul>
  <li>epsilon은 step size, z는 standard normal이고 위의 과정은 N부터 1까지 역순으로 진행된다. 즉, \(x_0^N \sim \mathcal{N}(x \mid 0, \sigma_\text{max}^2 I)\)로부터 initial distribution 방향으로 sample을 이동해 결국 initial distribution을 따르는 sample을 만들어낼 수 있게 된다.</li>
</ul>

<h3 id="22-denoising-diffusion-probabilistic-modelsddpm">2.2 Denoising Diffusion Probabilistic Models(DDPM)</h3>

<p><a href="/posts/understanding-diffusion-models-unified-perspective/">Understanding Diffusion Models: A Unified Perspective</a> 참고</p>

<h2 id="3-score-based-generative-modeling-with-sdes">3. Score-Based Generative Modeling with SDEs</h2>

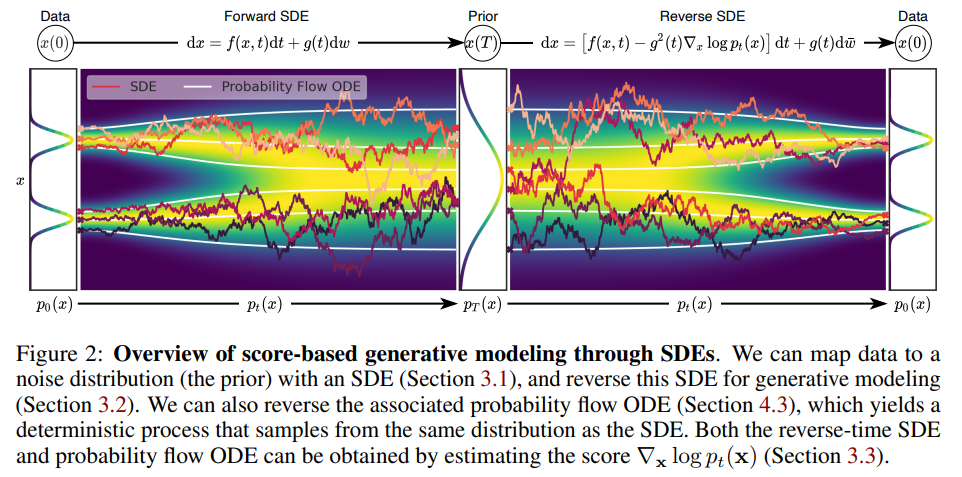
<p><img src="/assets/images/score-based-generative-modeling-through-sdes/sde-forward-reverse.png" alt="" /></p>

<h3 id="31-perturbing-data-with-sdes">3.1 Perturbing Data with SDEs</h3>

<ul>
  <li>time variable t에 대해서, T step에 대해 diffusion process를 구현하는 것을 목표로 한다. 즉, \(p_0\)은 data distribution이고, \(p_T\)는 prior distribution이다. Diffusion process는 다음과 같이 표현된다.</li>
</ul>

\[dx = f(x, t) \, dt + g(t) \, dW\]

<ul>
  <li>w는 standard Wiener process(=Brownian motion), f는 drift function이라고 불리는 vector valued function이다. g는 diffusion coefficient라고 불리는 scalar function이다. SDE는 globally Lipschitz할 때 unique strong solution을 가진다. \(x(s)\)부터 \(x(t)\)의 transition kernel을 나타내기 위해 \(p_{st}(x(t)\vert{}x(s))\)를 사용한다.</li>
</ul>

<h3 id="32-generating-samples-by-reversing-the-sde">3.2 Generating Samples by Reversing the SDE</h3>

<ul>
  <li>SDE로 diffusion process를 구현했는데, 역과정 또한 diffusion process로 생각할 수 있고, 그 과정은 reverse-time SDE로 나타낼 수 있다.</li>
</ul>

\[dx = [f(x, t) - g^2(t) \nabla_x \log p_t(x)] \, dt + g(t) \, d\bar{w}\]

<ul>
  <li>\(\bar{w}\)는 T부터 0까지 역방향으로 작용하는 standard Wiener process이고 dt는 infinitesimal negative timestep이다. 모든 t에 대하여, \(\nabla_x \log p_t(x)\)를 알 때, reverse diffusion process를 구현해 \(p_0\)를 얻을 수 있다.</li>
</ul>

<h3 id="33-estimating-scores-for-the-sde">3.3 Estimating Scores For the SDE</h3>

<ul>
  <li>Score distribution은 score-based model을 학습함으로써 추정할 수 있다. \(\nabla_x \log{p_t}(x)\)를 추정하기 위해 time-dependent score-based model을 학습한다.</li>
</ul>

\[\theta^* = \arg \min_\theta \mathbb{E}_t\left\{\lambda(t) \mathbb{E}_{x(0)}\mathbb{E}_{x(t)\mid x(0)}\left[\Vert{} s_\theta(x(t), t) - \nabla_{x(t)} \log p_{0t}(x(t)\mid x(0)) \Vert{}_2^2\right]\right\}\]

<ul>
  <li>lambda는 양의 실수 범위를 가지는 weighting function, t는 [0, T] 범위에서 uniformly sampled되었다. 충분한 양의 데이터와 model capacity가 있으면, score matching은 optimized되고, SMLD와 DDPM에서와 같이, \(\lambda(t) \propto 1/\mathbb{E} \left[ \Vert{} \nabla_{x(t)} \log p_{0t}(x(t)\mid x(0))\Vert{}_2^2 \right]\)를 선택할 수 있다. 이와 다른 score matching 방법을 선택할 수도 있다.</li>
</ul>

<h3 id="34-examples-ve-vp-sdes-and-beyond">3.4 Examples: VE, VP SDEs and Beyond</h3>

<ul>
  <li>SMLD와 DDPM의 noise perturbation 과정은 모두 SDE의 형태로 표현될 수 있다.
    <ul>
      <li>SMLD: \(x_i = x_{i-1} + \sqrt{\sigma_i^2 - \sigma_{i-1}^2} z_{i-1}, \quad i = 1, \dots, N\)
\(dx = \sqrt{ \frac{d[\sigma^2(t)] \,}{ dt}}dw\), 왼쪽의 수식에서 drift coefficient가 0이기 때문에 평균은 보존되고 분산은 계속해서 증가한다.</li>
      <li>DDPM: \(x_i = \sqrt{( 1 - \beta_i)} x_{i-1} + \sqrt{\beta_i} z_{i-1}, \quad i = 1, \dots, N\)
\(dx = -\frac{1}{2} \beta(t)x \, dt + \sqrt{ \beta(t)} \, dw\), 왼쪽의 수식에서 variance가 보존됨을 알 수 있다.</li>
    </ul>
  </li>
  <li>SMLD은 Variance Exploding(VE) SDE이고, DDPM은 Variance Preserving(VP) SDE이다.</li>
  <li>VP SDE에서 영감을 받아 논문의 저자들은 아래와 같은 SDE를 제안했다.</li>
</ul>

\[dx = -\frac{1}{2} \beta(t) x \, dt + \sqrt{\beta(t) \left( 1 - e^{-2 \int_0^t \beta(s) ds} \right)} dw\]

<ul>
  <li>위의 SDE에서의 variance는 항상 VP SDE의 variance로 bounded되기 때문에 위와 같은 SDE를 sub-VP SDE라고 부른다.</li>
</ul>

<h2 id="4-solving-the-reverse-sde">4. Solving the Reverse SDE</h2>

<ul>
  <li>Time dependent score-based model을 학습시킨 후, 우리는 reverse-time SDE를 구현한 후, 샘플을 만들기 위해 수치적으로 접근할 수 있다.</li>
</ul>

<h3 id="41-general-purpose-numerical-sde-solvers">4.1 General-Purpose Numerical SDE Solvers</h3>

<ul>
  <li>SDE를 푸는데 다양한 general-purpose numerical method가 존재한다(Euler-Maruyama, stochastic Runge-Kutta). 이러한 방법들 중 아무거나 reverse-time SDE를 푸는데 적용해 샘플을 만들어 내는데 사용할 수 있다. 저자들은 본 논문에서 forward SDE와 같은 방식으로 reverse-time SDE를 discretetize한 reverse diffusion sampler을 제안한다.</li>
</ul>]]></content><author><name>Jaewon Seo</name></author><category term="paper-review" /><category term="diffusion" /><category term="generative-models" /><summary type="html"><![CDATA[Yang Song et al., ICLR 2021]]></summary></entry><entry><title type="html">Understanding Diffusion Models: A Unified Perspective</title><link href="https://ddungjae.github.io/posts/understanding-diffusion-models-unified-perspective/" rel="alternate" type="text/html" title="Understanding Diffusion Models: A Unified Perspective" /><published>2025-02-03T00:00:00+09:00</published><updated>2025-02-03T00:00:00+09:00</updated><id>https://ddungjae.github.io/posts/understanding-diffusion-models-unified-perspective</id><content type="html" xml:base="https://ddungjae.github.io/posts/understanding-diffusion-models-unified-perspective/"><![CDATA[<p><a href="https://arxiv.org/pdf/2208.11970">arxiv.org</a></p>

<h2 id="background-elbo-vae-and-hierarchical-vae">Background: ELBO, VAE, and Hierarchical VAE</h2>

<h3 id="evidence-lower-bound">Evidence Lower Bound</h3>

\[p(x) = \int p(x,z)dz\]

<ul>
  <li>Latent Variable: 잠재 변수</li>
  <li>x라는 observed data, z라는 latent variable에 대해서 x의 확률 분포를 위의 그림과 같이 쓸 수 있다. 위의 표현은 Chain Rule of Probability를 사용해 다음과 같이 나타낼 수도 있다.</li>
</ul>

\[p(x) = \frac{p(x,z)}{p(z|x)}\]

<ul>
  <li>우리가 x의 확률 분포를 구하고자 할 때 이를 직접 구하는 것에는 어려움이 있다. 왜냐하면 x의 확률 분포는 latent variable과 연관이 되어 있고(위의 식에서 x에 대한 z의 조건부 확률을 알아야 한다) latent variable은 우리가 쉽게 찾을 수 없다. 따라서 우리는 x의 확률 분포를 가장 잘 나타내는 식을 추정해야 한다. 이 방법으로 ELBO가 있는 것이다. x의 확률에 로그를 씌운 값은 다음과 같은 대소 관계를 가진다. Lower Bound를 가지는 셈인데 Lower Bound를 최대화 하기로 한다.</li>
</ul>

\[\begin{align*}\log p(\mathbf{x}) &amp;= \log \int p(\mathbf{x}, \mathbf{z}) \, d\mathbf{z} \quad &amp;\text{(Apply Equation 1)} \\&amp;= \log \int \frac{p(\mathbf{x}, \mathbf{z}) q_\phi(\mathbf{z} \mid \mathbf{x})}{q_\phi(\mathbf{z} \mid \mathbf{x})} \, d\mathbf{z} \quad &amp;\text{(Multiply by 1 = } \frac{q_\phi(\mathbf{z} \mid \mathbf{x})}{q_\phi(\mathbf{z} \mid \mathbf{x})} \text{)} \\&amp;= \log \mathbb{E}_{q_\phi(\mathbf{z} \mid \mathbf{x})} \left[ \frac{p(\mathbf{x}, \mathbf{z})}{q_\phi(\mathbf{z} \mid \mathbf{x})} \right] \quad &amp;\text{(Definition of Expectation)} \\&amp;\geq \mathbb{E}_{q_\phi(\mathbf{z} \mid \mathbf{x})} \left[ \log \frac{p(\mathbf{x}, \mathbf{z})}{q_\phi(\mathbf{z} \mid \mathbf{x})} \right] \quad &amp;\text{(Apply Jensen's Inequality)}\end{align*}\]

<ul>
  <li>위의 식에서 q(x에 대한 z의 조건부 확률의 추정치)는 우리가 실제로 구하기 어려운 값이다. 그래서 이 값을 매개화 해서 구할 것이고 ELBO를 최대화할 수 있는 파라미터를 찾을 것이다. 위의 과정을 통해서 Lower Bound가 설정되었다. Jensen’s Inequality는 아래와 같은 관계를 나타내는 수식이다.</li>
</ul>

\[f(E[X]) ≥ E[f(X)]\]

<ul>
  <li>하지만 위의 관계식 만으로는 ELBO에 대한 정보를 충분히 얻을 수 없다. 왜 이것이 실제로 Lower Bound가 되는지, 왜 이 값을 maximize 해야 하는지를 알 수 없다. 그래서 위의 식을 다음과 같이 나타내면 그 답을 얻을 수 있다.</li>
</ul>

\[\begin{align*}\log p(\mathbf{x}) &amp;= \log \int \frac{p(\mathbf{x}, \mathbf{z})}{q_\phi(\mathbf{z} \mid \mathbf{x})} q_\phi(\mathbf{z} \mid \mathbf{x}) \, d\mathbf{z} \quad &amp;\text{(Multiply by 1 = } \int q_\phi(\mathbf{z} \mid \mathbf{x}) \, d\mathbf{z}) \\&amp;= \int q_\phi(\mathbf{z} \mid \mathbf{x}) (\log p(\mathbf{x})) \, d\mathbf{z} \quad &amp;\text{(Bring evidence into integral)} \\&amp;= \mathbb{E}_{q_\phi(\mathbf{z} \mid \mathbf{x})} [\log p(\mathbf{x})] \quad &amp;\text{(Definition of Expectation)} \\&amp;= \mathbb{E}_{q_\phi(\mathbf{z} \mid \mathbf{x})} \left[ \log \frac{p(\mathbf{x}, \mathbf{z})}{p(\mathbf{z})} \right] \quad &amp;\text{(Apply Equation 2)} \\&amp;= \mathbb{E}_{q_\phi(\mathbf{z} \mid \mathbf{x})} \left[ \log \frac{p(\mathbf{x}, \mathbf{z}) q_\phi(\mathbf{z} \mid \mathbf{x})}{p(\mathbf{z}) q_\phi(\mathbf{z} \mid \mathbf{x})} \right] \quad &amp;\text{(Multiply by 1 = } \frac{q_\phi(\mathbf{z} \mid \mathbf{x})}{q_\phi(\mathbf{z} \mid \mathbf{x})}) \\&amp;= \mathbb{E}_{q_\phi(\mathbf{z} \mid \mathbf{x})} \left[ \log \frac{p(\mathbf{x}, \mathbf{z})}{q_\phi(\mathbf{z} \mid \mathbf{x})} \right] + \mathbb{E}_{q_\phi(\mathbf{z} \mid \mathbf{x})} \left[ \log \frac{q_\phi(\mathbf{z} \mid \mathbf{x})}{p(\mathbf{z} \mid \mathbf{x})} \right] \quad &amp;\text{(Split the Expectation)} \\&amp;= \mathbb{E}_{q_\phi(\mathbf{z} \mid \mathbf{x})} \left[ \log \frac{p(\mathbf{x}, \mathbf{z})}{q_\phi(\mathbf{z} \mid \mathbf{x})} \right] + D_{\text{KL}}(q_\phi(\mathbf{z} \mid \mathbf{x}) \parallel p(\mathbf{z} \mid \mathbf{x})) \quad &amp;\text{(Definition of KL Divergence)} \\&amp;\geq \mathbb{E}_{q_\phi(\mathbf{z} \mid \mathbf{x})} \left[ \log \frac{p(\mathbf{x}, \mathbf{z})}{q_\phi(\mathbf{z} \mid \mathbf{x})} \right] \quad &amp;\text{(KL Divergence always } \geq 0)\end{align*}\]

<ul>
  <li>여기서 KL Divergence는 두 확률 분포가 얼마나 차이를 보이는지에 대한 지표이다.</li>
</ul>

\[D_{\text{KL}}(P || Q) = \sum_x P(x) \log \frac{P(x)}{Q(x)}\]

<ul>
  <li>위의 식에서 x에 대한 확률은 ELBO 항과 KL Divergence 항으로 나타난다. 이때 KL Divergence가 항상 0보다 크기 때문에 Lower Bound가 설정이 된다. 위의 식에서 KL Divergence가 0이 된다는 의미는 두 확률 분포가 같음을 의미하며 variational posterior q가 실제 z의 사후 분포인 p와 동일해지는 것과 같다. 실제 사후 분포를 구하기 어려우니 이를 variational posterior으로 나타내고자 하는 것이고 variational posterior가 실제 사후 분포와 유사할수록 KL Divergence는 작아진다. ELBO를 최대화 하는 것은 곧 latent variable인 z의 분포를 정확하게 알 수 있음과 같다.</li>
</ul>

<h3 id="variational-autoencoders">Variational Autoencoders</h3>

\[\begin{align}\mathbb{E}_{q_\phi(z|x)} \left[ \log \frac{p(x, z)}{q_\phi(z|x)} \right] &amp;= \mathbb{E}_{q_\phi(z|x)} \left[ \log \frac{p_\theta(x|z) p(z)}{q_\phi(z|x)} \right] \quad \text{(Chain Rule of Probability)} \\&amp;= \mathbb{E}_{q_\phi(z|x)} \left[ \log p_\theta(x|z) \right] + \mathbb{E}_{q_\phi(z|x)} \left[ \log \frac{p(z)}{q_\phi(z|x)} \right] \quad \text{(Split the Expectation)} \\&amp;= \underbrace{\mathbb{E}_{q_\phi(z|x)} \left[ \log p_\theta(x|z) \right]}_{\text{reconstruction term}} - \underbrace{D_{\text{KL}}(q_\phi(z|x) \| p(z))}_{\text{prior matching term}} \quad \text{(Definition of KL Divergence)}.\end{align}\]

<ul>
  <li>이전까지 우리는 가장 분포를 잘 설명하는 variational posterior을 구하기 위해 왜 ELBO를 최대화 해야 하는지를 알아보았다. 그러면 ELBO를 더 잘 해석하기 위해 위와 같이 reconstruction term과 prior matching term으로 분해했다. KL Divergence 값은 항상 0보다 크기 때문에 ELBO를 최대화 하려면 reconstruction term은 최대화, prior matching term은 최소화를 해야 한다. 각각의 term은 무슨 의미를 가지고 있을까?</li>
  <li>각각의 term의 의미를 알아보기 전에 q, p가 위의 식에서 어떤 기능을 하는지 알아야 한다. \(q_\phi(z\vert{}x)\)는 encoder로 input인 x를 가능한 latent에 대하여 transform 한다. \(p_\theta(x\vert{}z)\)는 decoder로 latent z로부터 x를 복원(재구성)한다.</li>
  <li>reconstruction term은 말 그대로 decoder가 latent로부터 얼마나 잘 재현되는지를 측정한다. prior matching term은 학습된 z에 대한 variational distribution이 얼마나 이전의 정보와 일치하는지를 측정한다.</li>
  <li>ELBO는 파라미터 φ 와 θ를 통해 매개화된다. encoder은 주로 multivariate Gaussian을 따르도록 선택이 되며, prior은 standard multivariate Gaussian을 따르도록 선택된다.</li>
</ul>

\[q_\phi(z|x) = \mathcal{N}(z; \mu_\phi(x), \sigma_\phi^2(x)\mathbf{I}) \\
p(z) = \mathcal{N}(z; 0, \mathbf{I})\]

<ul>
  <li>ELBO의 KL Divergence term은 몬테카를로 방법을 통해 추정할 수 있다.</li>
</ul>

\[\int f(x) p(x) \, dx  \approx \frac{1}{N} \sum_{i=1}^{N} f(x_i) \ \ Monte\ Carlo \ estimation\]

\[\arg \max_{\phi, \theta} \mathbb{E}_{q_\phi(z|x)} \left[ \log p_\theta(x|z) \right] - D_{\text{KL}}(q_\phi(z|x) \| p(z)) \approx \arg \max_{\phi, \theta} \sum_{l=1}^{L} \log p_\theta(x|z^{(l)}) - D_{\text{KL}}(q_\phi(z|x) \| p(z))\]

<ul>
  <li>몬테카를로 방법으로 ELBO를 위와 같이 표현할 수 있다. 하지만 각각의 latent z는 확률적으로 선택이 되고 이는 미분 가능하지 않다는 문제가 발생한다. 하지만 이를 재매개화(reparameterization) 방법을 통해 해결할 수 있다. 임의의 Gaussian Distribution은 Normal Distribution이 평균 만큼 shift된 것으로 생각할 수 있고 아래와 같이 쓸 수 있다.</li>
</ul>

\[z = \mu_\phi(x) + \sigma_\phi(x) \odot \epsilon \quad \text{with} \quad \epsilon \sim \mathcal{N}(\epsilon; 0, \mathbf{I})\]

<h3 id="hierarchical-variational-autoencoders">Hierarchical Variational Autoencoders</h3>

<ul>
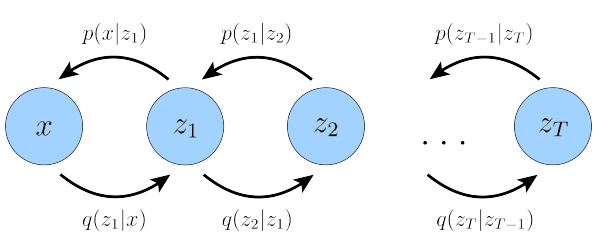
  <li>HVAE는 VAE의 일반화된 형태로 latent variable 간에 계층(hierarchical) 관계가 있음을 나타낸다. 여기서는 latent variable이 더 복잡하고, 추상적인 higher level latent로부터 생성되었다고 본다.</li>
</ul>

<p><img src="/assets/images/understanding-diffusion-models-unified-perspective/hvae-structure.png" alt="HVAE의 구조" /></p>

<ul>
  <li>위의 과정은 마르코프 성질을 가지기 때문에 오직 이전 state의 영향만을 받으며 latent가 생성된다. 정방향과 역방향 과정 q, p에 대하여 다음과 같은 성질이 있다.</li>
</ul>

\[p(x, z_{1:T}) = p(z_T) p_\theta(x | z_1) \prod_{t=2}^{T} p_\theta(z_{t-1} | z_t)\]

\[q_\phi(z_{1:T} | x) = q_\phi(z_1 | x) \prod_{t=2}^{T} q_\phi(z_t | z_{t-1})\]

<ul>
  <li>이를 적용해 ELBO를 다시 표현할 수 있다.</li>
</ul>

\[\begin{aligned}
&amp;\log p(x) = \log \int p(x, z_{1:T}) \, dz_{1:T} \\
&amp;= \log \int \frac{p(x, z_{1:T}) q_\phi(z_{1:T} | x)}{q_\phi(z_{1:T} | x)} \, dz_{1:T} \quad \text{(Multiply by 1 = } \frac{q_\phi(z_{1:T} | x)}{q_\phi(z_{1:T} | x)}\text{)} \\
&amp;= \log \mathbb{E}_{q_\phi(z_{1:T} | x)} \left[ \frac{p(x, z_{1:T})}{q_\phi(z_{1:T} | x)} \right] \quad \text{(Definition of Expectation)} \\
&amp;\geq \mathbb{E}_{q_\phi(z_{1:T} | x)} \left[ \log \frac{p(x, z_{1:T})}{q_\phi(z_{1:T} | x)} \right] \quad \text{(Apply Jensen's Inequality)}
\end{aligned}\]

\[\mathbb{E}_{q_\phi(z_{1:T} | x)} \left[ \log \frac{p(x, z_{1:T})}{q_\phi(z_{1:T} | x)} \right] = \mathbb{E}_{q_\phi(z_{1:T} | x)} \left[ \log \frac{p(z_T) p_\theta(x | z_1) \prod_{t=2}^{T} p_\theta(z_{t-1} | z_t)} {{q_\phi(z_1 | x)}{\prod_{t=2}^{T} q_\phi(z_t | z_{t-1})}} \right]\]

<ul>
  <li>이제 지금까지 정리한 내용을 이용해 Variational Diffusion Model을 분석할 수 있다.</li>
</ul>

<h2 id="variational-diffusion-models">Variational Diffusion Models</h2>

<p><img src="/assets/images/understanding-diffusion-models-unified-perspective/variational-diffusion-model.png" alt="Variational Diffusion Model의 forward/reverse process" /></p>

<ul>
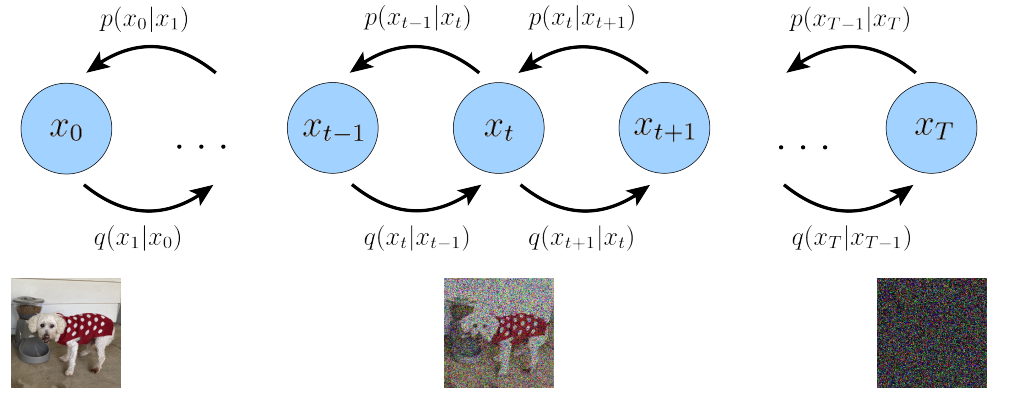
  <li>디퓨전 모델은 노이즈를 추가하는 과정이 분자의 확산과 유사하다고 해서 디퓨전이라는 이름이 붙었다. 어떤 이미지가 있다고 했을 때, 이미지의 각 픽셀에 노이즈를 추가한다. 매 state마다 노이즈를 추가하며 원래 이미지의 특성을 점점 줄여나간다. 우리의 목표는 노이즈가 추가된 이미지에서 원래 이미지를 복원하는 것이다. 노이즈 추가의 과정은 일정 규칙에 따라 이루어진다. 하지만 노이즈가 추가된 상태에서 노이즈가 추가되기 전 상태인 이전 상태로 돌아가는 것은 어렵다. 그러면 노이즈를 제거하며 이전 상태를 복원하는 과정을 어떻게 할 수 있을까?</li>
  <li>디퓨전 모델은 MHVAE가 3가지 restriction을 가지고 있는 상태라고 생각할 수 있다.
    <ul>
      <li>The latent dimension is exactly equal to the data dimension</li>
      <li>The structure of the latent encoder at each timestep is not learned; it is pre-defined as a linear Gaussian model. In other words, it is a Gaussian distribution centered around the output of the previous timestep</li>
      <li>The Gaussian parameters of the latent encoders vary over time in such a way that the distribution of the latent at final timestep T is a standard Gaussian</li>
    </ul>
  </li>
  <li>2번 조건에서 encoder는 pre-defined되어 있으며 이전 state 근방에 분포한 Gaussian 분포로 다음 state가 정의된다고 한다. 아래 식을 보면 다음 state의 분포가 이전 state로 정의되는 것을 볼수 있다. 여기서 alpha가 커지면 이전 state와 유사한 분포를 가지고, alpha가 작아지면 standard Gaussian에 가까워지는 것을 볼 수 있다. encoder은 노이즈를 추가하는 과정이다. alpha 값에 따라서 노이즈를 얼마나 추가하며, 이전 state 상태를 얼마나 보존할지를 선택할 수 있는 것이다.</li>
</ul>

\[q(x_t | x_{t-1}) = \mathcal{N} \left( x_t; \sqrt{\alpha_t} x_{t-1}, (1 - \alpha_t) \mathbf{I} \right)\]

<ul>
  <li>3번 조건에서 마지막 state에서 x의 분포는 standard Gaussian을 따른다고 한다. p는 decoder로 노이즈를 제거하는 과정이라고 생각할 수 있다. 이 과정 역시 마르코프 성질을 따르기에 아래와 같은 형태로 쓸 수 있다.</li>
</ul>

\[p(x_{0:T}) = p(x_T) \prod_{t=1}^{T} p_\theta(x_{t-1} | x_t)\]

<ul>
  <li>정리하자면 encoder은 노이즈를 추가하는 과정, decoder은 standard Gaussian을 따르는 final state에서 노이즈를 점점 제거하는 과정이라고 볼 수 있다. 이때 encoder은 우리가 정의를 해서 사용한다. 각각의 timestep에서 이전 state의 특성을 얼마나 반영해 다음 state를 정의하는지를 앞서 다룬 바 있다. 하지만 decoder의 경우, 우리가 아는 것이 없다. 당연히도 이미지에 노이즈를 추가하는 것은 쉽지만 노이즈가 추가된 이미지에서 원래 이미지를 복원하는 것은 어려울 것이다(실제 확산 현상과 연관지어 생각해 본다면 물병에 떨어트린 물감을 다시 물과 물감으로 분리하는 것은 어렵다는 것과 유사하다고 볼 수 있다). 결국에 standard Gaussian상태에서 순차적인 denoising을 통해 initial state로 복원해 줄 수 있는 p를 추정하는 것이 목표이다. 이 과정에서 ELBO가 다시 등장한다.</li>
</ul>

<p><img src="/assets/images/understanding-diffusion-models-unified-perspective/elbo-three-terms.png" alt="ELBO를 reconstruction/prior matching/consistency term으로 분해" /></p>

\[\begin{aligned}\log p(x) &amp;= \log Z \int p(x_{0:T}) \, dx_{1:T} \\&amp;= \log Z \int \frac{p(x_{0:T}) q(x_{1:T} | x_0)}{q(x_{1:T} | x_0)} \, dx_{1:T} \\&amp;= \log \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \frac{p(x_{0:T})}{q(x_{1:T} | x_0)} \right] \\&amp;\geq \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \log \frac{p(x_{0:T})}{q(x_{1:T} | x_0)} \right] \\&amp;= \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \log p(x_T) \prod_{t=1}^{T} p_\theta(x_{t-1} | x_t) \prod_{t=1}^{T} q(x_t | x_{t-1}) \right] \\&amp;= \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \log p(x_T) p_\theta(x_0 | x_1) \prod_{t=2}^{T} p_\theta(x_{t-1} | x_t) q(x_T | x_{T-1}) \prod_{t=1}^{T-1} q(x_t | x_{t-1}) \right] \\&amp;= \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \log p(x_T) p_\theta(x_0 | x_1) \prod_{t=1}^{T-1} p_\theta(x_t | x_{t+1}) q(x_T | x_{T-1}) \prod_{t=1}^{T-1} q(x_t | x_{t-1}) \right] \\&amp;= \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \log p(x_T) p_\theta(x_0 | x_1) \frac{q(x_T | x_{T-1})}{q(x_T | x_{T-1})} \prod_{t=1}^{T-1} \frac{p_\theta(x_t | x_{t+1})}{q(x_t | x_{t-1})} \right] \\&amp;= \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \log p_\theta(x_0 | x_1) \right] + \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \log \frac{p(x_T)}{q(x_T | x_{T-1})} \right] \\&amp;\quad + \sum_{t=1}^{T-1} \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \log \frac{p_\theta(x_t | x_{t+1})}{q(x_t | x_{t-1})} \right] \\&amp;= \mathbb{E}_{q(x_1 | x_0)} \left[ \log p_\theta(x_0 | x_1) \right] + \mathbb{E}_{q(x_T | x_{T-1})} \left[ \log \frac{p(x_T)}{q(x_T | x_{T-1})} \right] \\&amp;\quad + \sum_{t=1}^{T-1} \mathbb{E}_{q(x_{t-1}, x_t, x_{t+1} | x_0)} \left[ \log \frac{p_\theta(x_t | x_{t+1})}{q(x_t | x_{t-1})} \right] \\&amp;= \mathbb{E}_{q(x_1 | x_0)} \left[ \log p_\theta(x_0 | x_1) \right] \quad \text{(reconstruction term)} \\&amp;\quad - \mathbb{E}_{q(x_{T-1} | x_0)} \left[ D_{\text{KL}}(q(x_T | x_{T-1}) \| p(x_T)) \right] \quad \text{(prior matching term)} \\&amp;\quad - \sum_{t=1}^{T-1} \mathbb{E}_{q(x_{t-1}, x_t, x_{t+1} | x_0)} \left[ D_{\text{KL}}(q(x_t | x_{t-1}) \| p_\theta(x_t | x_{t+1})) \right] \quad \text{(consistency term)}\end{aligned}\]

<ul>
  <li>최종 결과에서 3개의 term이 나온다. 각각의 term이 무슨 의미를 가지는지, 또 어떻게 되어야 하는지를 알아보자
    <ul>
      <li>reconstruction term: state1에 대한 state0의 로그 확률을 나타낸다. 이 term은 vanilla VAE에도 등장을 하고 유사하게 학습될 수 있다.</li>
      <li>prior matching term: 이 term은 final state가 이전 state의 Gaussian을 따를 때 minimized된다. 우리가 충분히 노이즈를 추가했을 때 final state는 standard Gaussian을 따른다고 했고 T가 충분히 크다면 q, p가 모두 standard Gaussian을 따르기 때문에 이 term은 0이 된다.
        <ul>
          <li>
            <p>아래의 식에서 final state에서 alpha값은 0으로 가기 때문에 standard Gaussian으로 가게 된다.</p>

\[q(x_t | x_{t-1}) = \mathcal{N} \left( x_t; \sqrt{\alpha_t} x_{t-1}, (1 - \alpha_t) \mathbf{I} \right)\]
          </li>
        </ul>
      </li>
      <li>consistency term: 이 term은 각 항에서 p가 q를 따를 때 최소화된다. 우리는 위의 식을 알고 있기에 p가 위의 Gaussian을 따르도록 train 한다면 이 term이 최소화된다.</li>
    </ul>
  </li>
  <li>우리는 consistency term을 0으로 만들도록 decoder을 학습시켜야 한다. 이는 Monte Carlo 방법으로 수행될 수 있으나 suboptimal할 수 있다. 그 이유는 consistency term에서 \(x_{t-1}, x_{t+1}\)이라는 두 random variable에 대한 expectation을 계산해야 하기 때문에 하나의 random variable을 가지고 expectation을 계산하는 것보다 variation이 커지게 된다. 그러면 ELBO를 하나의 random variable만으로 표현하는 방법을 찾을 수 있다. 그 과정은 아래의 equation에서 시작한다.</li>
</ul>

\[q(x_t | x_{t-1}) = q(x_t | x_{t-1}, x_0)\]

<ul>
  <li>위 equation을 Bayes rule에 따라 다음과 같이 바꿀 수 있다.</li>
</ul>

\[q(x_t | x_{t-1}, x_0) = \frac {q(x_{t-1} | x_t, x_0) q(x_t | x_0)} {q(x_{t-1} | x_0)}\]

<ul>
  <li>이를 적용해 ELBO를 다시 쓸 수 있다.</li>
</ul>

\[\begin{aligned}\log p(x) &amp;\geq \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \log \frac{p(x_{0:T})}{q(x_{1:T} | x_0)} \right] \\&amp;= \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \log p(x_T) \prod_{t=1}^{T} p_\theta(x_{t-1} | x_t) \prod_{t=1}^{T} q(x_t | x_{t-1}) \right] \\&amp;= \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \log p(x_T) p_\theta(x_0 | x_1) \prod_{t=2}^{T} p_\theta(x_{t-1} | x_t) q(x_1 | x_0) \prod_{t=2}^{T} q(x_t | x_{t-1}, x_0) \right] \\&amp;= \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \log p_\theta(x_T) p_\theta(x_0 | x_1) q(x_1 | x_0) + \log \prod_{t=2}^{T} p_\theta(x_{t-1} | x_t) q(x_{t-1} | x_t, x_0) q(x_t | x_0) \right] \\&amp;= \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \log p(x_T) p_\theta(x_0 | x_1) q(x_1 | x_0) + \sum_{t=2}^{T} \log p_\theta(x_{t-1} | x_t) q(x_{t-1} | x_t, x_0) \frac{q(x_t | x_0)}{q(x_{t-1} | x_0)} \right] \\&amp;= \mathbb{E}_{q(x_{1:T} | x_0)} \left[ \log p(x_T) p_\theta(x_0 | x_1) q(x_1 | x_0) + \sum_{t=2}^{T} \log p_\theta(x_{t-1} | x_t) \frac{q(x_{t-1} | x_t, x_0)}{q(x_{t-1} | x_0)} \right] \\&amp;= \mathbb{E}_{q(x_1 | x_0)} \left[ \log p_\theta(x_0 | x_1) \right] + \mathbb{E}_{q(x_T | x_0)} \left[ \log \frac{p(x_T)}{q(x_T | x_0)} \right] \\&amp;\quad + \sum_{t=2}^{T} \mathbb{E}_{q(x_{t-1}, x_t | x_0)} \left[ \log \frac{p_\theta(x_{t-1} | x_t)}{q(x_{t-1} | x_t, x_0)} \right] \\&amp;= \mathbb{E}_{q(x_1 | x_0)} \left[ \log p_\theta(x_0 | x_1) \right] + \mathbb{E}_{q(x_T | x_0)} \left[ \log \frac{p(x_T)}{q(x_T | x_0)} \right] \\&amp;\quad + \sum_{t=2}^{T} \mathbb{E}_{q(x_t, x_{t-1} | x_0)} \left[ \log \frac{p_\theta(x_{t-1} | x_t)}{q(x_{t-1} | x_t, x_0)} \right] \\&amp;= \mathbb{E}_{q(x_1 | x_0)} \left[ \log p_\theta(x_0 | x_1) \right] \quad \text{(reconstruction term)} \\&amp;\quad - D_{\text{KL}}\left( q(x_T | x_0) \| p(x_T) \right) \quad \text{(prior matching term)} \\&amp;\quad - \sum_{t=2}^{T} \mathbb{E}_{q(x_t | x_0)} \left[ D_{\text{KL}}\left( q(x_{t-1} | x_t, x_0) \| p_\theta(x_{t-1} | x_t) \right) \right] \quad \text{(denoising matching term)}\end{aligned}\]

<ul>
  <li>위와 같은 표현 방식은 하나의 random variable만을 사용해 variance가 작다. 역시나 3개의 term으로 구성되어 있다.
    <ul>
      <li>reconstruction term: 동일</li>
      <li>prior matching term: 이 term은 이전 방식과 약간 표현이 다르기는 하지만 trainable parameter가 없으며 q, p 모두 standard Gaussian을 따르기 때문에 0이 된다.</li>
      <li>
        <p>denoising matching term: q에 대한 표현에 변화가 생겼다. 우리는 \(q(x_{t}\vert{}x_{t-1}, x_0)\)은 잘 알고 있다. \(q(x_{t-1}\vert{}x_{t}, x_0)\)은 해석이 필요하다. 직관적으로 봤을 때 노이즈를 추가하는 과정의 반대 이므로 노이즈를 제거하는 과정이라고 생각할 수 있다.</p>

\[q(x_{t-1} | x_t, x_0) = \frac { q(x_t | x_{t-1}, x_0)q(x_{t-1} | x_0)} {q(x_{t} | x_0)}\]
      </li>
    </ul>
  </li>
  <li>Bayes rule을 통해 위와 같은 관계를 얻을 수 있다. \(q(x_{t}\vert{}x_{t-1}, x_0)\)은 Gaussian Distribution을 따른다는 것을 알고 있고 \(q(x_{t-1}\vert{}x_0)\), \(q(x_{t}\vert{}x_0)\)을 알아야 한다. 이때 \(x_{t}\)가 \(q(x_{t}\vert{}x_{t-1})\)와 같은 분포를 따름을 알고 다음과 같이 쓸 수 있다. encoder에서 mean과 variance를 이전 state로 정의했고 이를 multivariate Gaussian 형태로 쓴 것이다.</li>
</ul>

\[x_t = \sqrt{\alpha_t} x_{t-1} + \sqrt{1 - \alpha_t} \epsilon, \quad \epsilon \sim \mathcal{N}(\epsilon; 0, I)\]

<ul>
  <li>위의 수식을 연쇄적으로 쓴다면 \(x_0\)로 나타낼 수 있게 된다.</li>
</ul>

\[\begin{aligned}
&amp;x_t = \sqrt{\alpha_t} x_{t-1} + \sqrt{1 - \alpha_t} \epsilon_{t-1} \\
&amp;= \sqrt{\alpha_t \alpha_{t-1}} x_{t-2} + \sqrt{\alpha_t - \alpha_t \alpha_{t-1}} \epsilon_{t-2} + \sqrt{1 - \alpha_t} \epsilon_{t-1} \\
&amp;= \sqrt{\alpha_t \alpha_{t-1}} x_{t-2} + \sqrt{1 - \alpha_t \alpha_{t-1}} \epsilon_{t-2} \\
&amp;= \dots \\
&amp;= \sqrt{\bar{\alpha}_t} x_0 + \sqrt{1 - \bar{\alpha}_t} \epsilon_0 \\
&amp;\sim \mathcal{N}(x_t; \sqrt{\bar{\alpha}_t} x_0, (1 - \bar{\alpha}_t) I)\\
&amp;\bar{\alpha} = \prod_{i=1}^{T} \alpha_i
\end{aligned}\]

<ul>
  <li>이제 위의 결과를 이용해 \(q(x_{t-1} \vert{} x_t, x_0)\)의 분포를 얻을 수 있다. \(q(x_{t} \vert{} x_{t-1}, x_0)\), \(q(x_{t-1} \vert{} x_0)\), \(q(x_{t} \vert{} x_0)\) 모두 Gaussian Distribution을 따르고 다음의 관계를 따른다.</li>
</ul>

\[\begin{align*}q(x_{t-1} | x_t, x_0) &amp;= \frac{q(x_t | x_{t-1}, x_0) q(x_{t-1} | x_0)}{q(x_t | x_0)} &amp;\propto \mathcal{N} \left( x_{t-1}; \underbrace{\frac{\sqrt{\alpha_t} (1 - \bar{\alpha}_{t-1}) x_t + \sqrt{\bar{\alpha}_{t-1}} (1 - \alpha_t) x_0}{1 - \bar{\alpha}_t}}_{\mu_q(x_t, x_0)}, \underbrace{\frac{(1 - \alpha_t)(1 - \bar{\alpha}_{t-1})}{1 - \bar{\alpha}_t}I}_{\Sigma_q(t)} \right)\end{align*}\]

<ul>
  <li>\(q(x_{t-1} \vert{} x_t, x_0)\)가 Gaussian Distribution을 따르는 것을 알았기 때문에 decoder 또한 Gaussian Distribution을 따르게 추정하는 것이 적합하다고 판단할 수 있다. 하지만 decoder \(p_{\theta}(x_{t-1} \vert{} x_t)\)는 \(x_0\)에 대해 표현되지 않는다. 일단은 두 분포간의 KL Divergence를 최소화해야 하고 두 분포 모두 Gaussian임은 알고 있다. Gaussian Distribution간의 KL Divergence는 아래와 같이 계산할 수 있다. 이를 적용해 KL Divergence를 최소화하는 decoder를 찾을 수 있다.</li>
</ul>

\[\begin{align*}D_{KL}(\mathcal{N}(x; \mu_x, \Sigma_x) \, \| \, \mathcal{N}(y; \mu_y, \Sigma_y)) = \frac{1}{2} \left[ \log \frac{|\Sigma_y|}{|\Sigma_x|} - d + \text{tr}(\Sigma_y^{-1} \Sigma_x) + (\mu_y - \mu_x)^T \Sigma_y^{-1} (\mu_y - \mu_x) \right]\end{align*}\]

\[\begin{align*}\arg\min_{\theta} D_{KL}(q(x_{t-1} \mid x_t, x_0) \, \| \, p_\theta(x_{t-1} \mid x_t)) &amp;= \arg\min_{\theta} D_{KL}(\mathcal{N}(x_{t-1}; \mu_q, \Sigma_q(t)) \, \| \, \mathcal{N}(x_{t-1}; \mu_\theta, \Sigma_q(t))) \\&amp;= \arg\min_{\theta} \frac{1}{2} \left[ \log \frac{|\Sigma_q(t)|}{|\Sigma_q(t)|} - d + \text{tr}(\Sigma_q(t)^{-1} \Sigma_q(t)) + (\mu_\theta - \mu_q)^T \Sigma_q(t)^{-1} (\mu_\theta - \mu_q) \right] \\&amp;= \arg\min_{\theta} \frac{1}{2} \left[ \log 1 - d + d + (\mu_\theta - \mu_q)^T \Sigma_q(t)^{-1} (\mu_\theta - \mu_q) \right] \\&amp;= \arg\min_{\theta} \frac{1}{2} (\mu_\theta - \mu_q)^T \Sigma_q(t)^{-1} (\mu_\theta - \mu_q) \\&amp;= \arg\min_{\theta} \frac{1}{2} \left[ (\mu_\theta - \mu_q)^T (\sigma_q^2(t) I)^{-1} (\mu_\theta - \mu_q) \right] \\&amp;= \arg\min_{\theta} \frac{1}{2 \sigma_q^2(t)} \| \mu_\theta - \mu_q \|_2^2\end{align*}\]

<ul>
  <li>KL Divergence를 두 분포의 평균으로 나타내었다. encoder 분포에서의 평균은 위에서 구했었다. decoder는 앞서 \(x_0\)에 conditional하지 않다고 했었고 따라서 이 값을 estimator을 이용해 표현해야 한다. \(\hat{x}_\theta(x_t, t)\)은 노이즈가 추가된 상태인 \(x_t\)의 초기 상태 \(x_0\)에 대한 값을 \(x_t\)로 매개화한 값이다.</li>
</ul>

\[\begin{aligned}
&amp;\mu_q(x_t, x_0) = \frac{\sqrt{\alpha_t (1 - \bar{\alpha}_{t-1})} x_t + \sqrt{\bar{\alpha}_{t-1} (1 - \alpha_t)} x_0}{1 - \bar{\alpha}_t}\\
&amp;\mu_\theta(x_t, t) = \frac{\sqrt{\alpha_t (1 - \bar{\alpha}_{t-1})} x_t + \sqrt{\bar{\alpha}_{t-1} (1 - \alpha_t)} \hat{x}_\theta(x_t, t)}{1 - \bar{\alpha}_t}
\end{aligned}\]

<ul>
  <li>위의 term을 다시 대입하면 식을 다음과 같이 나타낼 수 있다.</li>
</ul>

\[\arg\min_\theta \, \frac{1}{2 \sigma_q^2(t)} \frac{\bar{\alpha}_{t-1}(1 - \alpha_t)^2}{(1 - \bar{\alpha}_t)^2}\left\| \hat{x}_\theta(x_t, t) - x_0 \right\|_2^2\]

<ul>
  <li>결국 VDM이 초기 state를 찾아내는 문제가 되었다.</li>
</ul>

<h3 id="learning-diffusion-noise-parameters">Learning Diffusion Noise Parameters</h3>

<ul>
  <li>디퓨전 모델이 결국 초기 state를 찾아내는 문제가 됨을 보였다. 해당 식은 노이즈 파라미터가 포함된 꼴로 나타난다. 그렇다면 이제 노이즈 파라미터를 찾는 방법을 알아보자. \(\bar{\alpha_t} = \prod_{i=1}^{T} \alpha_i\)를 각 항에서 계산해야 한다. 하지만 매 timestep에서 이 값을 계산하는 것은 비효율적이다. SNR(Signal-to-Noise-Rate)을 다음과 같이 정의할 때 위의 식은 SNR로 표현될 수 있다.</li>
</ul>

\[SNR(t) = \frac{\bar\alpha_{t-1}}{1 - \bar\alpha_{t-1}} = \frac{\mu^2}{ \sigma^2}\]

\[\begin{aligned}
&amp;\frac{1}{2} \left[ \frac{\alpha_{t-1}}{1 - \alpha_{t-1}} - \frac{\alpha_t}{1 - \alpha_t} \right] \left\| \hat{x}_\theta(x_t, t) - x_0 \right\|^2 \\
&amp;= \frac{1}{2} \sigma^2_q(t) \alpha_{t-1} (1 - \alpha_t)^2 (1 - \alpha_{t})^2 \left\| \hat{x}_\theta(x_t, t) - x_0 \right\|_2^2 \\
&amp;= \frac{1}{2} (\text{SNR}(t-1) - \text{SNR}(t)) \left\| \hat{x}_\theta(x_t, t) - x_0 \right\|_2^2
\end{aligned}\]

<ul>
  <li>SNR은 자세히 보면 encoder의 각 state에 대한 평균과 분산으로 이루어진 식임을 알 수 있다. SNR은 기존 시그널과 노이즈 양의 비율로 SNR이 크면 시그널이 많고, 작으면 노이즈가 많은 상태이다. 디퓨전 모델에서는 SNR이 단조 감소하도록 해 마지막 state T에서 standard Gaussian을 따르도록 노이즈를 점진적으로 추가해야 한다. 그러면 SNR을 아래와 같이 쓸 수 있고 SNR을 구성하는 alpha도 다시 표현할 수 있다.</li>
</ul>

\[\begin{aligned}
&amp;\frac{\overline{\alpha}_t}{1 - \overline{\alpha}_t} = \exp(-\omega \eta(t))\\
&amp;\overline{\alpha}_t = \text{sigmoid}(-\omega \eta(t)) = \frac{1}{1 + \exp(\omega \eta(t))}\\
&amp;1 - \overline{\alpha}_t = \text{sigmoid}(\omega \eta(t))=\frac{1}{1 + \exp(-\omega \eta(t))}
\end{aligned}\]

<ul>
  <li>\(\omega \eta(t)\)는 단조 증가하는 neural network이고 이 함수도 최적화 되어야 한다.</li>
</ul>

<h3 id="three-equivalent-interpretations">Three Equivalent Interpretations</h3>

<ul>
  <li>앞서 보았듯이 VDM은 초기 state를 임의의 state t로부터 예측하는 neural network를 구축하는 것으로 학습될 수 있다. 이전에 구한 t state에서의 분포를 변형해 아래와 같이 쓸 수 있다.</li>
</ul>

\[x_0 =\frac{x_t − \sqrt{1 − \bar\alpha_t}\epsilon_0}{\sqrt{\bar\alpha_t}}\]

\[\mu_q(x_t, x_0)= \frac{1}{\sqrt{\alpha_t}} x_t - \frac{(1 - \alpha_t)}{ \sqrt{1 - \overline{\alpha}_t}\sqrt{\alpha_t}} \epsilon_0\]

\[\mu_\theta(x_t, t)= \frac{1}{\sqrt{\alpha_t}} x_t - \frac{(1 - \alpha_t)}{ \sqrt{1 - \overline{\alpha}_t}\sqrt{\alpha_t}}\hat\epsilon(x_t, t)\]

<ul>
  <li>initial state는 우리가 알 수 없기 때문에 state t로 이를 estimate 해서 표현해야 한다. 지금까지 계속해서 해온 작업은 KL Divergence를 최소화 하기 위해 식을 계속해서 변형한 것이었다. 지금까지의 결과로 KL Divergence를 최소화하는 문제를 최종적으로 다음과 같이 나타낼 수 있다.</li>
</ul>

\[\arg \min_\theta \, D_{\text{KL}} \left( q(x_{t-1} \mid x_t, x_0) \, \| \, p_\theta(x_{t-1} \mid x_t) \right) = \arg \min_\theta \frac{1}{2\sigma^2_q(t)}  \frac{(1 - \alpha_t)^2}{ (1 - \overline{\alpha}_t) \alpha_t }[{\left\| \epsilon_0 - \hat\epsilon(x_t, t) \right\|^2_2}]\]

<ul>
  <li>\(\hat\epsilon(x_t, t)\)은 노이즈를 학습하는 neural network이다. VDM에서 초기 state를 예측하는 문제는 노이즈를 예측하는 문제와 같다. 이를 Tweedie’s Formula를 통해 해석해 볼 수도 있다.</li>
</ul>

\[\begin{aligned}
&amp;E[Y \mid X] = X + \sigma^2 \cdot \nabla \log p(X)\\
&amp;q(x_t|x_0) = N (x_t;\sqrt{\bar\alpha_t}x_0,(1 − \bar\alpha_t) I)\\
&amp;E [µ_{x_t}|x_t] = x_t + (1 − \bar\alpha_t)∇_{x_t}\log p(x_t)
\end{aligned}\]

<ul>
  <li>우리는 마지막 식에서의 expectation을 알고 있다. 이를 대입해 식을 정리하면 initial state를 state t에 대해서 표현할 수 있다.</li>
</ul>

\[\begin{aligned}
&amp;\sqrt{\overline{\alpha}_t} \, x_0 = x_t + (1 - \overline{\alpha}_t) \nabla \log p(x_t) \\
&amp;\therefore \quad x_0 = \frac{x_t + (1 - \overline{\alpha}_t) \nabla \log p(x_t)}{\sqrt{\overline{\alpha}_t}}
\end{aligned}\]

<ul>
  <li>이 결과를 대입하면 denoising transition mean도 state t에 대해서 나타내는 것이 가능해진다.</li>
</ul>

\[\mu_q(x_t, x_0) = \frac{1}{\sqrt{\alpha_t}}x_t+\frac{1-\alpha_t}{\sqrt{\alpha_t}}\nabla\log{p(x_t)}\]

<ul>
  <li>이에 대한 approximate denoising transition mean을 다음과 같이 쓰기로 한다.</li>
</ul>

\[\mu_\theta(x_t, t) = \frac{1}{\sqrt{\alpha_t}}x_t+\frac{1-\alpha_t}{\sqrt{\alpha_t}}s_\theta(x_t, t)\]

\[\begin{aligned}
&amp;\arg\min_{\theta}D_{KL}(q(x_{t-1}|x_t, x_0) \| \mathcal{N}(x_{t-1};\mu_\theta, \Sigma_q(t)))\\
&amp;=\arg\min_{\theta} \frac{1}{2 \sigma_q^2(t)} \| \mu_\theta - \mu_q \|_2^2\\
&amp;=\arg\min_{\theta} \frac{1}{2 \sigma_q^2(t)} \frac{{(1-\alpha_t)^2}}{\alpha_t}[\| {s_\theta(x_t, t)- \nabla\log p(x_t) \|_2^2}]
\end{aligned}\]

<ul>
  <li>KL Divergence를 구하는 식을 approximate denoising mean을 사용해 변형했다. 이제 Neural Network는 score function을 예측하도록 학습될 것이다.</li>
</ul>]]></content><author><name>Jaewon Seo</name></author><category term="paper-review" /><category term="diffusion" /><category term="generative-models" /><summary type="html"><![CDATA[Calvin Luo, arXiv 2022]]></summary></entry><entry><title type="html">U-Net: Convolution Networks for Biomedical Image Segmentation</title><link href="https://ddungjae.github.io/posts/unet-convolutional-networks-biomedical-image-segmentation/" rel="alternate" type="text/html" title="U-Net: Convolution Networks for Biomedical Image Segmentation" /><published>2025-01-14T00:00:00+09:00</published><updated>2025-01-14T00:00:00+09:00</updated><id>https://ddungjae.github.io/posts/unet-convolutional-networks-biomedical-image-segmentation</id><content type="html" xml:base="https://ddungjae.github.io/posts/unet-convolutional-networks-biomedical-image-segmentation/"><![CDATA[<p><a href="https://arxiv.org/pdf/1505.04597">https://arxiv.org/pdf/1505.04597</a></p>

<h2 id="1-introduction">1. Introduction</h2>

<ul>
  <li>기존의 convolution network는 분류 작업에 사용되어 왔고, 이미지 input에 대한 output이 single class label의 형태로 나타났다. 하지만 다양한 이미지 처리 작업(특히 의학, 생물학 분야)에서는 결과가 localization되어 나타남을 필요로 했다(예를 들어, 세포 사진에 대해서, 각각의 기관이 무엇인지를 라벨링 해야 했다). 이에, Sliding-window setup에서는, 각각의 픽셀에 대하여, 주변의 픽셀을 학습 데이터로 넣어주었다. 이러한 방법은, network가 localized 되도록 하고, 한정된 수의 사진에 대하여 픽셀별로 training data를 구분하기 때문에 더 많은 training data를 얻을 수 있다.  하지만 이 방법에도 단점이 존재한다.
    <ul>
      <li>Sliding-window의 단점 1: 각각의 patch에 대하여 network가 독립적으로 수행되어야 하고, 인접 픽셀을 학습 데이터로 사용한다는 점은 겹치는 patches에 대한 반복을 필요로 한다.</li>
      <li>Sliding-window의 단점 2: Localization accuracy와 use of context간의 tradeoff가 발생한다. 더 큰 patch는 localization accuracy를 줄이기 위해 더 큰 max-pooling layer을 필요로 하고, 이는 localization accuracy를 낮춘다(작은 patch는 네트워크에서 작은 맥락만을 파악할 수 있도록 한다).</li>
    </ul>
  </li>
  <li>최근의 접근 방법에서는 multiple layer의 특징을 고려한 classifier 추출을 제안했고, 이는 localization과 use of context가 동시에 가능하도록 했다.</li>
  <li>본 논문에서는, “fully-convolutional-network”라고 불리는 구조를 제안한다. 이는 적은 수의 training data만으로도 더욱 정밀한 segmentation을 가능하도록 한다. 핵심 아이디어는, 연속적인 레이어를 통해 usual contracting layer을 보완하고 이때 pooling operator가 upsampling operators를 통해 대체된다. 이러한 레이어들은 output의 해상도를 높인다. Localization을 위해서, contracting path에서 획득한 고해상도의 특징은 upsampled output과 결합된다. 연속적인 레이어는 이 정보에 기반해 더 정밀한 결과를 학습할 수 있다.</li>
  <li>Upsampling part에서 중요한 modification 중 하나는 네트워크가 높은 resolution의 layer에서 context information을 전파하는 것을 가능하도록 하는 것이다. 결과적으로, expansive path는 contracting path와 비교해 대칭성을 덜 가지게 되고, U 모양의 구조를 가지게 된다. 이 네트워크는 어느 fully connected layer을 가지고 있지 않고, convolution에서 가능한 부분만 사용하지만(segmentation map은 픽셀에 대한 정보만을 가지고 있지 전체 이미지를 가지고 있지 않는다) 이는 임의의 큰 이미지에 대해 overlap-tile strategy를 통해 seamless segmentation이 가능하도록 한다. Fig 2에서, 경계 부분의 이미지를 학습하기 위해 input 이미지를 대칭 변환 해 만들어 낸다.</li>
</ul>

<p><img src="/assets/images/unet-convolutional-networks-biomedical-image-segmentation/overlap-tile.png" alt="" /></p>

<ul>
  <li>medical image는 데이터의 수가 아주 적어 연속적인 data augmentation의 사용을 training data에 대한 elastic deformation의 적용을 통해 수행한다. 이는 네트워크가 각각의 deformation에 대해, invariance를 학습할 수 있도록 하며, 이 과정에서 annotated image corpus에 대한 변형을 살펴 볼 필요가 없도록 한다.</li>
</ul>

<h2 id="2-network-architecture">2. Network Architecture</h2>

<p><img src="/assets/images/unet-convolutional-networks-biomedical-image-segmentation/architecture.png" alt="" /></p>

<ul>
  <li>네트워크 구조는 위의 그림과 같다.  U-Net은 contracting path와 expansive path로 구성되어 있다. Contracting path는 convolution network의 전형적인 구조를 따른다. 두 개의 3x3 convolution을 연속적으로 적용하고(Relu 함수를 recitified linear unit으로 사용), 2x2 max pooling operation을 적용한다. 각각의 downsampling step을 통해 feature channel의 수를 두 배로 늘린다. Expansive path의 모든 과정은 2x2 convolution을 통과하며 upsampling 과정으로 이루어진다(feature channel의 수가 절반이 됨). 이후 두 개의 3x3 convolution을 통과한다. 마지막 layer에서, 1x1 convolution은 각각이 64개의 feature vector을 원하는 class로 할당하도록 한다. 전체 네트워크는 23개의 convolution layer을 가진다.</li>
</ul>

<h2 id="3-training">3. Training</h2>

<ul>
  <li>Input image와 이에 상응하는 segment map이 train data로 사용되었고 stochastic gradient descent implementation으로 학습되었다. Convolution 과정에서 padding이 적용되지 않았기 때문에, output image가 input image 보다 작은 크기로 나타난다. Energy function은 pixel-wise soft-max로 계산되었고, \(p_k(x) = \frac{\exp(a_k(x))}{\sum_{k'=1}^K \exp(a_{k'}(x))}\)로 정의된다. 이후 cross entropy는 각각의 position에 대해 아래 함수로 penalize 한다.</li>
</ul>

\[E = \sum_{x \in \Omega} w(x) \log(p_{\ell(x)}(x))\]

<h2 id="요약">요약</h2>

<ul>
  <li>Contracting path: 점진적으로 넓은 범위의 픽셀을 보며 의미정보를 추출함
    <ul>
      <li>3×3 Convolution Layer + ReLu + BatchNorm (No Padding, Stride 1) 2번</li>
      <li>2x2 Max-pooling Layer(Stride 2)</li>
      <li>padding이 적용되지 않기 때문에 feature map의 크기가 감소함</li>
      <li>Downsampling할 때마다 Channel의 수가 2배씩 증가</li>
    </ul>
  </li>
  <li>Bottle Neck
    <ul>
      <li>3×3 Convolution Layer + ReLu + BatchNorm (No Padding, Stride 1) 2번</li>
      <li>Dropout Layer</li>
    </ul>
  </li>
  <li>Expanding path: 의미정보를 픽셀의 위치 정보와 결합해 각 픽셀마다 어떤 객체에 속하는지 구분하는 확장 경로
    <ul>
      <li>2×2 Deconvolution layer (Stride 2)</li>
      <li>수축 경로에서 동일한 Level의 특징맵(Feature Map)을 추출하고 크기를 맞추기 위하여  이전 Layer에서 생성된 특징맵(Feature Map)과 연결(Concatenation)함</li>
      <li>3×3 Convolution Layer + ReLu + BatchNorm (No Padding, Stride 1) 2번</li>
      <li>Contracting path의 역과정</li>
    </ul>
  </li>
  <li>input은 픽셀별 RGB value, output은 각 픽셀이 어느 영역에 속하는지에 대한 segmentation 정보</li>
  <li>Strategies
    <ul>
      <li>Overlap tile strategy: 겹치는 부분이 존재하도록 이미지를 자르고, segmentation 함</li>
      <li>Mirroring Extrapolate: 이미지의 경계 부분을 학습하기 위해 경계를 기준으로 이미지를 mirroring해 input으로 사용</li>
      <li>Weight Loss: 각 픽셀이 경계와 얼마나 가까운지 weight map을 만들고, 경계에 가까운 픽셀의 Loss를 weight map에 비례하게 증가시킴. 경계와 가까운 픽셀일수록 loss가 크게 반영되기 때문에 경계에 해당하는 픽셀을 잘 학습하게 됨.</li>
    </ul>
  </li>
</ul>

\[w(x) = w_c(x) + w_0 \cdot \exp\left(-\frac{\left(d_1(x) + d_2(x)\right)^2}{2\sigma^2}\right)\]]]></content><author><name>Jaewon Seo</name></author><category term="paper-review" /><category term="segmentation" /><category term="computer-vision" /><summary type="html"><![CDATA[Olaf Ronneberger, Philipp Fischer, Thomas Brox, MICCAI 2015]]></summary></entry></feed>