Week3-1: Unbiased Condition of SGD
Unbiased Condition for SGD
이전에 일반적인 gradient descent에서 확장된 SGD를 알아보았다. SGD는 전체 data point로부터 loss를 구하지 않고 이를 batch로 쪼갠 후 batch마다 loss를 계산하는데 이때 SGD가 “Unbiased”하려면 \(\text{E}[\frac{1}{k}\nabla_BL]=\frac{1}{N}\nabla L\)이 되어야 한다. 즉 전체 data point에서의 loss와 각 batch에서의 loss의 기댓값이 같아야 한다는 것이다. 우리는 batch를 고르는 방법에 따라서 batch별 loss의 기댓값을 구할 수 있다.
Uniform Fixed-Sized Batches
우선 \(k\)라는 고정된 크기로 batch를 항상 설정한다고 해보자. 이때 전체 data point에서 “Uniformly Random” 하도록 batch에 포함할 샘플을 골라야 한다. 이는 각 batch가 다음과 같은 조건을 만족해야 한다는 것이다.
\[\text{P}(\set{i_1, i_2, \cdots,i_m}\subseteq B)=\frac{\binom{N-m}{k-m}}{\binom{N}{k}}\]직관적으로 봤을 때 전체 \(N\)개 샘플 중에서 크기가 \(k\)인 batch를 만들 때 \(m\)개의 원소가 이 batch에 들어갈 확률을 조합으로 나타낸 것이다. 이 조건을 만족하면 우리가 각 batch의 원소를 “Uniformly Random”하게 선택했다고 말할 수 있다. 그러면, 이렇게 선택된 batch별 loss의 기댓값을 계산할 수 있다.
\[\begin{aligned} \text{E}[\frac{1}{k}\nabla_BL]&=\text{E}[\sum_{i\in B}\frac{\nabla_\theta L_i(\theta)}{k}]=\text{E}[\sum_{i\in B}\mathbb{1}_{\set{i\in B}}\frac{\nabla_\theta L_i(\theta)}{k}]\\ &=\sum_{i=1}^N\text{P}(i\in B)\frac{\nabla_\theta L_i(\theta)}{k}=\sum_{i=1}^N\frac{\binom{N-1}{k-1}}{\binom{N}{k}}\frac{\nabla_\theta L_i(\theta)}{k}=\frac{1}{N}\nabla_\theta L(\theta) \end{aligned}\]계산 과정에서 indicator function의 기댓값이 확률로 변환될 수 있다는 과정이 사용되었다. 이를 통해 uniform하게 원소를 선택해 batch를 구성할 경우 loss의 기댓값이 전체 data point에서의 loss와 같음을 보였다. loss의 기댓값도 중요하지만 분산도 살펴볼 필요가 있다. 분산을 계산하기 위해 다음과 같이 loss의 제곱의 기댓값을 구한 후 분산을 구하는 공식에 따라 계산할 수 있다.
\[\begin{aligned} \text{E}[(\frac{1}{k}\nabla_BL)^2]&=\frac{1}{k^2}\text{E}[\sum_{i=1}^N\mathbb{1}_{\set{i\in B}}\lVert\nabla L_i\rVert^2]+\frac{1}{k^2}\text{E}[\sum_j\sum_i\mathbb{1}_{\set{\set{i, j}\in B}}\nabla L_i^\top\nabla L_j]\\ &=\frac{1}{k^2}\frac{k}{N}\sum_{i=1}^N\lVert\nabla L_i\rVert^2+\frac{1}{k^2}\sum_j\sum_i\frac{\binom{N-2}{k-2}}{\binom{N}{k}}\nabla L_i^\top\nabla L_j\\ \Rightarrow \text{Var}[\frac{1}{k}\nabla L_B]&=\frac{k(N-k)}{k^2N^2(N-1)}(N\sum_{i=1}^N\lVert\nabla L_i\rVert^2-\lVert\sum_{i=1}^N\nabla L_i\rVert^2) \end{aligned}\]Bernoulli Based Batch
샘플을 고를 때 uniform하게 고르는 경우를 보았는데 이와 달리 각 data point를 \(p\)라는 확률로 batch에 포함할지 말지를 결정한다면 각각의 data point는 Bernoulli random variable이 되고 각 data point들은 independently하게 identically distributed하게 된다. 즉 각각의 데이터포인트를 batch에 포함할지 말지는 독립적이며 \(p\)의 확률로 batch에 포함되는 것이다. 이러한 경우 loss의 기댓값, loss 제곱의 기댓값, loss의 분산은 다음과 같이 나타난다.
\[\begin{aligned} \text{E}[\frac{1}{k}\nabla_BL]&=\frac{1}{N}\nabla_\theta L\\ \text{E}[(\frac{1}{k}\nabla_BL)^2]&=\frac{1}{N^2}\lVert\nabla_\theta L\rVert^2+(\frac{1}{kN}-\frac{1}{N^2})\sum\lVert\nabla L_i\rVert^2\\ \text{Var}[\frac{1}{k}\nabla_BL]&=(\frac{1}{kN}-\frac{1}{N^2})\sum\lVert\nabla L_i\rVert^2 \end{aligned}\]Convergence Speed of Gradient Descent
GD와 SGD에서 모두 loss function의 값을 최소로 하는 global minimum point에서의 파라미터 조합을 찾고자 한다. 그렇다면, GD가 실제로 global optimal point에 도달하는 속도는 어떻게 잴 수 있을까? 우리가 GD를 특정 step만큼 수행한다고 할 때 어느 정도 step을 수행해야 global optimal point에 도달할지를 아는 것은 최적화를 수행할 때 중요하게 작용할 것이다. \(L(\theta)=\frac{1}{2}\lVert A_\theta-b\rVert_2^2\)라는 loss function에서 loss를 최소화 하는(loss가 0이 되는) \(\theta^*\)가 존재한다고 해보자. 이때 loss function의 그래디언트는 \(\nabla L(\theta)=A^\top A\theta-A^\top b\)로 나타난다. 그리고 GD에서는 \(\theta_{k+1}=\theta_k-\eta(A^\top A\theta_k-A^\top b)\)와 같은 방식으로 파라미터를 업데이트 한다. 파라미터를 업데이트 하는 과정에서 양변에 최적 파라미터인 \(\theta^*\)를 빼고 약간의 식 변형을 해보자.
\[\begin{aligned} \theta_{k+1}-\theta^*&=\theta_k-\theta^*-\eta(A^\top A(\theta_k-\theta^*+\theta^*)-A^\top b)\\ \text{Assume } A\theta^*&=b.\\ \theta_{k+1}-\theta^*&=(I-\eta(A^\top A))(\theta_k-\theta^*) \end{aligned}\]우리는 최적 파라미터 \(\theta^*\)에서 \(A\theta^*-b=0\)으로 가정을 했기 때문에 위와 같이 식을 변형할 수 있다. 여기서 다시 한번 SVD가 존재하는데 우리가 \(A\)라는 행렬에 SVD를 수행하면 \(A=U\Sigma V^\top, A^\top A=V\Sigma^2V^\top\)으로 표기할 수 있고 이를 위의 식에 대입해보자.
\[\begin{aligned} \theta_{k+1}-\theta^*&=(I-\eta(V\Sigma^2V^\top))(\theta_k-\theta^*)\\ V^\top(\theta_{k+1}-\theta^*)&=V^\top(I-\eta(V\Sigma^2V^\top))(\theta_k-\theta^*)=(I-\eta(\Sigma^2))V^\top(\theta_k-\theta^*)\\ \text{Let }y_k&=V^\top(\theta_k-\theta^*) \text{ then }y_{k+1}=(I-\eta(\Sigma^2))y_k. \end{aligned}\]위의 관계식을 보면 스텝이 진행될 때마다 해당 스텝의 파라미터와 최적 파라미터의 차이가 적절한 \(\eta\)에 대하여 지수적으로 감소하게 만들 수 있음을 알 수 있다. 구체적으로는 \(\lvert I-\eta(\Sigma^2)\rvert<1\)인 조건이 필요하다. 이때 \(\Sigma^2\)의 대각 원소가 \(\sigma_1^2, \cdots, \sigma_r^2\)이므로 \(\lvert1-\eta\sigma_i^2\rvert<1, \forall i\)라고 적을수도 있다. 그렇다면 \(\lvert1-\eta\sigma_i^2\rvert<\rho, \forall i\)로 bounded된다고 하면, 수렴 속도는 \(\rho\)가 작을수록 빠르므로 이 최댓값인 \(\rho(\eta)=\max_i\lvert1-\eta\sigma_i^2\rvert\)를 최소화 하는 최적의 \(\eta\)를 찾고자 한다. 최종적으로 우리는 \(y_k\)에 대한 범위를 구할 수 있다.
\[\lVert y_k\rVert_2=\lVert(I-\eta(\Sigma^2))y_{k-1}\rVert_2\le\rho^k\lVert y_0\rVert_2\rightarrow0\]충분히 큰 \(k\)에 대해서 우리는 \(y_k\)가 0으로 수렴함을 위의 부등식에서 알 수 있다.
\[\eta^*=\operatorname*{argmin}_\eta \max_i\lvert1-\eta\sigma_i^2\rvert\]이때 \(\rho(\eta)=\max_i\lvert1-\eta\sigma_i^2\rvert\)의 최댓값은 \(\sigma_1,\sigma_r\)중 하나에서 발생한다. 이때 최댓값을 최소화 하려면 양 끝 singular value에서의 값이 같아야 하며 \(1-\eta\sigma_1^2=-1+\eta\sigma_r^2\)을 만족해야 하고 이때 \(\eta^*=\frac{2}{\sigma_1^2+\sigma_r^2}\)가 된다. 최적 \(\eta^*\)에서의 수렴 감소율은 \(\rho(\eta^*)=\frac{(\frac{\sigma_1}{\sigma_r})^2-1}{(\frac{\sigma_1}{\sigma_r})^2+1}\)이다. 이때 수렴 속도가 빠르려면 \(\sigma_1\approx\sigma_r\)이어야 한다. 우리는 \(\frac{\sigma_1}{\sigma_r}\)을 \(A\)의 condition number이라고 부르며 수렴 속도는 이 condition number과 관련이 있음을 알 수 있다.
Condition Number에 따른 수렴 속도 시각화
위 식들이 실제로 어떤 의미인지, 앞서 쓴 표기 그대로 \(A\)가 두 개의 singular value \(\sigma_1, \sigma_r\)만 가지는(즉 \(r=2\)인) 가장 단순한 경우에 대해 \(y=V^\top(\theta-\theta^*)\) 좌표에서 직접 그려보면 더 분명해진다. 이 좌표에서 loss는 \(L(y)=\frac{1}{2}(\sigma_1^2y_1^2+\sigma_r^2y_2^2)\)로 대각화되므로, 등고선은 두 축의 길이가 \(1/\sigma_1, 1/\sigma_r\)에 비례하는 타원이 된다. 앞서 정의한 condition number \(\frac{\sigma_1}{\sigma_r}\)를 편의상 \(\kappa\)로 줄여 쓰고, \(\sigma_r=1\)로 고정해 \(\sigma_1=\kappa\)로 두었을 때, 같은 시작점에서 최적의 \(\eta^*\)로 50 스텝 GD를 수행한 경로가 아래 그림이다.
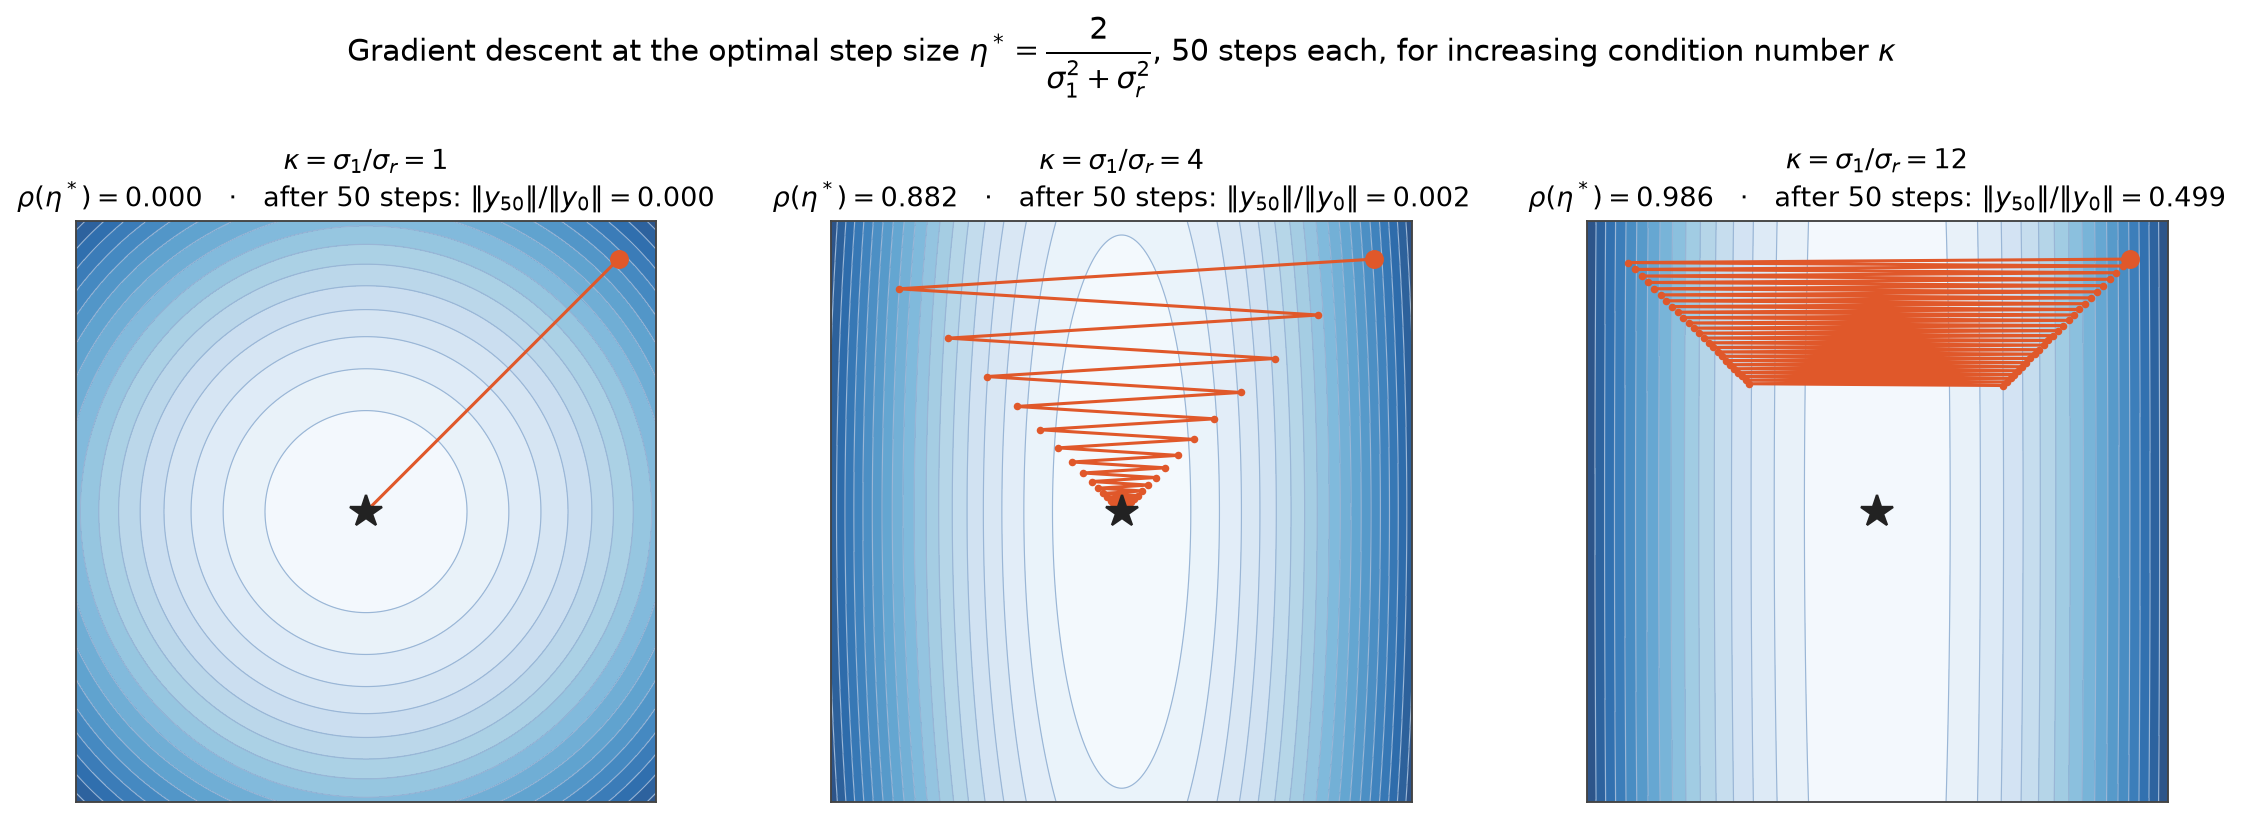
\(\kappa=1\)(가장 왼쪽, 즉 \(\sigma_1=\sigma_r\))일 때는 등고선이 원이 되어 모든 방향의 곡률이 같고, 식 \(y_{k+1}=(I-\eta^*\Sigma^2)y_k\)에서 \(\eta^*=\frac{2}{\sigma_1^2+\sigma_r^2}=\frac{1}{\sigma_1^2}\)이 되어 단 한 스텝만에 \(\theta^*\)에 도달한다(\(\rho(\eta^*)=0\)). \(\kappa\)가 커질수록 등고선이 한쪽으로 길게 늘어난 좁은 골짜기 모양이 되는데, \(\eta^*\)는 가장 가파른 방향(\(\sigma_1\))과 가장 완만한 방향(\(\sigma_r\)) 양쪽에서의 수렴률을 동시에 \(\rho(\eta^*)\)로 맞추도록 선택되기 때문에, GD는 가파른 방향으로는 부호를 바꿔가며(지그재그) 빠르게 줄어들지만 완만한 방향으로는 느리게만 줄어든다. 그 결과 전체 경로는 두 방향 모두 같은 비율 \(\rho(\eta^*)\)로 줄어들지만, \(\kappa=12\)에서는 \(\rho(\eta^*)=0.986\)로 1에 매우 가까워 똑같이 50 스텝을 돌려도 \(\theta^*\)까지 거리의 절반(\(\lVert y_{50}\rVert/\lVert y_0\rVert\approx0.499\))밖에 줄어들지 않는다. 즉 condition number \(\frac{\sigma_1}{\sigma_r}\)이 클수록 아무리 step size를 최적으로 골라도 등고선 자체가 좁고 긴 골짜기 모양이라 수렴이 근본적으로 느려지며, 이는 \(\rho(\eta^*)=\frac{\kappa^2-1}{\kappa^2+1}\)이 \(\kappa\to\infty\)일 때 1로 수렴하는 것, 즉 바로 앞 문단에서 \(\eta^*\)에서의 수렴 감소율로 구한 \(\frac{(\frac{\sigma_1}{\sigma_r})^2-1}{(\frac{\sigma_1}{\sigma_r})^2+1}\)이 \(\frac{\sigma_1}{\sigma_r}\to\infty\)일 때 1로 수렴하는 것과 정확히 같은 결론이다.