2026 KoMaP AI 경진대회
과제 소개
고탄성 주조용 Al-Si-Ni 합금은 Al 기지 안에 Al3Ni 석출상, 초정 Si(Sip), 공정 Si(Sie)가 어떤 비율과 형태로 분포하느냐에 따라 기계적 물성이 결정된다. 문제는 이 상 분율을 측정하는 과정이 아직도 사람이 광학현미경(OM) 이미지를 눈으로 보고 판독하는 방식에 의존하고 있다는 것이었다. 감자도리 팀으로 참가한 이번 KoMaP AI 경진대회는 이 판독 과정을 자동화하는 문제였다. 입력은 흑백 OM 이미지, 출력은 Al/Al3Ni/Sip/Sie 네 개 클래스로 화소 단위 분할한 마스크(주최측이 정한 4색 RGBA 포맷)이고, 평가는 이미지 하나마다 4-class IoU를 평균한 mIoU를 다시 전체 이미지에 대해 평균하는 방식이었다. 데이터는 학습 70장, 검증 20장, 평가 10장으로 나뉘어 있었고, 참고 기준 성능은 약 75%로 제시되어 있었다.
데이터를 들여다보며 확인한 것들
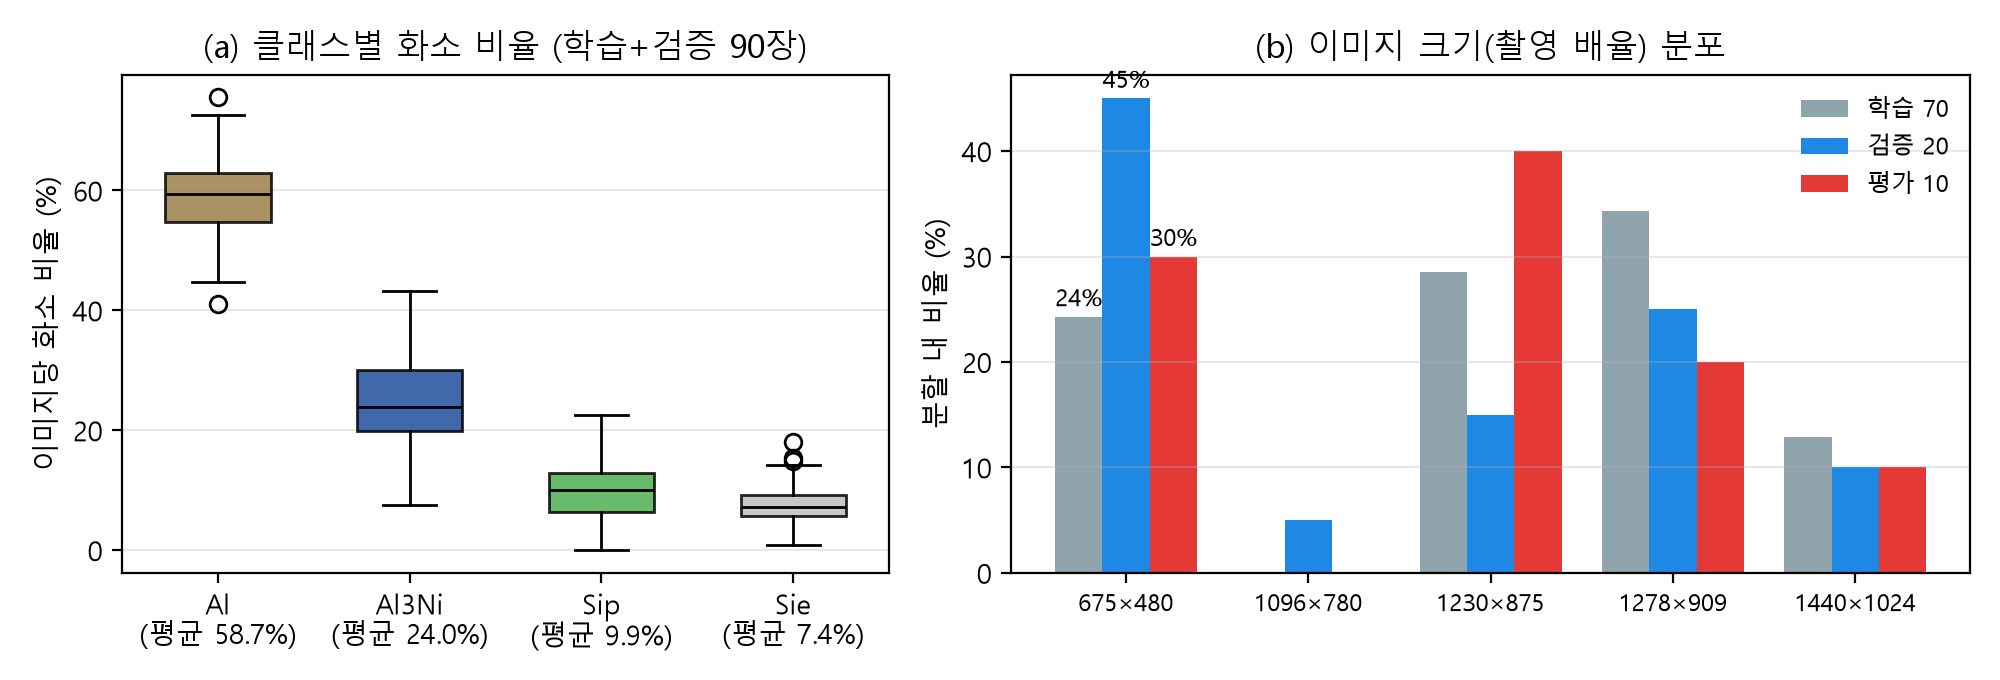
제일 먼저 한 일은 정답 마스크를 화소 단위로 뜯어보는 것이었다. 클래스별 화소 비율을 계산해보니 Al이 평균 58.7%, Al3Ni가 24.0%, Sip이 9.9%, Sie가 7.4%로 불균형이 꽤 컸다. 그런데 mIoU는 네 클래스를 동일한 가중치로 평균하기 때문에, 전체 화소의 20%도 안 되는 두 Si 상이 사실상 점수의 절반을 결정하는 구조라는 걸 깨달았다. 게다가 이미지 크기가 다섯 종류로 섞여 있었는데, 이게 곧 촬영 배율의 차이였다. 특히 675×480 크기의 저배율 이미지는 학습 데이터에서는 24%밖에 안 되는데 검증에서는 45%, 평가에서는 30%를 차지하고 있어서, 이 그룹에서의 성능이 최종 점수를 크게 좌우할 수 있겠다는 생각이 들었다.
다음으로는 상 경계에서 2화소 이상 떨어진 내부 화소만 모아서 상별 밝기 분포를 봤다. 밝기 순서는 Al(중앙값 226) > Al3Ni(143) > Sie(105) ≥ Sip(47)로 90장 전체에서 일정했지만, Al3Ni의 밝기 중앙값 자체는 이미지마다 94~184로 크게 흔들렸다. 같은 회색값이 이미지에 따라 다른 상을 의미할 수 있다는 뜻이었다. Al은 다른 상과 밝기만으로도 거의 완벽히 구분됐지만(AUC 0.994 이상), Al3Ni와 Sie는 이미지별로 최적 임계값을 잡아도 15%가 겹쳤고, Sip과 Sie는 애초에 같은 Si 상이라 밝기로는 구분이 안 되고 크기와 형태로만 갈라야 했다. 실제로 밝기 히스토그램만 쓰는 베이즈 분류기를 만들어 돌려보니 검증 mIoU가 46.9%에 그쳤다. 화소 하나하나의 밝기가 아니라 그 주변의 형태와 문맥을 같이 봐야 한다는 걸 숫자로 확인한 셈이다.
Sie의 오류 원인을 더 파고들기 위해 이미지별 Sie IoU와 여러 특성 사이의 상관을 봤는데, 흥미롭게도 Sie 구조의 평균 두께와는 상관이 없었다(Spearman ρ=0.12, 유의하지 않음). 대신 그 이미지에서 Al3Ni와 Sie의 밝기가 얼마나 겹치는지와는 강한 음의 상관(ρ=−0.61, p<0.001)을 보였다. 즉 Sie를 놓치는 이유는 구조가 가늘어서가 아니라 두 상의 밝기가 애매한 영역에서 나온다는 뜻이었고, 이 발견이 이후 모델 설계의 기준이 됐다: 원해상도를 끝까지 보존하면서도 넓은 문맥으로 상을 구분할 수 있어야 한다는 것.
전처리: 상대적 밝기를 건드리지 않는 방향으로
입력 이미지는 어차피 R, G, B가 같은 흑백 영상이라 한 채널로 읽은 다음 3채널로 복제했다. ImageNet 사전학습 가중치를 그대로 쓰기 위해서였다. 화소값은 0~1로만 바꾸고 히스토그램 평활화나 이미지별 표준화 같은 밝기 정규화는 일부러 적용하지 않았다. 앞서 EDA에서 확인했듯 이미지 간 밝기 차이는 에칭 정도에 따른 상 대비의 변화인데, 이걸 입력 단계에서 억지로 맞추면 오히려 상 판정에 쓰이는 상대적 밝기 정보가 왜곡될 수 있다고 판단했기 때문이다. 대신 이 변화를 증강으로 흉내 내서 모델이 스스로 강건해지도록 했다(국소 대비 평활화인 CLAHE를 증강으로 추가해봤지만 개선은 없었다).
증강은 라벨을 바꾸지 않으면서 실제로 있을 법한 변화만 모사한다는 원칙을 세웠다. 금속 미세조직에는 정해진 방향이 없으니 90° 회전 4가지와 좌우 반전을 조합한 D4 대칭 변환을 무작위로 적용했고, 밝기(±0.08)·대비(±0.15)·감마(±0.15)를 무작위로 바꿔 이미지마다 다른 에칭·조명 조건을 흉내 냈다. 촬영 잡음을 재현하기 위해 표준편차 3 수준의 가우시안 노이즈도 더했다. 반면 크기 변환, 탄성 변형, CutMix·Mosaic 같은 혼합 증강은 두께 1~2화소에 불과한 Sie의 굵기와 상 사이의 인접 관계를 왜곡할 수 있어서 제외했는데, 실제로 비교 실험에서도 기본 증강 대비 이득이 없었다.
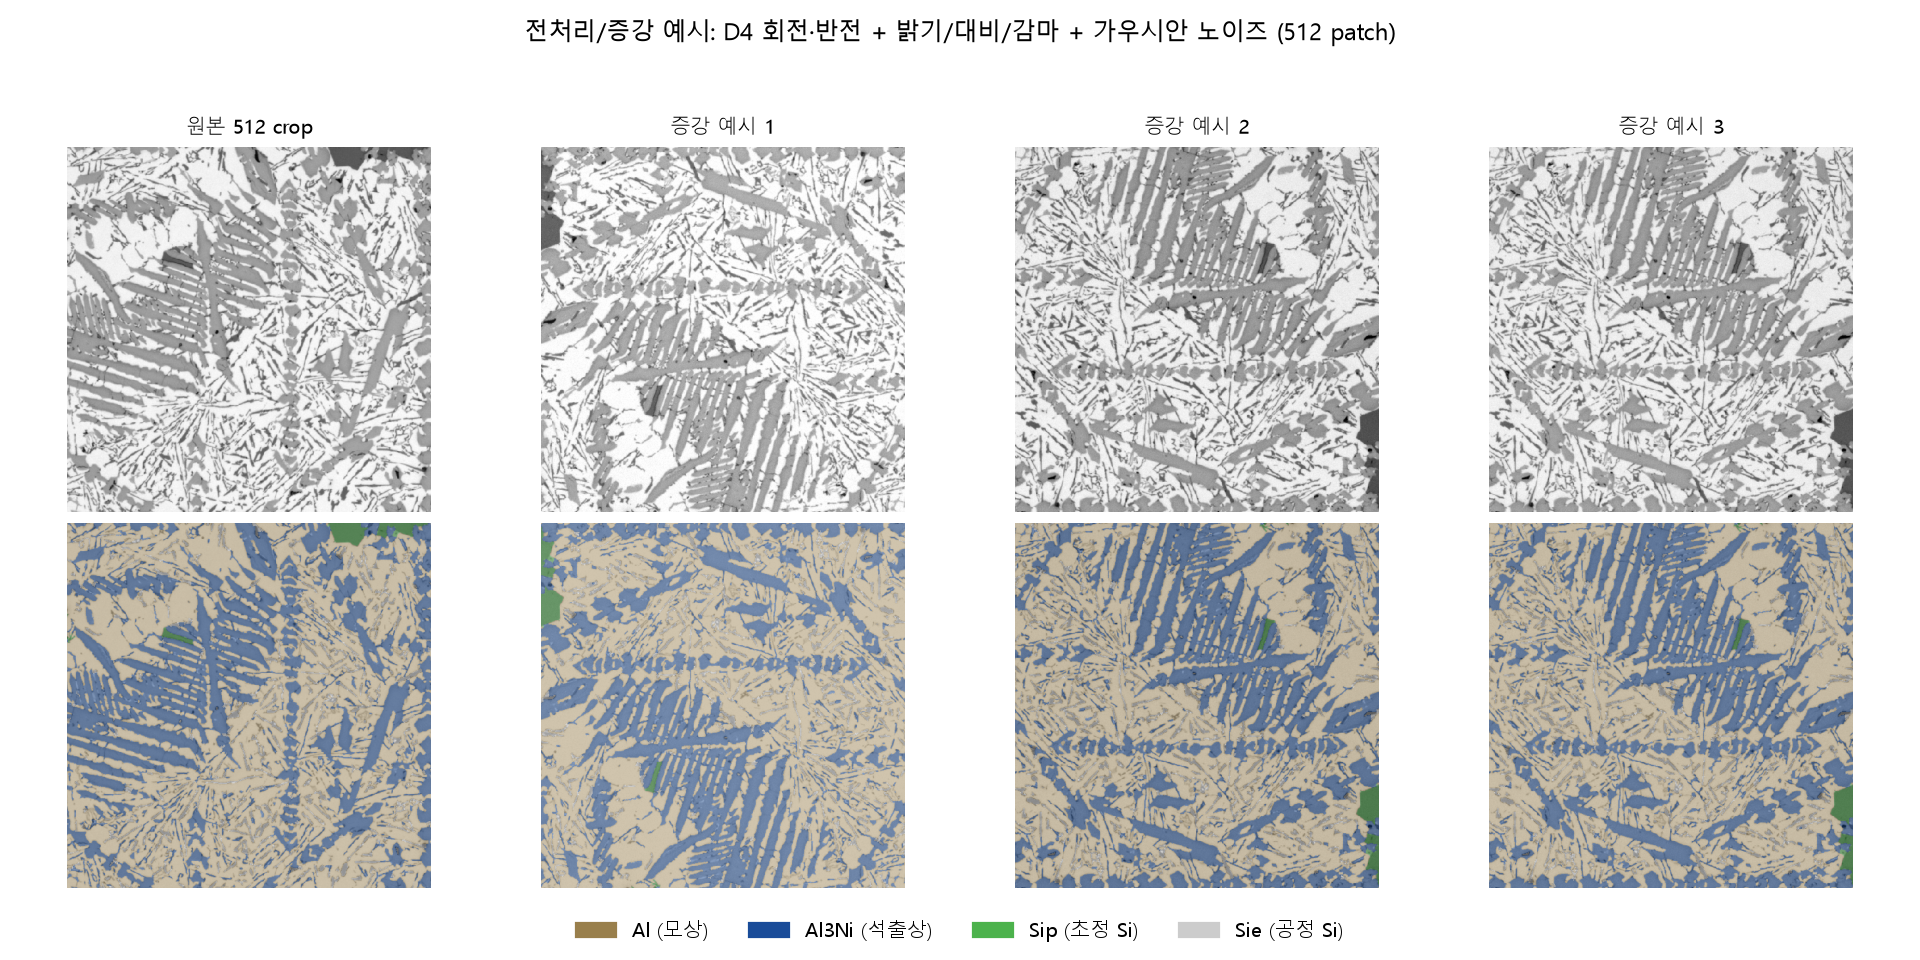
학습할 때는 매 epoch마다 이미지당 512×512 패치를 무작위 위치에서 4개씩 잘라 썼다(epoch당 280개 패치). 세로가 480화소로 패치보다 작은 675×480 이미지는 반사 패딩으로 먼저 채운 뒤 잘랐다. 반대로 검증·평가 추론에서는 리사이즈를 전혀 하지 않고 이미지 전체를 그대로 모델에 넣었다. 가로세로를 네트워크의 최대 축소 배율인 32의 배수에 맞추기 위한 반사 패딩만 최소한으로 붙이고, 예측 후 원래 크기로 잘라냈다. 리사이즈를 하지 않은 이유는 간단한데, 보간 과정에서 1~2화소 두께의 Sie가 흐려지거나 사라지는 걸 막기 위해서였다. 추론 안정성을 위해 D4 8방향 변환 각각에 대해 예측한 뒤 원래 방향으로 되돌려 softmax 확률을 평균하는 TTA도 적용했다.
모델링: 원해상도를 끝까지 들고 가는 인코더
이 과제의 핵심 난제는 두께 1~2화소인 Sie를 보존하면서, 동시에 밝기가 겹치는 Al3Ni와 Sie를 넓은 문맥으로 구분하는 것이었다. 일반적인 인코더-디코더 구조는 입력을 1/32까지 줄였다가 다시 키우는 구조라 가는 구조의 정보가 축소 과정에서 사라지기 쉽다. 이 문제를 풀기 위해 인코더로 HRNet(Sun et al., CVPR 2019)을 선택했다. HRNet은 해상도를 줄였다 늘리는 대신 1/4, 1/8, 1/16, 1/32 해상도의 분기를 처음부터 끝까지 병렬로 유지하면서 분기 사이에 정보를 반복적으로 교환한다. 가장 높은 해상도의 특징을 끝까지 보존하면서도 저해상도 분기의 넓은 문맥을 같이 쓸 수 있다는 점이 지금 문제와 정확히 맞아떨어진다고 봤다. 두 번째 인코더로는 같은 병렬 다해상도 구조를 유지하되 분기 내부의 합성곱을 local-window self-attention으로 바꾼 HRFormer(Yuan et al., NeurIPS 2021)를 썼다. 디코더는 인코더의 모든 단계 특징을 중첩된 skip connection으로 결합하는 UNet++(Zhou et al., 2018)를 쓰고, 각 디코더 블록에 scSE attention(Roy et al., 2018)을 추가해 채널·공간 방향의 중요도를 다시 가중했다.
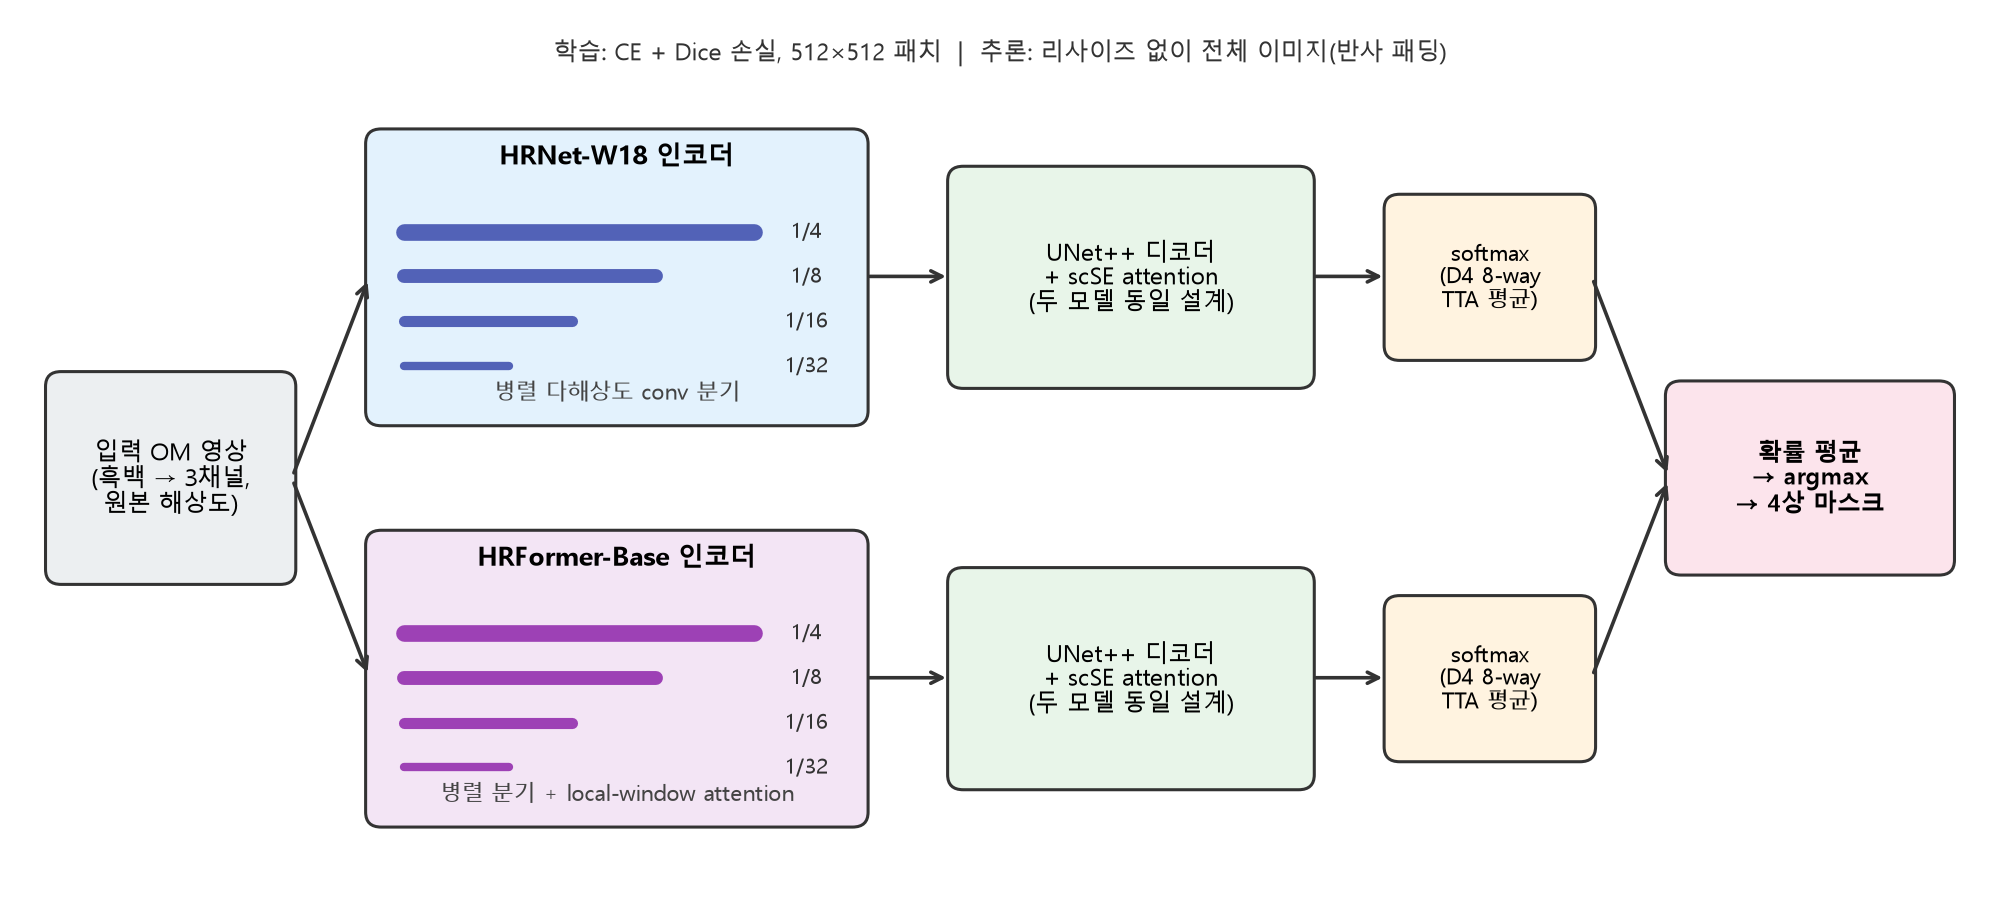
이 설계가 맞는 방향인지 확인하려고 디코더·손실·증강·학습 설정은 전부 고정한 채 인코더만 바꿔가며 비교했다.
| 인코더 | 원해상도 처리 방식 | 파라미터 | 검증 mIoU(%) |
|---|---|---|---|
| ConvNeXt-V2-Tiny | stem에서 곧바로 1/4로 축소 | — | 78.01 |
| SE-ResNeXt50 | 단계적 축소 후 복원 | — | 78.63 |
| HRNet-W18 | 1/4 분기를 끝까지 병렬 유지 | 21.4M | 79.64 ± 0.35 (시드 5개) |
| HRFormer-Base | HRNet 구조 + local-window attention | 55.9M | 79.75 |
| HRNet-W48 | HRNet-W18과 같은 구조, 폭 확대 | 77.6M | 79.15 |
결과를 보고 꽤 명확한 결론을 얻었다. 초기 단계에서 해상도를 크게 줄이는 ConvNeXt-V2나 단계적으로 축소·복원하는 SE-ResNeXt50보다, 1/4 해상도 분기를 끝까지 유지하는 HRNet과 HRFormer가 뚜렷하게 높았다. 반면 HRNet과 HRFormer는 통계적으로 차이가 없었고, 같은 HRNet 계열에서 폭만 키운 HRNet-W48은 오히려 유의하게 낮았다. 이 데이터에서 성능을 가르는 건 합성곱이냐 attention이냐, 혹은 모델 크기가 아니라 원해상도 경로를 보존하는지 여부였다.
최종 모델은 HRNet-W18과 HRFormer-Base를 각각 인코더로 쓰는 두 분할 모델의 앙상블이다. HRNet-W18은 timm의 ImageNet 사전학습 가중치를 그대로 썼는데, HRFormer-Base는 공개 라이브러리에 등록되어 있지 않아서 원저자 공식 구현에서 백본만 가져와 직접 연결해야 했다. 이 과정에서 HRNet 계열이 분류용으로 쓰는 incre_modules가 백본 크기와 무관하게 같은 채널 수의 특징을 만든다는 점을 이용해, HRFormer의 출력이 HRNet-W18과 완전히 같은 형태의 특징 피라미드가 되도록 어댑터를 직접 구현했다. 덕분에 두 모델은 인코더만 다르고 디코더의 구조와 용량은 완전히 동일해서, 인코더 자체의 차이만 비교하고 결합할 수 있었다.
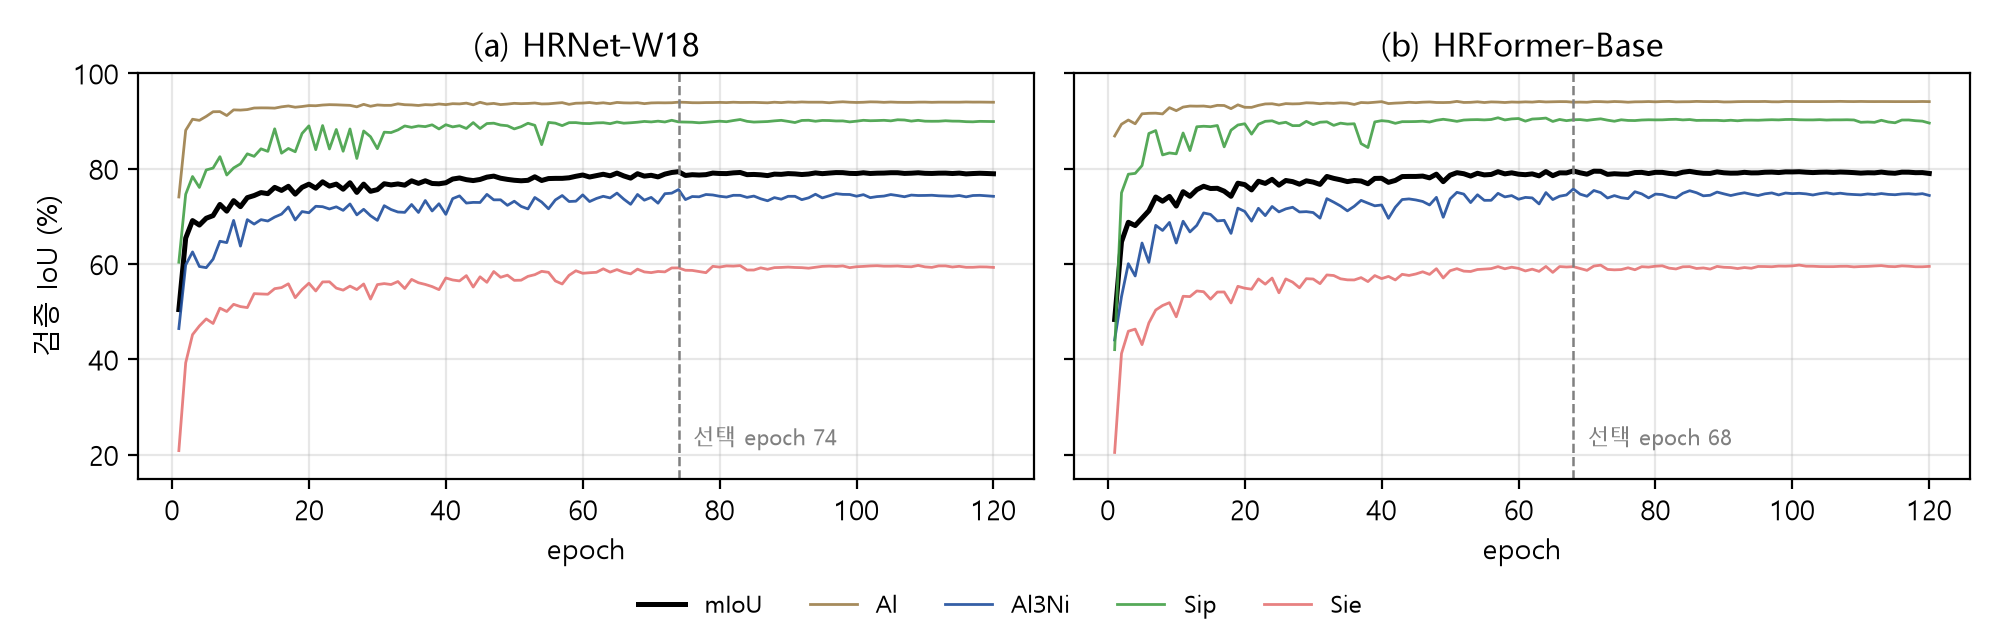
손실 함수로는 Cross-Entropy와 soft Dice를 1:1로 더해 썼다. CE는 화소 하나하나의 분류를 안정적으로 학습시키고, Dice는 클래스별 겹침 비율을 직접 최적화하기 때문에 화소 수가 적은 Sip·Sie도 Al과 동등한 비중으로 학습된다. 이는 네 클래스를 동일 가중치로 평가하는 mIoU 지표의 구조와도 맞아떨어진다. 최적화는 AdamW(학습률 1e-3, weight decay 1e-4)를 쓰되 사전학습된 인코더에는 0.1배의 학습률을 적용해 초기에 사전학습 특징이 깨지지 않도록 했다. 학습률은 5 epoch 동안 선형으로 올린 뒤 cosine 스케줄로 초기값의 1%까지 내렸고, 총 120 epoch를 돌렸다. AMP와 gradient clipping(1.0)을 적용했고 RTX PRO 4500(32GB)에서 모델당 약 50분이 걸렸다.
검증 데이터가 20장뿐이라 작은 차이가 우연인지 실제 개선인지 구분하기 어려웠다. 그래서 모든 비교에 들어가기 전에 같은 설정을 난수 시드만 바꿔 5번 학습해서 학습 자체의 변동폭(±0.35%p)부터 측정해뒀고, 이후 모든 비교는 같은 합금의 이미지를 하나의 단위로 묶어 재표본하는 alloy-clustered bootstrap으로 95% 신뢰구간을 계산했다. 이 기준으로 손실 함수를 바꿔봤는데, 경계 가중 CE(79.55%), Focal loss(79.39%), label smoothing(79.70%), 다중 클래스 MCC 손실(79.05%) 모두 기본 CE+Dice(79.98%)를 넘지 못했다. 소수 클래스나 경계를 더 강조하는 손실이 오히려 도움이 안 된다는 건 다소 의외였다.
앙상블 구성에서는 같은 구조를 시드만 바꿔 여러 개 묶는 것(HRNet 3개 80.13%, 5개 79.86%)보다 구조가 다른 두 모델을 묶는 쪽이 더 효과적이었다(80.22%). HRNet과 HRFormer는 전체 화소의 2.3%에서 서로 다른 예측을 내놓았는데, 이게 서로의 오류를 보완하는 역할을 했다. 확보해둔 9개 모델의 모든 조합(502가지)을 전수 평가해봤지만 이 2개 모델 앙상블을 유의하게 넘는 조합은 없었다.
성능
학습된 두 모델로 검증 20장 전체를 원본 해상도 그대로 예측했다. 각 모델이 D4 8방향 TTA로 softmax 확률을 구하고, 두 모델의 확률을 동일 가중치로 평균한 뒤 argmax로 최종 마스크를 만드는 방식이다. 최종 앙상블은 mIoU 80.22%로 참고 기준(약 75%)보다 5.2%p 높았다. 같은 설정을 시드만 바꿔 학습한 5개 모델의 평균이 79.64 ± 0.35%였으니, 앙상블은 이 평균보다 0.58%p 높고 95% 신뢰구간이 [+0.15, +1.12]로 통계적으로 유의한 개선이었다(20장 중 13장에서 개선). 다만 저장 시점을 검증 점수로 골랐기 때문에 검증 점수가 실제 평가 성능보다 약간 낙관적일 가능성은 남아 있다.
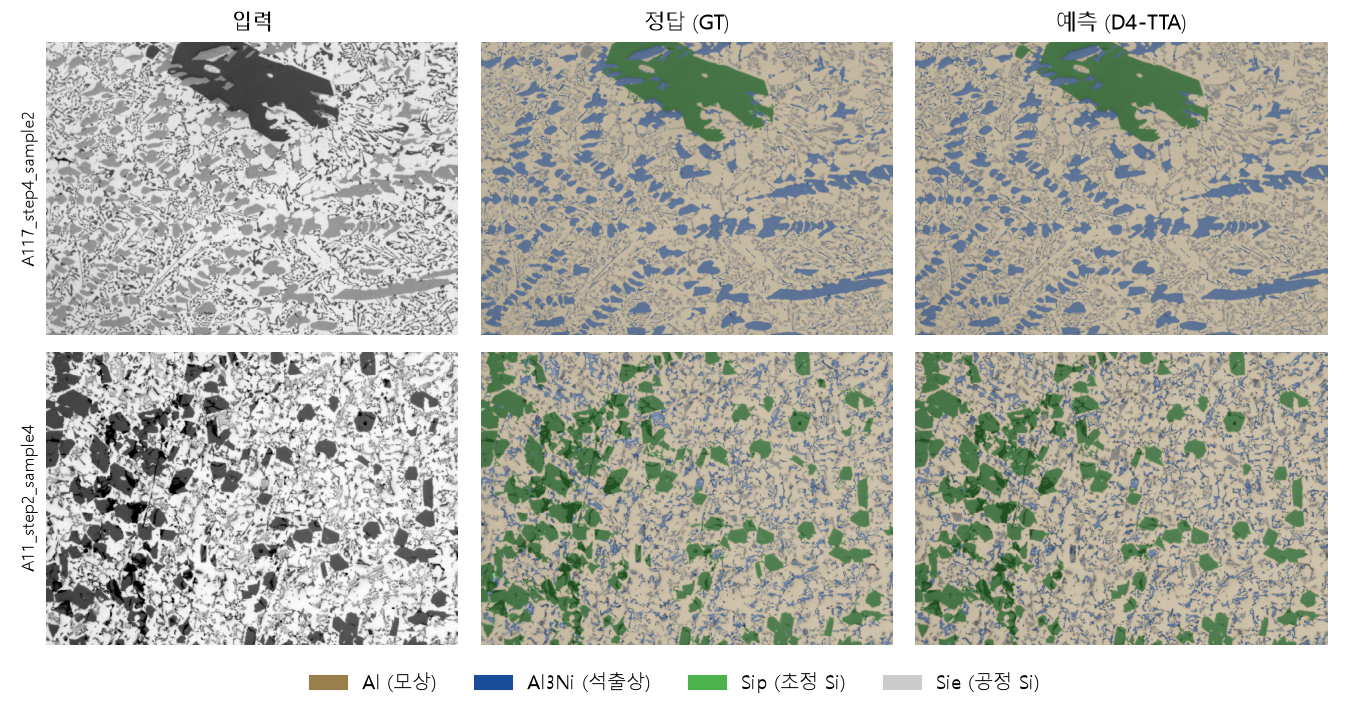
클래스별로 보면 Al과 Sip은 90% 이상으로 꽤 정확했고, 가장 어려운 클래스는 역시 Sie(60.82%)였다. 입력·정답·예측을 나란히 놓고 보면 큰 덩어리 모양의 상은 거의 완벽하게 맞히지만 가늘게 뻗은 Sie 침상 구조에서 미세한 차이가 보인다.
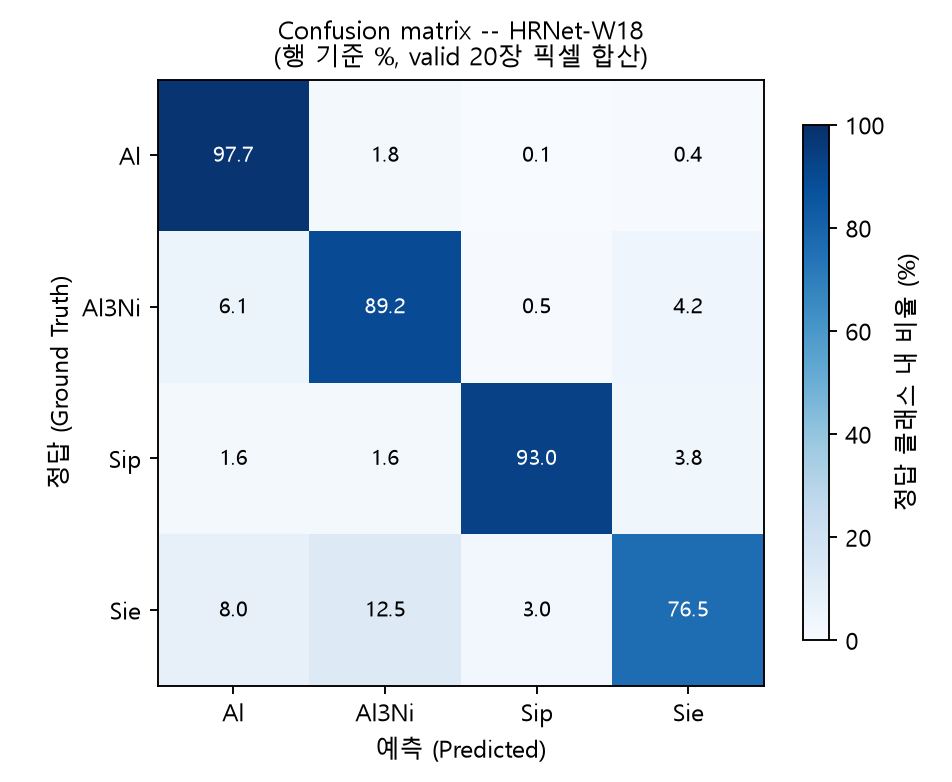
혼동행렬을 보면 Sie 화소의 12.5%가 Al3Ni로, 8.0%가 Al로 잘못 분류됐다. Sie와 Al3Ni 사이의 혼동이 가장 컸는데, 이는 앞서 EDA에서 확인한 두 상의 밝기 겹침과 정확히 일치하는 결과였다.
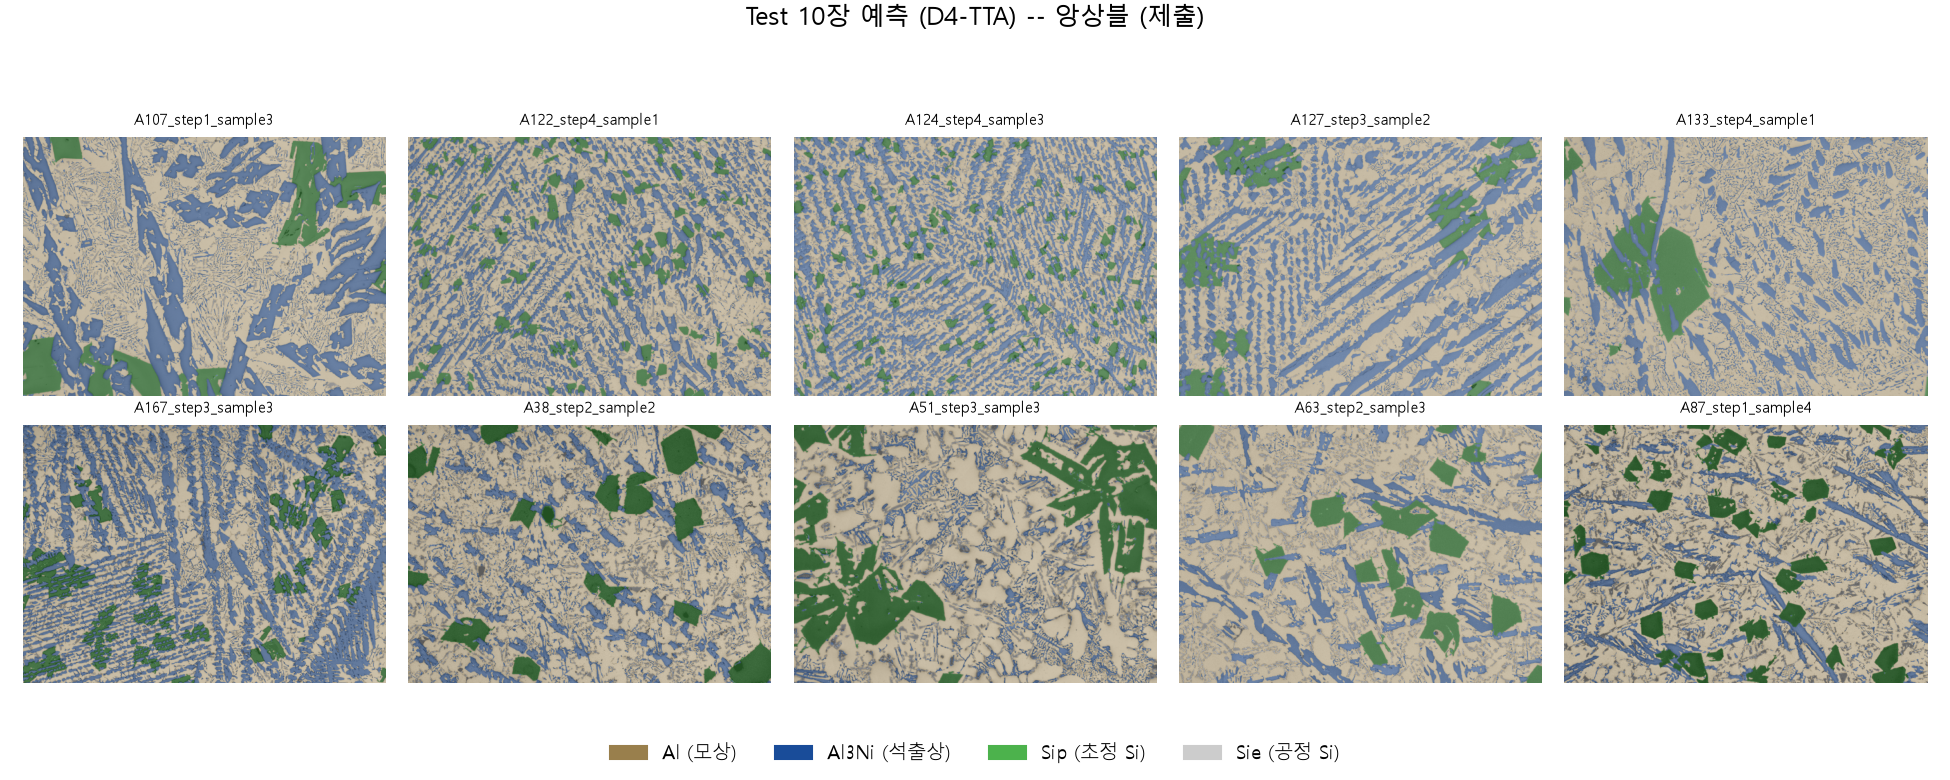
평가 이미지 10장에도 같은 앙상블·같은 추론 절차(원본 해상도, D4 TTA, 확률 평균)를 적용해 4클래스 마스크를 만들었고, 10장 모두 주최측이 요구한 형식(원본 크기, 4색 RGBA)을 만족하는지 자동으로 검증한 뒤 제출했다.
한계: 남은 오류는 어디에서 오는가
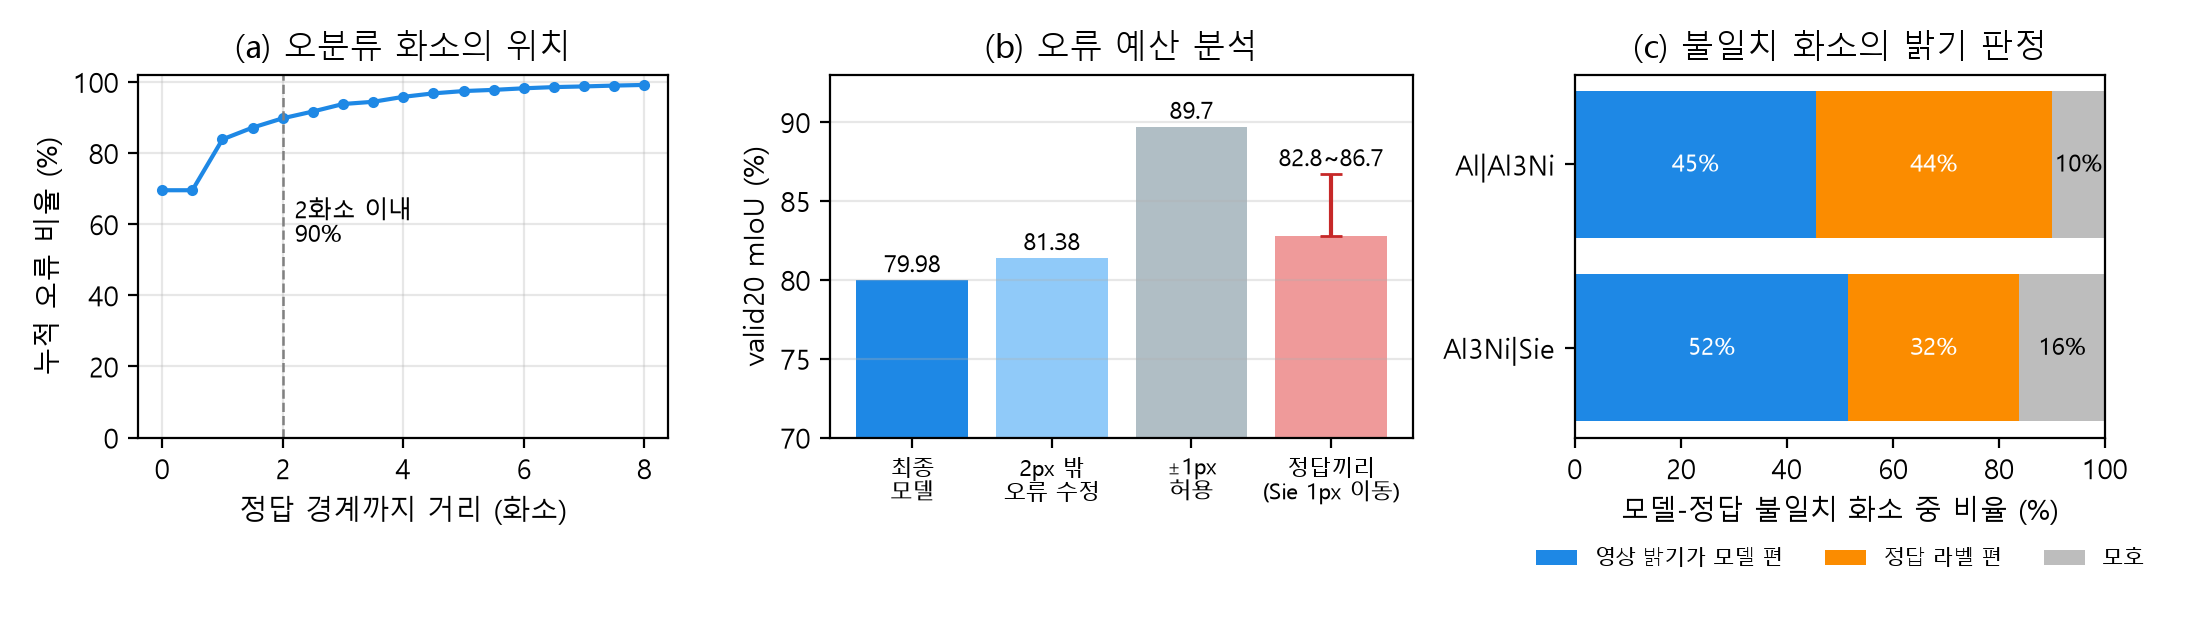
모델을 다 만든 뒤에는 남은 오류가 정말 모델의 한계인지, 아니면 다른 데서 오는지가 궁금해졌다. 오분류 화소를 분해해보니 84%가 정답 경계에서 1화소 이내, 90%가 2화소 이내에 있었다. 경계에서 2화소보다 먼 오류를 전부 고친다고 가정해도 mIoU는 81.38%에 그쳤다. 그런데 거꾸로 정답 마스크의 Sie 경계를 1화소만 옮겨서 정답끼리 비교해도 mIoU가 82.8~86.7%로 떨어졌다. 이 지표 자체가 경계 위치에 얼마나 민감한지를 보여주는 결과였다.
모델과 정답이 엇갈리는 Al3Ni·Sie 화소에서 영상 밝기가 어느 쪽 판정을 지지하는지도 확인해봤다. 모델 쪽 판정을 밝기가 지지하는 경우가 52%, 정답 쪽을 지지하는 경우가 32%였다. 불일치의 절반 가까이는 정답 라벨 자체가 영상 밝기와 어긋나는 화소라는 뜻이다. 이미지별로 경계를 1~2화소씩 옮겨가며 정답과 가장 잘 맞는 위치를 찾아봤는데도 20장 모두 이동량 0이 최적이어서, 적어도 라벨링 기준 자체가 이미지마다 다르게 그어진 것은 아니었다.
이 분석이 맞는지 확인하려고 몇 가지 추가 실험도 해봤다. 17억 장으로 사전학습된 DINOv3(Siméoni et al., 2025)의 특징을 HRNet의 저해상도 분기에만 주입하는 구조(HR-DINO)를 만들어 외부 의미 정보가 모호한 영역의 판정에 도움이 되는지 시험했고, 학습을 240 epoch로 늘리거나 저배율 이미지만 1.82배 리샘플해서 배율을 맞추는 방법도 적용해봤다. 세 가지 모두 기존 모델의 시드 변동 범위를 넘지 못했다. 특히 배율을 맞춘 뒤에도 675×480 그룹의 Al3Ni IoU가 오르지 않았는데, 이걸 보고 이 그룹의 격차가 화소 크기의 문제가 아니라 애초에 저배율로 찍히는 순간 사라지는 정보의 문제라는 걸 확인했다. 결국 지금 성능의 한계는 모델의 표현력이나 학습량이 아니라 라벨과 입력 영상 자체가 정하고 있다는 결론에 도달했다.
활용 방안
모델이 뱉어내는 상별 화소 비율은 합금의 조성 변화를 그대로 반영한다. 데이터 파일명에 들어 있는 step은 Ni 첨가 단계를 의미하는데, 같은 합금 안에서 step이 오를수록 Al3Ni 화소 비율은 평균 3.1%p 늘고 전체 Si 비율은 5.5%p 줄었다. 즉 모델의 추론 결과만 보고도 시편이 어느 조성·공정 단계에 가까운지 추정할 수 있고, 같은 단계인데 상 분율이 정상 범위를 벗어나는 시편을 공정 이상으로 자동 표시하는 품질관리 도구로 쓸 수 있다는 뜻이다. 이때 Al·Sip처럼 경계가 뚜렷한 상은 자동 판정을 그대로 쓰고, Al3Ni·Sie 경계처럼 불확실성이 큰 영역만 사람이 확인하는 2단계 방식이 현실적이라고 봤다. 또 원해상도를 보존하는 설계와 통제된 비교 실험 방법론은 다른 다상 주조 합금의 조직 분석에도 그대로 옮겨 쓸 수 있을 것이다. 앞의 한계 분석을 생각하면, 성능을 더 끌어올리려면 모델 구조를 더 손보기보다 Al3Ni·Sie 경계에 대한 다중 라벨러 재주석과 고배율 재촬영으로 라벨 품질과 입력 정보 자체를 늘리는 쪽이 더 효과적일 것 같다.
덧붙여: 보고서에는 안 들어간 것들
결과서에는 안 썼지만 실제로는 Runpod GPU 위에서 돌렸고, git 커밋 단위로 모든 실험을 추적했다(각 run 폴더에 그 학습에 쓰인 커밋이 COMMIT.txt로 남는다). 모델 선택 과정도 아키텍처(A)·증강(B)·손실(C)·구조/정규화(D, 입력 업스케일·clDice 보조손실·Lovász 혼합·가중치 EMA 네 갈래)라는 네 개 축으로 나눠 큐를 만들고 단계별로 승자를 좁혀가는 방식으로 진행했다. 최종 제출물은 단일 명령으로 md5 단위까지 재현되도록 만들어뒀는데, LightGBM 같은 스레드 비결정성이 있는 부분은 오차를 ±0.005로 고정하고 신경망 쪽은 분위수 예측을 덤프해서 CSV 경로까지 그대로 재현하도록 했다. 보고서에 담은 결론 자체는 바뀌지 않지만, 이런 재현성 장치 없이는 지금 쓴 비교들—특히 손실 함수나 앙상블 구성처럼 차이가 작은 비교들—을 신뢰하기 어려웠을 것 같다.
참고문헌
- K. Sun et al., Deep High-Resolution Representation Learning for Human Pose Estimation, CVPR 2019.
- Y. Yuan et al., HRFormer: High-Resolution Transformer for Dense Prediction, NeurIPS 2021.
- Z. Zhou et al., UNet++: A Nested U-Net Architecture for Medical Image Segmentation, DLMIA 2018.
- A. G. Roy et al., Concurrent Spatial and Channel Squeeze & Excitation in Fully Convolutional Networks, MICCAI 2018.
- F. Milletari et al., V-Net: Fully Convolutional Neural Networks for Volumetric Medical Image Segmentation, 3DV 2016.
- B. Lakshminarayanan et al., Simple and Scalable Predictive Uncertainty Estimation using Deep Ensembles, NeurIPS 2017.
- O. Siméoni et al., DINOv3, arXiv:2508.10104, 2025.