2024 OIBC BIGDATA CHALLENGE
2024년 OIBC 빅데이터 챌린지에 참가해 리더보드 기준 207팀 중 6등을 달성해 장려상을 수상했다. 공모전에 참가해 본것도 처음이었고 머신러닝에 대해 공부해본 적도 처음이었는데 운이 좋아 좋은 성과를 거둘 수 있었던 것 같다.
제주 전력시장과 SMP 가격
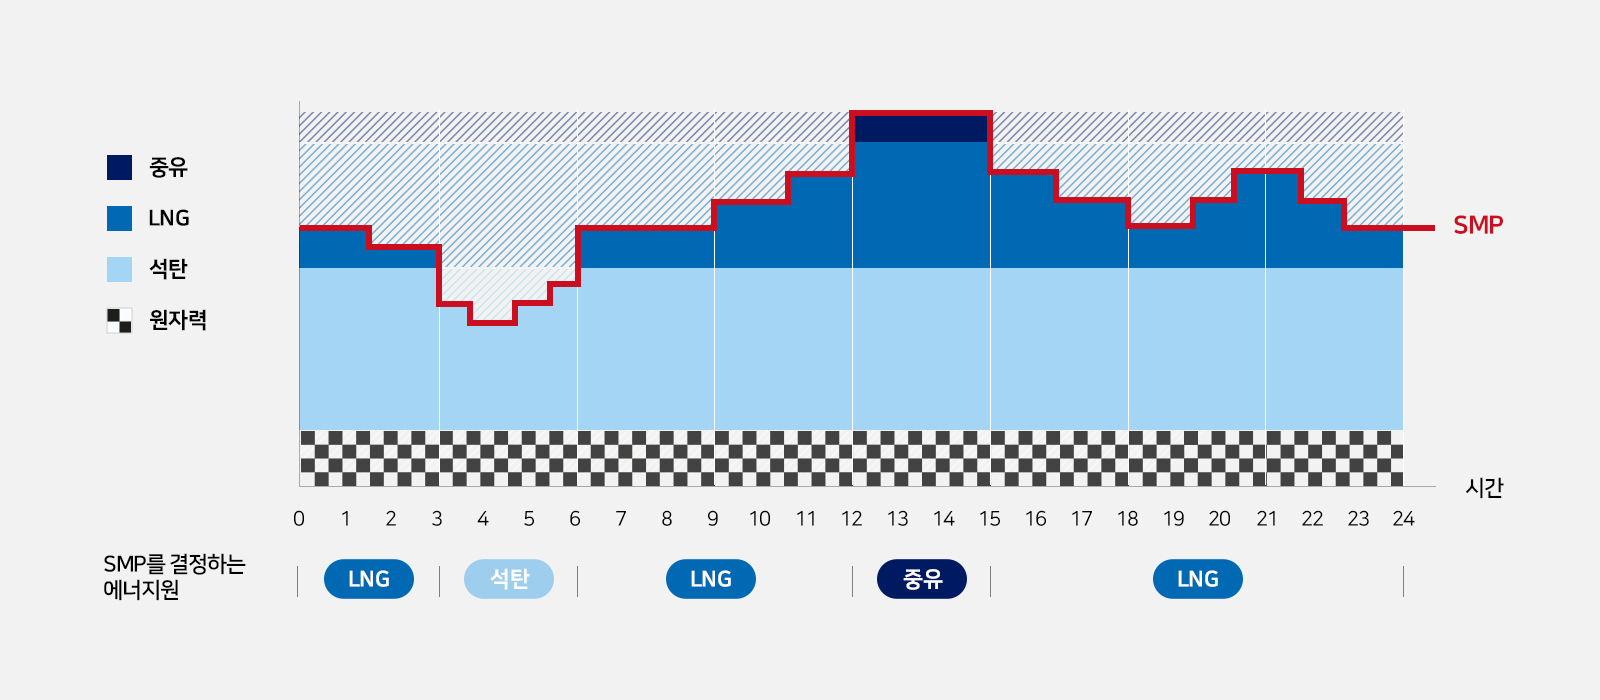
SMP는 전력 수요와 공급이 일치하는 시점에서, 그 수요를 맞추기 위해 가동된 발전기 중 변동비용이 가장 높은 발전방식의 변동비용으로 결정된다. 즉 가장 비싼 발전원이 그 시간대의 전력 가격을 정하는 구조다. 흥미로운 부분은 SMP가 음의 가격을 가질 수 있다는 점인데, 날씨 등의 요인으로 전력 수요보다 많은 발전량이 공급될 때 가격이 음수로 떨어질 수 있다. 가격이 음수로 떨어진다면 전력 공급자들은 비용을 지불하고 전력을 공급해야 하며 재가동 비용 등의 이유로 손해를 감수하고 전력을 계속 공급한다. 제주 전력시장은 전력시장 제도개선 시범사업의 일환으로 하루전시장과 실시간시장으로 나뉘어 운영되고 있었고, 본 대회에서의 예측 과제는 하루전시장의 가격이었다.
아래 그림은 하루 동안 SMP를 결정하는 에너지원이 시간대별로 어떻게 바뀌는지를 보여준다. 새벽에는 석탄이, 피크 시간대에는 LNG나 중유가 가격을 결정하는 식으로 그날의 수요 곡선을 따라 SMP를 결정하는 발전원 자체가 바뀐다는 것을 알 수 있었다.
데이터 전처리
사용한 데이터는 크게 네 가지였다. 제주 전력시장의 하루전가격(smp_da), 공급능력·현재수요·태양광 발전량 등을 포함한 전력시장 현황 데이터(7개 컬럼), 그리고 기상 관측소 두 곳의 실측 데이터(각각 19개, 12개 컬럼)였다. 각 데이터의 시간 단위가 전부 달랐기 때문(SMP 가격은 1시간 간격, 기상 데이터는 15분 간격, 전력시장 현황은 5분 간격으로 제공), 공통 타임스탬프(ts) 기준으로 1시간 간격으로 리샘플링하고 평균값을 취해 맞췄다.
대회 기간 중에는 1주일 동안의 SMP 하루전가격을 전날 00시부터 11시까지 입력해야했다. 하지만 기상실측데이터와 SMP 가격이 실제로 호출 가능해지는 시점 사이에는 딜레이가 있었고 48시간 이전까지의 측정값만으로 SMP를 예측해야 했다. 예를 들어 11월 20일의 SMP 예측값을 11월 19일 11시까지 제출해야 한다면, 실제로 쓸 수 있는 건 11월 18일까지의 측정값뿐이었다. 이러한 대회 조건을 고려해 모델 학습시에도 48시간 이전까지의 기상, SMP 가격 정보를 사용해 SMP 가격을 예측하도록 했다. 기상실측데이터는 관측소 위치 정보를 무시하고 ts 기준으로 평균값을 낸 뒤, 전체 변수에 대해 정규화를 적용했다.
변수 선택
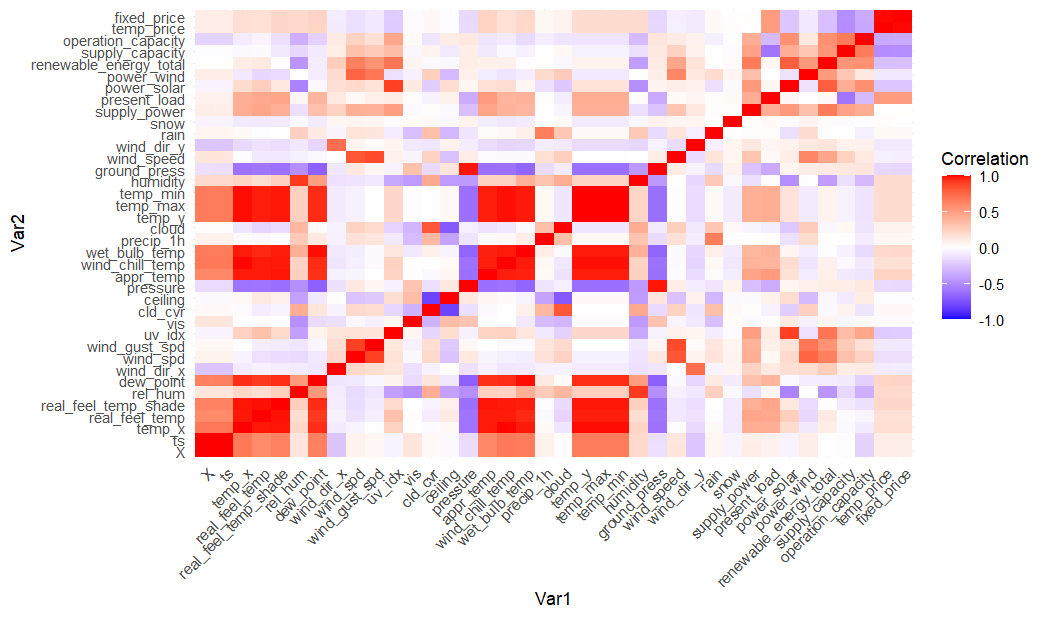
변수를 선정할 때에는 우선 SMP 가격과 상관계수의 절댓값이 0.1 미만인 변수는 사용하지 않기로 했다. 그다음 남은 변수들 사이에서 서로 상관관계가 높은 조합에 대해 VIF(분산팽창계수)를 측정해 10을 넘는 변수는 제거를 시도했다. 하지만 이는 절대적인 기준은 아니었고 여러 변수 조합으로 모델을 각각 학습시켜본 뒤 가장 성능이 좋은 조합을 선택하는 방식을 택했다. 최종적으로는 wind_spd, uv_idx, cld_cvr, ceiling, pressure, wind_dir_y, rain, snow, supply_power, power_wind 같은 변수들의 조합을 비교했다.
아래는 변수들 간 상관관계를 시각화한 히트맵이다. 기온 계열 변수들(temp_x, real_feel_temp, wind_chill_temp 등)끼리 강한 상관을 보이는 군집과, 공급 관련 변수(supply_power, operation_capacity 등)끼리 묶이는 군집이 뚜렷하게 나뉘어 보였다.
모델 설계: Conv1D + Bidirectional LSTM
메인 모델로는 Conv1D와 Bidirectional LSTM을 쌓은 구조를 사용했다. Bidirectional LSTM을 쓴 이유 전력 요금은 전후 맥락에 영향을 많이 받는데, 양방향으로 시퀀스를 처리하면 이전 시점뿐 아니라 이후 시점의 패턴까지 반영해서 현재 시점의 요금을 더 잘 설명할 수 있을 거라고 판단했다.
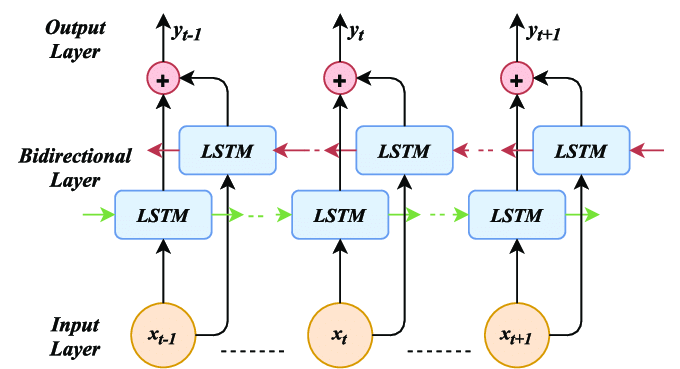
실제로 구현한 네트워크는 Conv1D로 먼저 시계열의 로컬 패턴을 추출한 뒤, Bidirectional LSTM 두 층을 거치고 Dense 층으로 마무리하는 구조였다.
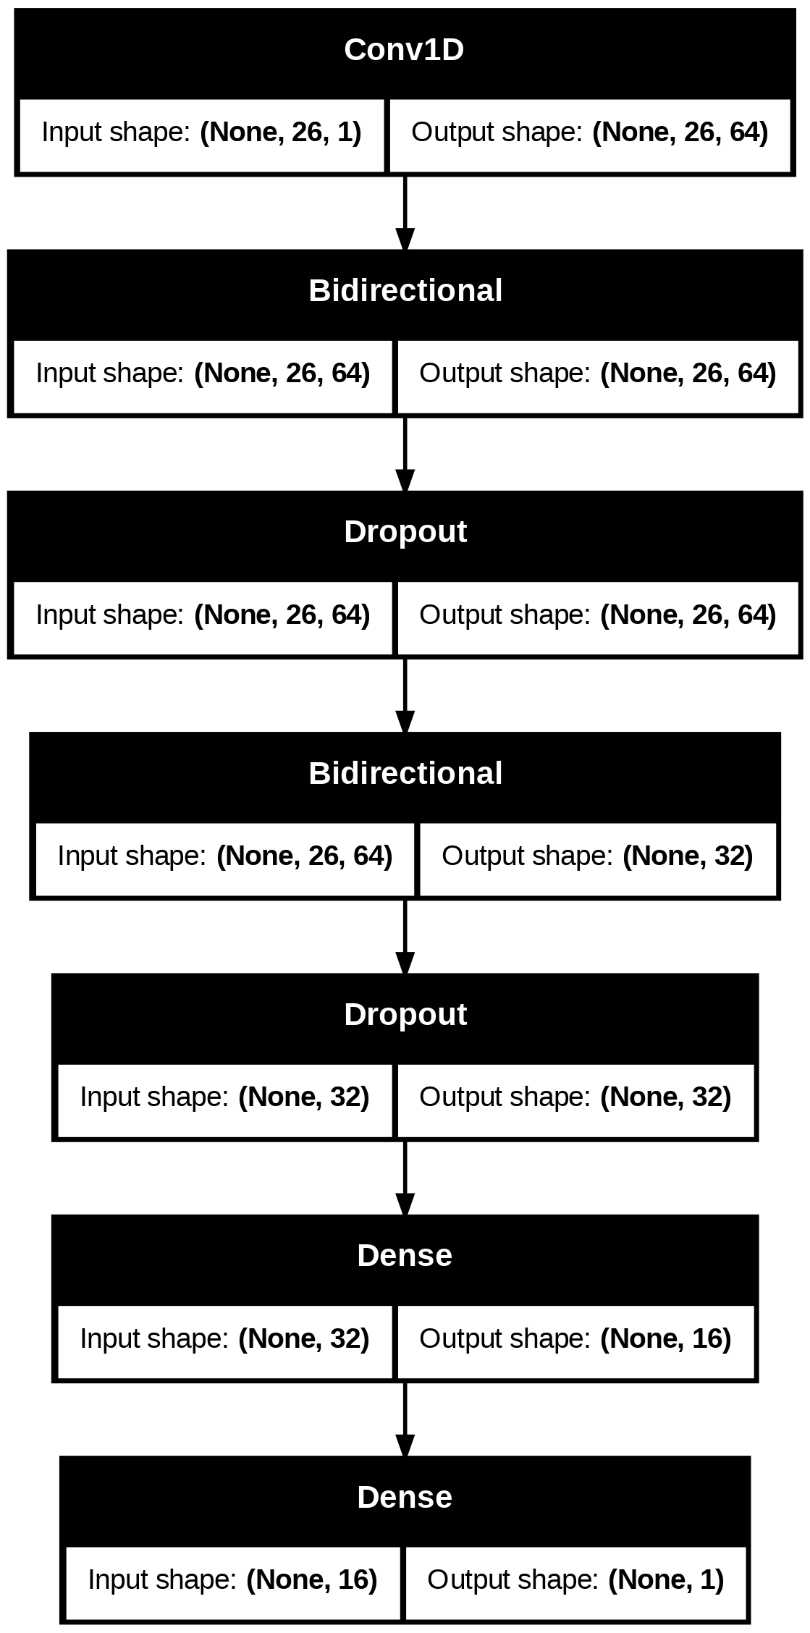
- Conv1D: 시계열 데이터에서 1차적인 특징을 추출
- Bidirectional LSTM: 양방향으로 장기 의존성을 반영
- Dropout: 과적합 방지를 위해 일부 뉴런을 무작위로 비활성화
- Dense: 최종 예측값 도출
레이어별 입출력 shape는 아래와 같다. Conv1D가 26 타임스텝짜리 입력을 64채널로 늘리고, 두 번의 Bidirectional LSTM을 거치며 64 → 32로 줄어든 뒤 Dense로 16, 최종 1개 값으로 수렴한다.
손실 함수로는 이상치에 상대적으로 덜 민감한 Huber Loss를 사용했고, Adam optimizer(학습률 0.0005)로 학습했다. 검증 손실이 10 epoch 동안 개선되지 않으면 학습을 멈추는 EarlyStopping과, 가장 좋은 가중치만 저장하는 ModelCheckpoint를 함께 적용했다.
실험 설정과 결과
Scaling 방식(Normalize / Min-Max), 변수 선택 방법(전부 사용 / 낮은 상관관계 제거 / 낮은 상관관계·높은 VIF 모두 제거), LSTM 레이어 크기(64 / 32 / 16)를 조합해가며 여러 설정을 비교했다.
| Scaling 방식 | Variable 선택 방법 | LSTM Layer |
|---|---|---|
| Normalize | 전부 사용 | 64 |
| Min-Max | 낮은 correlation 제거 | 32 |
| 낮은 correlation & high VIF 제거 | 16 |
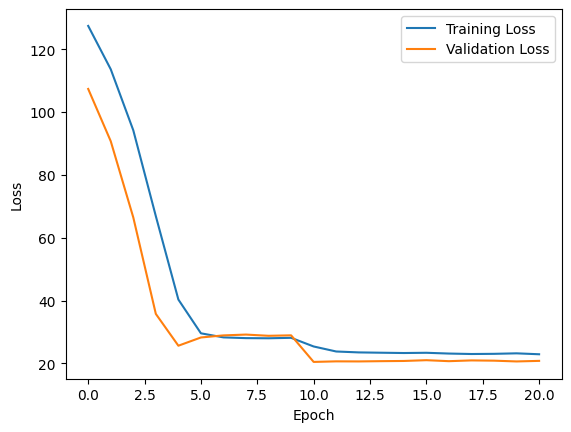
여러 조합을 비교한 끝에 최종 제출 모델의 예측 오차율은 -0.0297을 기록했다. 학습 곡선을 보면 5 epoch 근처에서 급격히 떨어진 뒤 10 epoch 전후로 수렴하는 모습이었고, training loss와 validation loss가 크게 벌어지지 않아 과적합은 심하지 않았다고 판단했다.
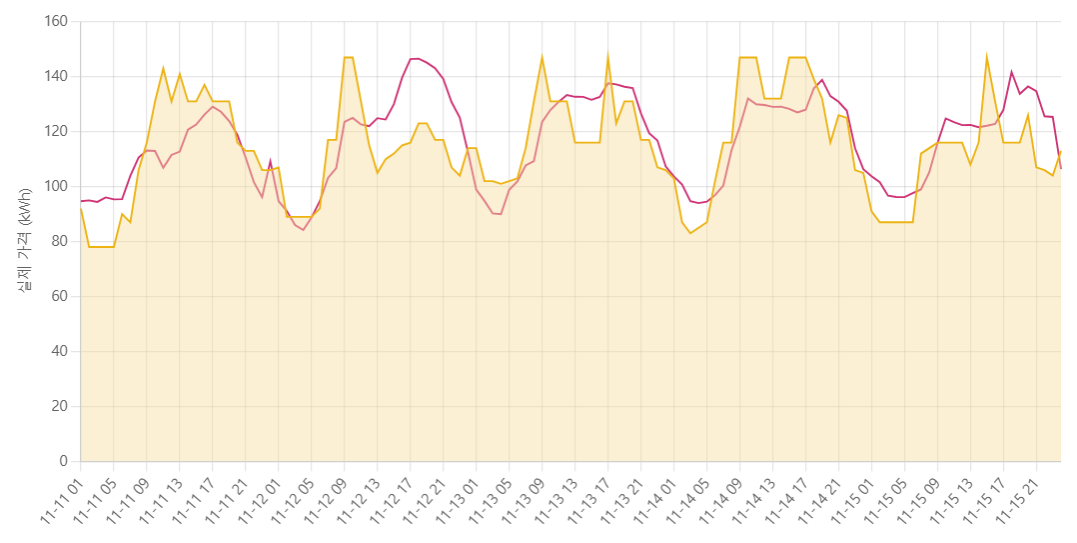
아래는 11월 11일부터 15일까지 실제 가격과 예측값을 비교한 그래프다. 전체적인 등락 패턴은 잘 따라가지만, 피크 근처에서 예측이 실제보다 다소 늦게 따라가거나 값이 작게 나오는 구간들이 보였다.
한계와 느낀점
가장 아쉬웠던 부분은 음의 전력 요금을 구체적으로 예측하는 방법을 끝내 찾지 못했다는 점이다. 음의 SMP가 신재생 에너지 발전량과 밀접한 관계가 있을 거라고 가정하고 발전량 지표와의 관계를 파악해보려 했지만, 대회 기간 중 약 6000건의 타임스탬프 중 negative SMP는 300건 정도에 불과해서 일반화하기에는 데이터가 너무 부족했다.
또 하나는 평가 기간 중 09시~11시 구간에서 예측값이 실제보다 과소 계상되는 경향성이 있었다는 점이다. 가격 변동에 더 민감하게 반응하는 모델 구조가 필요했는데, 당시에는 거기까지 손을 대지 못하고 대회를 마무리했다. 처음 머신러닝을 공부하면서 충분히 관련 이론을 이해하고 모델을 구성하려고 했고 완전히 소화를 하지는 못했어도 전반적인 문제 정의, 데이터 전처리, 모델 선정, 학습, 해석의 컨셉을 잡는데는 도움이 되었다. 또한 시계열을 다루는 기본적인 감각(시차 제약, 리샘플링, 변수 선택의 순서)을 체득한 것이 이후 다른 시계열 예측 문제를 다룰 때 많은 도움이 되었다.