Adam: A Method for Stochastic Optimization
https://arxiv.org/pdf/1412.6980
INTRODUCTION
머신러닝 등에서 손실함수를 최적화 할 때에는 gradient descent를 주로 사용하는데 이 중 널리 쓰이는 방법이 stochastic gradient descent (SGD)이다. SGD는 전체 data point가 아니라 subsample에 대해서 gradient descent를 수행해 연산량, 수렴성 등에서 이점이 있었다. 이때 subsampling, dropout을 통해 목적함수에 노이즈가 생길 수 있으며 파라미터 수가 많은 고차원 공간에서 일차 미분만을 효율적으로 다루는 알고리즘이 필요하다. 본 논문에서는 Adam이라는 최적화 방법을 제안한다. Adam은 1, 2차 모멘텀을 활용해 learning rate를 능동적으로 조절하는 알고리즘을 제안한다.
ALGORITHM
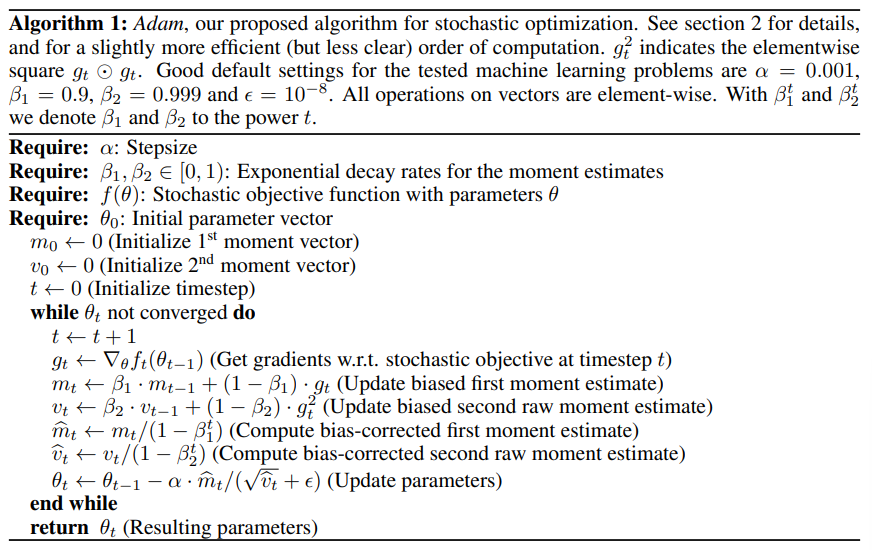
Adam의 알고리즘을 따라가보자. \(f(\theta)\)는 노이즈를 포함하는 목적함수이고 이 목적함수의 기댓값 \(\mathbb{E}[f(\theta)]\)을 최소화하는 파라미터 \(\theta\)를 찾기를 원한다. 우리는 \(f_1(\theta), \dots, f_T(\theta)\)의 각 스텝마다의 목적함수에서 sampling이나 함수 자체의 원인으로 인해 노이즈가 발생할 수 있음을 알고 각 시점에서의 sampling (minibatch)을 사용해 \(g_t=\nabla_\theta f_t(\theta)\) 그래디언트를 계산할 것이다. Adam은 각 시점의 그래디언트를 독립적으로 사용하지 않고 이전 시점 그래디언트의 1, 2차 이동 평균을 반영한다.
- \[m_t=\beta_1m_{t-1}+(1-\beta_1)g_t,\quad \hat{m}_t=m_t/(1-\beta_1^t)\]
- \[v_t=\beta_2v_{t-1}+(1-\beta_2)g_t^2,\quad \hat{v}_t=v_t/(1-\beta_2^t)\]
- \[\theta_t=\theta_{t-1}-\alpha\,\hat{m}_t/(\sqrt{\hat{v}_t}+\epsilon)\]
위 식을 합의 형태로 쓰면 다음과 같이 나타난다.
- \[m_t=(1-\beta_1)\sum^t_{i=1}\beta_1^{t-i}g_i\]
- \[v_t=(1-\beta_2)\sum^t_{i=1}\beta_2^{t-i}g_i^2\]
합의 형태로 보면 \(t\)에서 가까운 시점에서 계산된 그래디언트가 큰 비중을 차지하고 멀어질수록 그 비중이 지수적으로 감쇠한다. 그러나 여전히 이전 스텝에서의 그래디언트의 영향이 남아 있음을 볼 수 있다. \(\theta\)를 업데이트하는 수식을 보면 \(m_t\)는 그래디언트 자체의 지수 이동평균이므로 방향을 나타내고 \(v_t\)는 제곱의 지수 이동평균이므로 스케일을 나타냄을 알 수 있다. \(m_t\)는 그래디언트가 스텝마다 일관된 방향일 때 그 방향으로 파라미터를 업데이트 하게 해준다. \(v_t\)는 그래디언트의 스케일을 보정해 학습률을 조정하게 해준다. 따라서 Adam은 분자(방향)와 분모(크기) 모두 같은 그래디언트 스케일로 만들어지므로, 스케일이 서로 다른 함수들에 대해서도 learning rate 재튜닝 없이 일관된 학습을 보장한다.
INITIALIZATION BIAS CORRECTION
- \[m_t=(1-\beta_1)\sum^t_{i=1}\beta_1^{t-i}g_i\]
- \[v_t=(1-\beta_2)\sum^t_{i=1}\beta_2^{t-i}g_i^2\]
Adam에서는 위의 식을 통해 그래디언트의 1, 2차 모멘텀의 기댓값을 추정하기를 원한다. \(\mathbb{E}[m_t], \mathbb{E}[v_t]\)를 계산할 때 \(\mathbb{E}[g_i]\approx\mathbb{E}[g_t]\)을 가정하면 다음과 같이 표현된다.
\[\begin{aligned} \mathbb{E}[m_t] &= (1-\beta_1)\sum^t_{i=1}\beta_1^{t-i}\,\mathbb{E}[g_i] = (1-\beta_1^t)\,\mathbb{E}[g_t]+\zeta \\ \mathbb{E}[v_t] &= (1-\beta_2)\sum^t_{i=1}\beta_2^{t-i}\,\mathbb{E}[g_i^2] = (1-\beta_2^t)\,\mathbb{E}[g_t^2]+\zeta \end{aligned}\]\(\beta_1, \beta_2\)를 0.9, 0.999으로 설정하면 \(t\)가 작을 때 \((1-\beta_1^t), (1-\beta_2^t)\)는 0에 가깝기 때문에 초기 그래디언트가 과소 추정되는 문제가 발생한다. 이를 보정하기 위해 \(\hat{m}_t=m_t/(1-\beta_1^t), \hat{v}_t=v_t/(1-\beta_2^t)\)로 사용한다.
RELATED WORK
Adam은 RMSProp과 AdaGrad와 연관성을 가진다.
- AdaGrad: \(\theta_{t+1}=\theta_t-\alpha g_t/\sqrt{\sum^t_{i=1}g_i^2}\)와 같이 학습률을 조정하는 방식을 사용한다. 이는 Adam에서 \(\beta_1=0, \beta_2\approx1\)인 설정과 같다. 하지만 학습 후반부에는 스텝이 커져 분모가 증가해 학습률이 거의 0이 되는 문제가 발생한다.
- RMSProp: AdaGrad의 학습률 소멸 문제를 해결하기 위해 Adam과 같이 \(v_t=\beta_2v_{t-1}+(1-\beta_2)g_t^2\)와 같은 지수 이동평균을 사용한다. 하지만 1차 모멘텀과 편향 보정은 사용하지 않았다.
Adam은 AdaGrad의 파라미터별 학습률 적응 아이디어와 RMSProp의 지수 이동 평균을 통한 학습률 소멸 방지, 1차 모멘텀 적용, bias correction을 하나로 통합한 알고리즘이라고 볼 수 있다.
EXTENSIONS
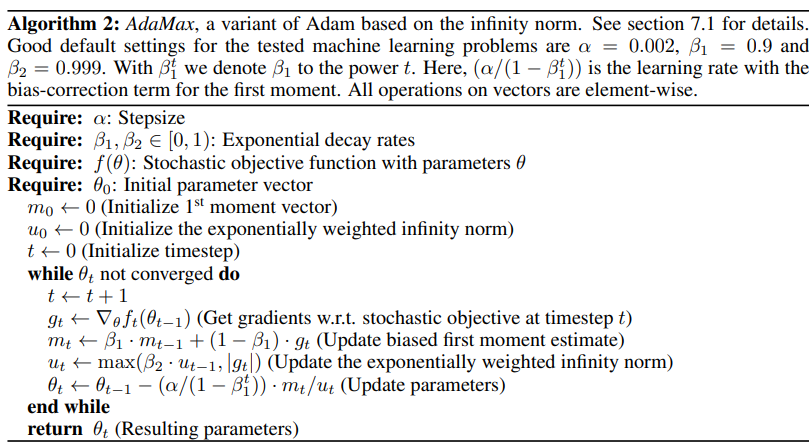
본 논문에서는 추가적으로 AdaMax라는 방법도 제시한다. Adam과 다른 부분은 \(u_t\)인데 \(u_t=\max(\beta_2u_{t-1}, \lvert g_t\rvert)\)를 사용한다. 이는 기존의 \(v_t\)에서 그래디언트의 제곱의 이동평균을 사용한 것과 달리 일반화된 \(L^p\) norm을 적용한다.
\[v_t=\beta_2^p v_{t-1}+(1-\beta_2^p)\lvert g_t\rvert^p=(1-\beta_2^p)\sum^t_{i=1}\beta_2^{p(t-i)}\lvert g_i\rvert^p\] \[\begin{aligned} u_t &= \lim_{p\rightarrow\infty}(v_t)^{1/p} \\ &= \lim_{p\rightarrow\infty}(1-\beta_2^p)^{1/p}\left(\sum^t_{i=1}\beta_2^{p(t-i)}\lvert g_i\rvert^p\right)^{1/p} \\ &= \lim_{p\rightarrow\infty}\left(\sum^t_{i=1}\beta_2^{p(t-i)}\lvert g_i\rvert^p\right)^{1/p} \\ &= \max\!\left(\beta_2^{t-1}\lvert g_1\rvert,\ \beta_2^{t-2}\lvert g_2\rvert,\ \dots,\ \beta_2\lvert g_{t-1}\rvert,\ \lvert g_t\rvert\right) \\ &= \max(\beta_2 u_{t-1}, \lvert g_t\rvert) \end{aligned}\]이와 같은 형태는 이전에 Adam에서 요구했던 bias correction이 필요하지 않으며, \(u_t \ge \beta_2 u_{t-1}\)이 항상 성립하기 때문에 그래디언트가 갑자기 작아지더라도 \(u_t\)가 \(\beta_2\) 배율보다 빠르게 줄어들지 않는다는 성질을 제공한다.
CONCLUSION
Adam은 RMSProp와 AdaGrad의 장점을 혼합해 효율적인 SGD를 수행할 수 있도록 했다. Adam은 1차 모멘텀으로 파라미터 업데이트 방향의 일관성을 제공하고 2차 모멘텀으로 학습 스케일을 동적으로 조정한다. 이는 계산량이 적고 메모리도 효율적이며 다양한 최적화 문제에서 모두 좋은 성능을 보인다.
느낀점
SGD나 Adam 모두 기본적인 gradient descent에서 연산량 감소, 수렴성을 위한 다양한 시도의 결과물이라고 생각이 든다. 직관적으로 생각해 볼때 Adam은 학습 초반에는 adaptive learning rate로 빠른 수렴이 가능하게 하지만 학습 후반 단계에서 급격한 그래디언트의 변화가 발생하는 경우 수렴 구간을 벗어날 수도 있을 것 같다. 이와 같은 관점에서 볼 때 learning rate scheduling과 같이 optimizer scheduling도 적용해 학습 초반과 후반에서의 최적 optimizer 조합을 찾아볼수도 있을 것 같다. 특히 학습 후반에는 어느 정도 수렴이 일어난 상태에서 해당 파라미터의 neighborhood에서 최적점을 찾아야 하는데 neighborhood 안에서의 최적점을 찾는 방법에 대해서도 생각해보면 좋을 것 같다.