Chain-of-Thought Prompting Elicits Reasoning in Large Language Models
https://arxiv.org/pdf/2201.11903
Introduction
언어 모델의 크기를 키우는 것(파라미터 수가 증가하는 것)은 모델 성능 향상과 학습 효율성을 가져오기는 하지만, 연산이나 상식, 기호 추론과 같은 문제를 해결 하기에는 여전히 한계가 있다. 이러한 문제를 다음과 같은 방법으로 해결하려는 시도가 있었지만 여전히 한계를 가진다.
- Natural language rationales
- 풀이 과정을 적는 것처럼 중간 과정을 포함해서 답변을 생성하도록 함
- 복잡한 풀이 과정을 포함하는 학습 데이터를 구축하는 것은 시간과 비용이 너무 많이 소요됨
- Input-output exemplars
- 관련된 예시(문제+답)를 프롬프트에 입력해서 LLM이 패턴을 파악하도록 함
- 단순히 답을 내는 문제에는 잘 작동하지만, 복잡한 추론을 요구하는 문제에서는 성능이 떨어짐
본 논문에서는 위의 두 가지 아이디어의 강점만을 합쳐 파인튜닝 없이 복잡한 문제에 대한 논리적 추론이 가능하도록 했다.
- input-chain of thought-output
- chain of thought: 자연어로 설명된 답을 도출하기 위한 사고 과정
이러한 chain of thought 프롬프팅은 추가 학습 없이 범용적인 문제에 대해서 자연어 설명 만으로 LLM의 성능을 끌어올린다는 점에서 의의를 가진다.
Chain-of-Thought Prompting
Chain of thought 프롬프팅은 수학문제를 풀 때 풀이과정을 적는 것처럼 LLM이 사고 과정을 최종 출력에 포함할 수 있도록 한다. Chain of thought 프롬프팅은 다음과 같은 장점을 가진다.
- 모델이 여러 단계를 거쳐야 하는 문제를 중간 단계 여러개로 쪼개서 더 복잡한 문제에 대해서는 더 많은 연산 자원을 할당하도록 한다.
- 모델 출력이 설명 가능하도록 하며 틀린 답변이 나온 경우 중간 단계 중 어느 부분에서 오류가 났는지 찾을 수 있도록 한다.
- 산술 연산, 상식, 기호와 같이 자연어로 설명이 가능한 대부분의 문제에 적용 가능하다.
- 파인튜닝과 같은 추가 학습 없이 프롬프트에 이러한 의사 결정 과정을 첨부하는 것 만으로 모델 성능을 향상시킬 수 있다.
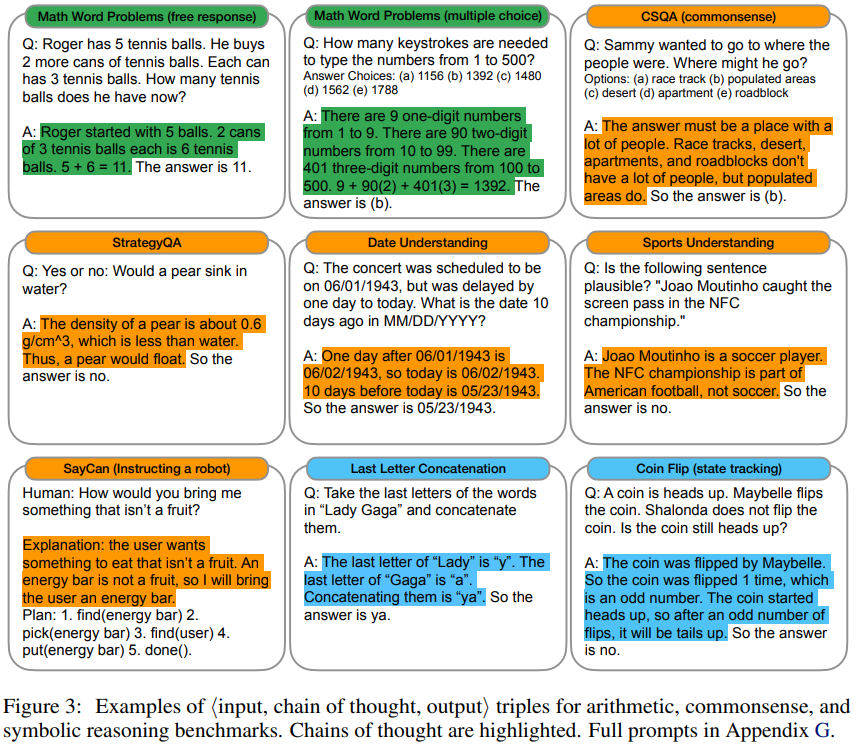
위의 그림처럼 문제, chain of thought, 정답의 형식으로 중간 풀이 과정을 프롬프트에 포함해서 이와 같은 구조로 LLM에게 문제를 풀라고 지시하는 것이 chain of thought 프롬프팅이다. 이 방법은 다양한 분야의 문제 해결에 사용될 수 있다.
Arithmetic Reasoning
일반적인 프롬프팅과 chain of thought 프롬프팅을 비교하기 위해 다음과 같이 모델이 추론 과정에서 참고할 프롬프트를 입력했다.
- Q: Roger has 5 tennis balls. He buys 2 more cans of tennis balls. Each can has 3 tennis balls. How many tennis balls does he have now?
- A: Roger started with 5 balls. 2 cans of 3 tennis balls each is 6 tennis balls. 5+6=11. (The answer is 11.)
Answer 부분에서 일반 적인 프롬프트에서는 괄호 안의 “The answer is 11.”만, chain of thought 프롬프트에서는 11이라는 답이 나오는 과정을 위와 같이 자세히 입력했다.
Arithmetic Reasoning에서 chain of thought 프롬프팅은 다음과 같은 의의를 가진다.
- Chain of thought 프롬프팅은 모델 파라미터 수에 영향을 받는다. 파라미터 수가 적은 모델에 대해서는 개선이 없거나 오히려 성능이 떨어진 반면 100B 이상의 모델에서는 성능이 향상되었다.
- Chain of thought 프롬프팅은 복잡한 문제에서 더 높은 성능 향상을 보인다. 가장 어려운 GSM8K 벤치마크에서는 GPT, PaLM 모델에서 두 배 이상의 성능 향상을 보인 반면 가장 쉬운 MAWPS 벤치마크에서는 성능 개선이 거의 없었다.
- GPT-3 175B, PaLM 540B 모델에서 chain of thought은 각 태스크에 파인튜닝된 모델의 성능을 넘어 SOTA를 달성하거나 2% 이하의 거의 근접한 성능을 냈다(SOTA on GSM8K, SVAMP, MAWPS).
모델이 chain of thought을 통해서 답을 내는 과정을 볼 때 정답을 맞추는 경우에는 논리적 과정을 거쳐 답을 냈고, 답이 틀린 경우에는 46%에서는 단순 계산 실수 등, 54%에서는 문제의 의미 자체를 틀리거나 논리가 맞지 않은 경우였다. 이는 파라미터가 많은 모델(큰 규모의 모델)에서는 모델 자체의 성능 개선으로 인해 발생 빈도가 줄어들며 chain of thought가 왜 큰 모델에서 더 잘 동작 하는지를 보여준다.
Ablation study에서는 다른 방식의 프롬프팅을 사용할 때 chain of thought 프롬프팅만큼의 성능이 나오지 않는 이유를 분석한다.
- Equation only: 중간 과정에서 자연어 설명 대신 수식만 출력하도록 하는 방법은 1, 2단계로 이루어진 간단한 문제에서는 효과적이었으나 복잡한 문제(GSM8K)에서는 효과가 없었고 이는 자연어 논리 구성 단계 없이 바로 복잡한 수식으로 넘어가는 것이 어려움을 보인다.
- Variable compute only: Chain of thought가 출력량을 늘리면서 많은 토큰을 사용해 연산 자원을 더 많이 사용하는 것이라는 가설에 대해서 수식 계산에 필요한 만큼 점을 출력(의미는 없지만 토큰을 차지)하도록 한 결과 baseline과 비교해 성능 변화가 없었다. 즉 단순히 출력 토큰을 늘리는 것이 아니라 자연어로 논리 과정을 서술함이 중요하다.
- Chain of thought after answer: 모델이 정답을 먼저 출력하고 그 뒤에 chain of thought을 붙이도록 강제했는데 이 경우 baseline과 비교해 성능 개선이 없었고 정답 도출 전의 논리적 흐름이 추론에 도움을 준다고 말할 수 있다.
Chain of thought은 특정 구조의 프롬프트에 의존적이지 않고 “논리적 흐름”이라는 형식을 갖추는 프롬프트에 대해 보편적으로 동작한다. 서로 다른 사람이 작성한 프롬프트여도, chain of thought의 핵심 아이디어만 포함한다면 baseline 모델보다 높은 성능을 보인다. 또한, 프롬프트에 들어가는 예시의 종류에 관계 없이도 성능 향상을 보인다.
Commonsense Reasoning
앞서 계산 문제에 대해 chain of thought을 적용해 성능이 개선된 사례를 보았는데, 일반적인 상식과 관련한 추론에서도 chain of thought 프롬프팅은 성능 향상에 도움이 된다. 계산 문제에서의 결과와 유사하게, 파라미터 개수가 많은 모델에서 chain of thought 프롬프팅을 적용했을 때 CSQA, StrategyQA 등에서 벤치마크 점수가 향상되었다.
Symbolic Reasoning
Chain of thought 프롬프팅은 기호 조작 분야에서도 좋은 성능을 나타낸다. 여기에서는 두 가지 벤치마크를 사용했다.
- Last Letter Concatenation: 단어의 마지막 글자들을 조합하는 문제(Amy Brown이라면 yn)
- Coin flip: 여러 조작이 가해진 뒤 동전의 상태를 추정하는 문제(A coin is heads up. Phoebe flips the coin, Osvaldo does not flip the coin. Is the coin still heads up? 이 경우 앞면인 상태에서 Phoebe만 동전을 뒤집었으므로 뒷면)
위의 두 가지 벤치마크에 대해 in domain 테스트에서는 exemplars에서와 동일한 횟수의 조작을 가하는 문제를(예시에서 단어 두 개, 사람 두 명이 등장하면 실제 테스트에서도 단어 두 개, 사람 두 명이 등장하도록), out of domain 테스트에서는 exemplars 보다 많은 횟수의 조작을 가하는 문제를 제시했다(단어 3, 4개를 제시하거나 동전을 뒤집는 횟수가 더 많게).
In domain과 out of domain에서 모두 chain of thought 프롬프팅을 적용했을 때 파라미터 수가 작은 모델에서는 성능 향상이 미미하거나 없었지만 100B 이상의 모델에서는 큰 성능 향상이 있었다. 특히 예시와 다른 기호나 표현을 사용했을 때 chain of thought의 성능이 발현하려면 큰 모델이 필요했다.
Discussion
Chain of thought 프롬프팅은 arithmetic reasoning, commonsense reasoning, symbolic reasoning에서 모두 파라미터 수가 많은 모델에 대해서 비약적인 성능 향상을 이루었고 이러한 성능 향상은 모두 파인튜닝 없이 이루어졌다. 기존의 프롬프팅 방법과 비교해서, chain of thought 프롬프팅은 모델 크기가 커질 수록 성능이 더 크게 상승하도록 하며 프롬프팅 만으로 모델이 가진 잠재력을 이끌어낼 수 있도록 한다.
Chain of thought이 가지는 한계로는 우선, chain of thought이 출력 결과에 사람이 추론하는 것과 유사한 답변을 나오게는 하지만 이것이 실제로 신경망 내부에서 “추론”이라는 과정에 수행되는지는 알 수 없다. 또한 프롬프트에 들어갈 예시를 몇 개 만드는 것은 비용이 크게 들지 않지만 파인튜닝을 위한 exemplar 데이터셋을 만드는 것은 많은 비용이 들다. Chain of thought이 거대 모델에서만 효과를 보이는데 비용적 측면에서 소형 모델에서도 추론 능력을 강화할 수 있는 방법을 찾는 것이 중요한 과제로 남는다.
느낀점
Chain of thought 프롬프팅은 파인튜닝 없이 프롬프팅만으로 모델의 추론 성능을 극대화할 수 있는 의의를 가진다. 하지만, 여전히 거대 모델의 성능을 극대화 하는 것이지 소형 모델에서는 효과가 미미하며 이는 필연적으로 모델의 추론 능력은 파라미터 수에 비례함을 보인다. Chain of thought을 기점으로 프롬프팅의 중요성이 대두된 것 같고 프롬프팅을 제대로 하지 않으면 모델의 성능을 충분히 활용하지 못할 것 같다. 출력 토큰 수가 아니라 실제 의미 있는 자연어 논리 과정이 모델 출력에 영향을 준다고 하는데 중간 출력에서 나오는 의미가 최종 정답에도 어떻게 영향을 주는지를 더 알아보고 싶다.