U-Net: Convolution Networks for Biomedical Image Segmentation
https://arxiv.org/pdf/1505.04597
1. Introduction
- 기존의 convolution network는 분류 작업에 사용되어 왔고, 이미지 input에 대한 output이 single class label의 형태로 나타났다. 하지만 다양한 이미지 처리 작업(특히 의학, 생물학 분야)에서는 결과가 localization되어 나타남을 필요로 했다(예를 들어, 세포 사진에 대해서, 각각의 기관이 무엇인지를 라벨링 해야 했다). 이에, Sliding-window setup에서는, 각각의 픽셀에 대하여, 주변의 픽셀을 학습 데이터로 넣어주었다. 이러한 방법은, network가 localized 되도록 하고, 한정된 수의 사진에 대하여 픽셀별로 training data를 구분하기 때문에 더 많은 training data를 얻을 수 있다. 하지만 이 방법에도 단점이 존재한다.
- Sliding-window의 단점 1: 각각의 patch에 대하여 network가 독립적으로 수행되어야 하고, 인접 픽셀을 학습 데이터로 사용한다는 점은 겹치는 patches에 대한 반복을 필요로 한다.
- Sliding-window의 단점 2: Localization accuracy와 use of context간의 tradeoff가 발생한다. 더 큰 patch는 localization accuracy를 줄이기 위해 더 큰 max-pooling layer을 필요로 하고, 이는 localization accuracy를 낮춘다(작은 patch는 네트워크에서 작은 맥락만을 파악할 수 있도록 한다).
- 최근의 접근 방법에서는 multiple layer의 특징을 고려한 classifier 추출을 제안했고, 이는 localization과 use of context가 동시에 가능하도록 했다.
- 본 논문에서는, “fully-convolutional-network”라고 불리는 구조를 제안한다. 이는 적은 수의 training data만으로도 더욱 정밀한 segmentation을 가능하도록 한다. 핵심 아이디어는, 연속적인 레이어를 통해 usual contracting layer을 보완하고 이때 pooling operator가 upsampling operators를 통해 대체된다. 이러한 레이어들은 output의 해상도를 높인다. Localization을 위해서, contracting path에서 획득한 고해상도의 특징은 upsampled output과 결합된다. 연속적인 레이어는 이 정보에 기반해 더 정밀한 결과를 학습할 수 있다.
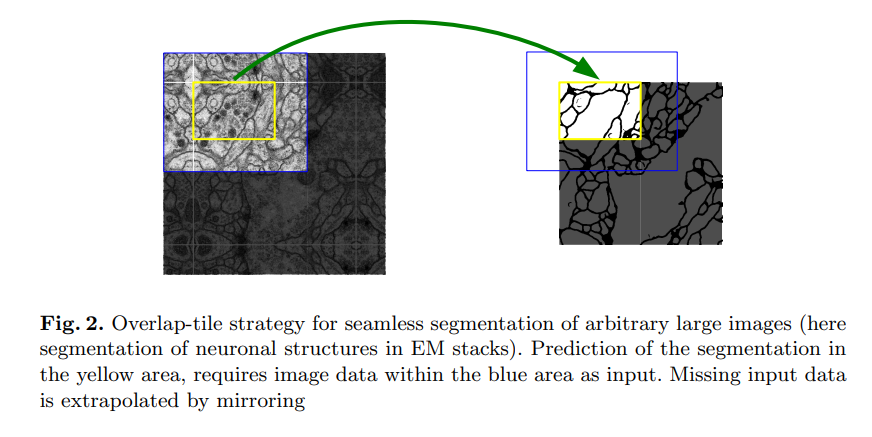
- Upsampling part에서 중요한 modification 중 하나는 네트워크가 높은 resolution의 layer에서 context information을 전파하는 것을 가능하도록 하는 것이다. 결과적으로, expansive path는 contracting path와 비교해 대칭성을 덜 가지게 되고, U 모양의 구조를 가지게 된다. 이 네트워크는 어느 fully connected layer을 가지고 있지 않고, convolution에서 가능한 부분만 사용하지만(segmentation map은 픽셀에 대한 정보만을 가지고 있지 전체 이미지를 가지고 있지 않는다) 이는 임의의 큰 이미지에 대해 overlap-tile strategy를 통해 seamless segmentation이 가능하도록 한다. Fig 2에서, 경계 부분의 이미지를 학습하기 위해 input 이미지를 대칭 변환 해 만들어 낸다.
- medical image는 데이터의 수가 아주 적어 연속적인 data augmentation의 사용을 training data에 대한 elastic deformation의 적용을 통해 수행한다. 이는 네트워크가 각각의 deformation에 대해, invariance를 학습할 수 있도록 하며, 이 과정에서 annotated image corpus에 대한 변형을 살펴 볼 필요가 없도록 한다.
2. Network Architecture
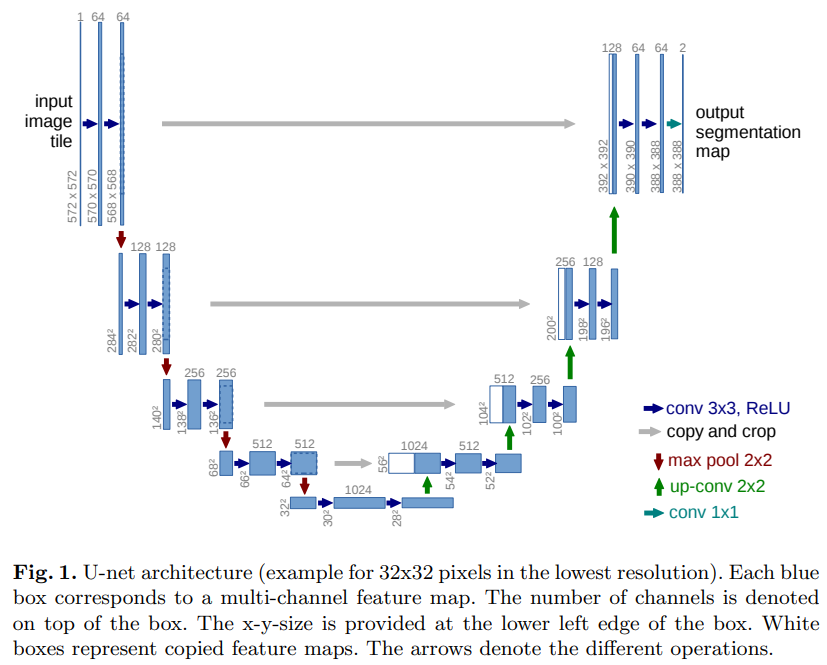
- 네트워크 구조는 위의 그림과 같다. U-Net은 contracting path와 expansive path로 구성되어 있다. Contracting path는 convolution network의 전형적인 구조를 따른다. 두 개의 3x3 convolution을 연속적으로 적용하고(Relu 함수를 recitified linear unit으로 사용), 2x2 max pooling operation을 적용한다. 각각의 downsampling step을 통해 feature channel의 수를 두 배로 늘린다. Expansive path의 모든 과정은 2x2 convolution을 통과하며 upsampling 과정으로 이루어진다(feature channel의 수가 절반이 됨). 이후 두 개의 3x3 convolution을 통과한다. 마지막 layer에서, 1x1 convolution은 각각이 64개의 feature vector을 원하는 class로 할당하도록 한다. 전체 네트워크는 23개의 convolution layer을 가진다.
3. Training
- Input image와 이에 상응하는 segment map이 train data로 사용되었고 stochastic gradient descent implementation으로 학습되었다. Convolution 과정에서 padding이 적용되지 않았기 때문에, output image가 input image 보다 작은 크기로 나타난다. Energy function은 pixel-wise soft-max로 계산되었고, \(p_k(x) = \frac{\exp(a_k(x))}{\sum_{k'=1}^K \exp(a_{k'}(x))}\)로 정의된다. 이후 cross entropy는 각각의 position에 대해 아래 함수로 penalize 한다.
요약
- Contracting path: 점진적으로 넓은 범위의 픽셀을 보며 의미정보를 추출함
- 3×3 Convolution Layer + ReLu + BatchNorm (No Padding, Stride 1) 2번
- 2x2 Max-pooling Layer(Stride 2)
- padding이 적용되지 않기 때문에 feature map의 크기가 감소함
- Downsampling할 때마다 Channel의 수가 2배씩 증가
- Bottle Neck
- 3×3 Convolution Layer + ReLu + BatchNorm (No Padding, Stride 1) 2번
- Dropout Layer
- Expanding path: 의미정보를 픽셀의 위치 정보와 결합해 각 픽셀마다 어떤 객체에 속하는지 구분하는 확장 경로
- 2×2 Deconvolution layer (Stride 2)
- 수축 경로에서 동일한 Level의 특징맵(Feature Map)을 추출하고 크기를 맞추기 위하여 이전 Layer에서 생성된 특징맵(Feature Map)과 연결(Concatenation)함
- 3×3 Convolution Layer + ReLu + BatchNorm (No Padding, Stride 1) 2번
- Contracting path의 역과정
- input은 픽셀별 RGB value, output은 각 픽셀이 어느 영역에 속하는지에 대한 segmentation 정보
- Strategies
- Overlap tile strategy: 겹치는 부분이 존재하도록 이미지를 자르고, segmentation 함
- Mirroring Extrapolate: 이미지의 경계 부분을 학습하기 위해 경계를 기준으로 이미지를 mirroring해 input으로 사용
- Weight Loss: 각 픽셀이 경계와 얼마나 가까운지 weight map을 만들고, 경계에 가까운 픽셀의 Loss를 weight map에 비례하게 증가시킴. 경계와 가까운 픽셀일수록 loss가 크게 반영되기 때문에 경계에 해당하는 픽셀을 잘 학습하게 됨.