Finetuned Language Models Are Zero-Shot Learners
https://arxiv.org/pdf/2109.01652
INTRODUCTION
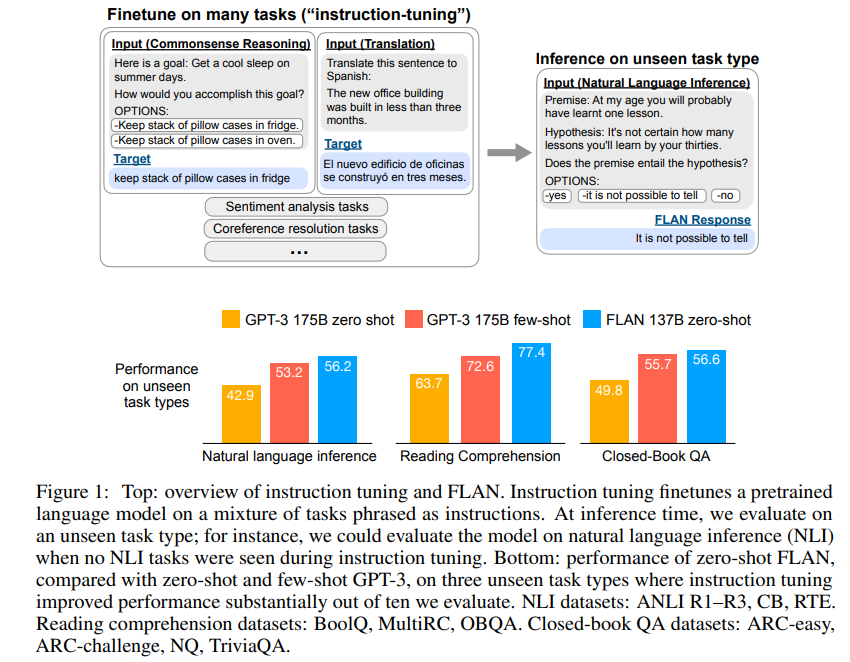
GPT-3과 같은 언어 모델은 few-shot learning(모델 프롬프트에 입력-정답 예시를 몇 개 보여주고 문제를 푸는 것)에서 좋은 성능을 내는 것을 보였다. 하지만 zero-shot에서는 few-shot보다 많이 떨어지는 성능을 보였다. 이러한 원인으로 few-shot learning에서 제공하는 예시 프롬프트가 없으면, 모델이 사전학습시에 사용된 프롬프트와 다른 형식의 프롬프트에 대응을 하지 못하는 것이 지적되었다. 본 논문에서는 LLM의 zero-shot 성능을 개선할 수 있는 방법으로 Finetuned Language Net (FLAN)을 제시한다. 이는 자연어 처리 과제가 자연어 지시문으로 설명될 수 있다는 아이디어에서 착안해 60개 이상의 NLP 데이터셋으로 모델에 대한 instruction tuning을 수행한다.
FLAN의 zero-shot 성능을 평가하기 위해서 NLP 데이터셋을 문제 유형에 따라서 나누고 모델 파인튜닝에 몇 개 유형의 데이터셋을 사용한 후 파인튜닝에 사용하지 않은 유형으로 성능을 평가한다. 예를 들어 번역, 감정 분석, 상식 추론 유형의 데이터셋이 있다고 했을 때 번역과 감정 분석으로 파인튜닝된 모델로 상식 추론 능력을 평가하는 것이다. 이는 모델 학습에 사용되지 않은 유형의 문제에 대해서도 추론 능력이 전이된다는 것을 보여준다. FLAN 137B zero-shot은 figure 1에서 볼 수 있듯이 더 많은 파라미터수를 가지는 모델인 GPT-3 175B를 zero-shot과 few-shot에서 압도했다. 또한 파인튜닝을 할 때 문제 유형을 다양화하면(more task clusters) 새로운 문제 유형에서도 성능 개선이 더 잘 일어난다.
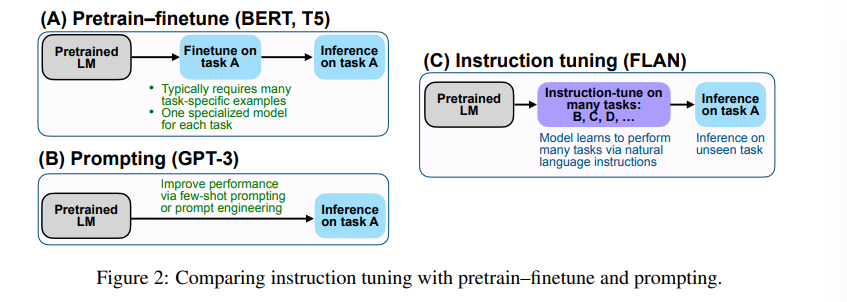
FLAN: INSTRUCTION TUNING IMPROVES ZERO-SHOT LEARNING
Instruction tuning은 언어 모델을 instruction 형태로 제시된 문제로 파인튜닝 한다면 전반적인 자연어 추론 능력이 향상되어 학습에 사용되지 않은 유형의 문제에서도 성능 개선을 보일 것이라는 의도를 가진다.
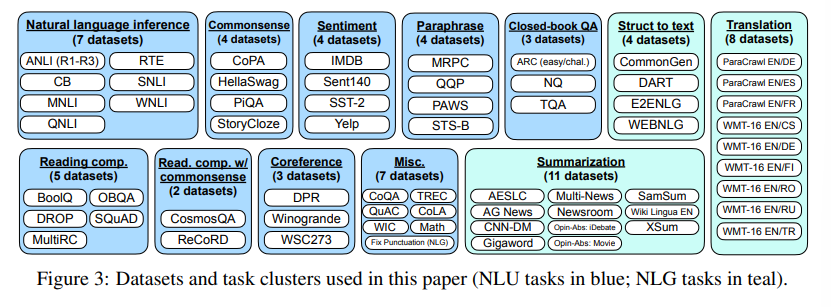
Figure 3과 같이 연구진은 기존의 데이터셋을 instruction 형태로 재가공했으며 12개의 유형으로 분류하였다. 또한 각 데이터셋에 대해 해당 과제를 자연어 지시문으로 설명하는 템플릿 10개를 구현했으며 원래 과제와 다른 형태로 변형하기도 했다.
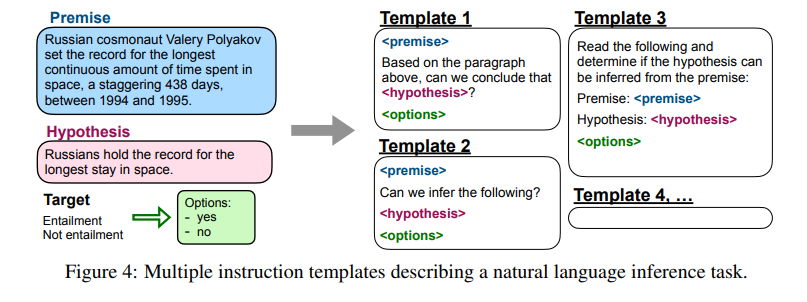
Figure 4와 같이 기존의 문제에 대해서 표현을 바꾼 다양한 instruction으로 데이터셋을 변형한 것이다. 이때 문제의 핵심 표현이나 정답은 변하지 않는다.
FLAN이 학습에 사용되지 않는 데이터셋에서도 성능 향상을 보인다는 것이 꽤나 흥미로운 점인데 이를 검증하기 위해서 tuning과 evaluation 분리가 중요했다. 일반적으로는 tuning에서 A라는 데이터셋이 사용되지 않았으면 평가시에 A라는 데이터셋을 사용하는데 FLAN에서는 데이터셋 단위가 아니라 클러스터 단위로 tuning, evaluation을 분리했다. 예를 들어 figure 3에 natural language inference 클러스터가 있는데 이에 해당하는 데이터셋 7개 전부를 tuning에서 제외하고 evaluation에서만 사용한 것이다. 즉, tuning, evaluation을 구분할 때 데이터셋 단위가 아니라 유형 단위로 구분을 했으며 이는 FLAN이 “새로운 유형”의 성능 향상에 효과가 있는 것을 보이는데 유용하다.
RESULTS
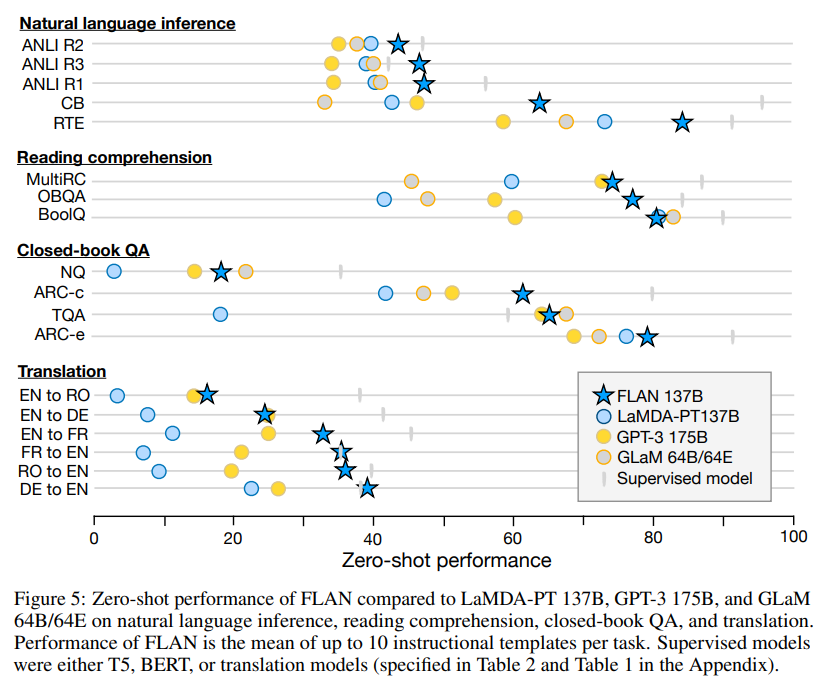
FLAN을 natural language inference, reading comprehension을 포함한 7개의 자연어 처리 문제 유형에 평가한 결과 LaMDA-PT, GPT-3, GLaM 64B/64E와 비교해서 대부분의 유형에서 높은 성능을 보였다. 특히 FLAN의 베이스라인 모델이 되는 LaMDA-PT에 대해서는 zero-shot, few-shot과 비교해서 FLAN이 더 높은 성능을 보였고 이는 instruction tuning이 자연어 처리 문제에서 실제로 모델 성능을 개선할 수 있음을 보여준다. GPT-3과 비교했을 때 20/25개의 데이터셋에서 zero-shot 성능을 뛰어넘었고 10/25개에서는 few-shot 성능까지 뛰어넘었다. GLaM에 대해서는 zero-shot에서 13/19개, one-shot에서 11/19개에서 높은 성능을 보였다. 하지만 지시문이 필요 없는 문장 내 빈칸 채우기 등 언어 모델링 유형에서는 성능 개선을 보이지 못했다.
ABLATION STUDIES & FURTHER ANALYSIS
Instruction tuning의 의의는 파인튜닝에 사용되지 않은 유형의 문제에도 그 효과가 전이된다는 것이다. 이를 위해서 파인튜닝에 사용되는 클러스터(문제 유형)의 수(1~7개)에 따라서 NLI, closed-book QA, commonsense reasoning에서의 성능을 평가하기로 한다.
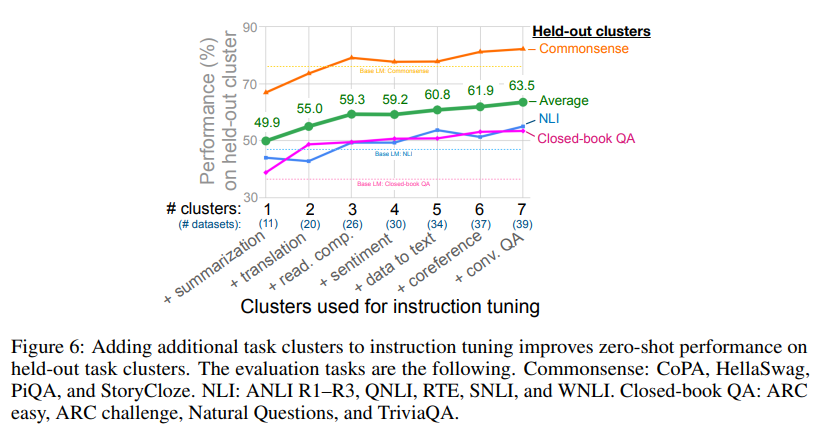
Figure 6에서 볼 수 있듯이 파인튜닝에 사용되는 클러스터 수가 증가할수록 unseen task에 대한 성능 향상 폭이 커졌다. 7개의 클러스터에 대해서 모델 성능이 포화하지 않고 계속 상승하는 것을 볼 수 있으며 이는 더 많은 클러스터에서 추가 성능 개선 여지가 있음을 보인다. 하지만, 이 실험만으로는 어느 클러스터가 성능 향상에 가장 큰 영향을 주었는지는 알 수 없다.
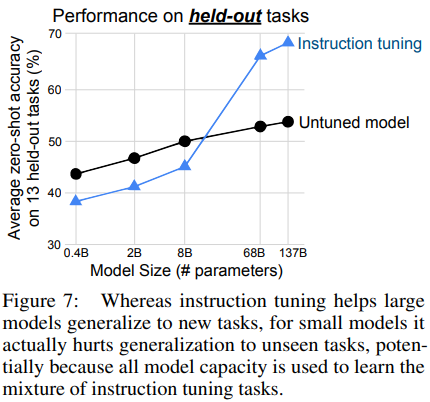
기존의 chain of thought이나 self-consistency와 같은 프롬프팅 기반의 방법은 모델 파라미터 수가 클수록 더 큰 개선을 보였다. Instruction tuning에서도 모델 파라미터 수에 따른 성능 개선 정도를 비교하기 위해 7개 클러스터로 파인튜닝을 진행했고 figure 7과 같은 결과가 나왔다. 눈여겨 볼만한 점은 8B 이하의 모델에서는 오히려 instruction tuning이 악영향을 주었다. 이는 40개 데이터셋에 대해서 파인튜닝 하는 동안 소형 모델에서는 instruction tuning이 model capacity를 포화시켜 일종의 overfitting이 발생해 unseen task에 대해서 낮은 성능을 보인다고 해석할 수 있다. 반면 대형 모델에서는 instruction tuning이 model capacity를 개선함과 동시에 모델이 보편적인 문제 유형에서 지시문을 따라 추론 능력이 강화된다고 해석할 수 있다.
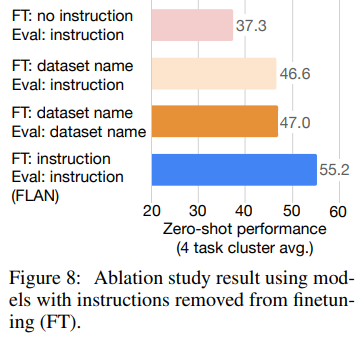
Instruction tuning에서 실제 지시문이 성능 개선에 영향을 주는지를 파악하기 위해 다음과 같은 설정으로 파인튜닝을 진행한 결과와 instruction tuning을 비교한다.
- No template: 입력과 출력만 제공(번역 문제에서 “The dog runs.”를 입력으로, “Le chien court.”가 출력으로 제공되어 사실상 문제와 답만 제공됨)
- Dataset name: 데이터셋 이름과 입력을 함께 제공(입력: [Translation: WMT’14 to French] “The dog runs.”, 출력: “Le chien court.”)
FLAN에서는 위의 두 가지와 달리 “Please translate this sentence to French”라는 instruction이 포함된다. Figure 8의 결과를 보면 FLAN이 no template, dataset name 조건보다 높은 성능을 보이며 지시문이 zero-shot 성능을 높이는데 학습에서 핵심적인 역할을 함을 보여준다.
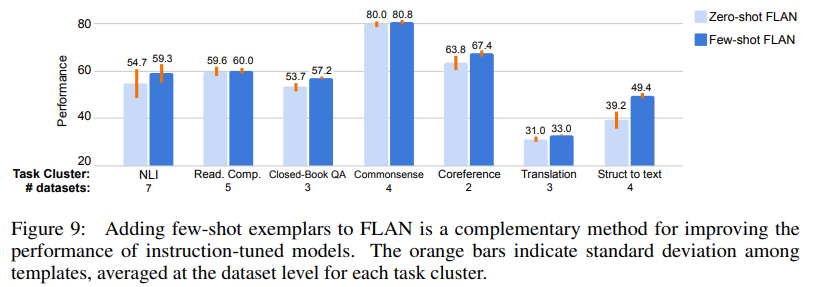
추가적으로 instruction tuning은 few-shot exemplar와 함께 사용이 될 때에도 성능 향상을 보였다.
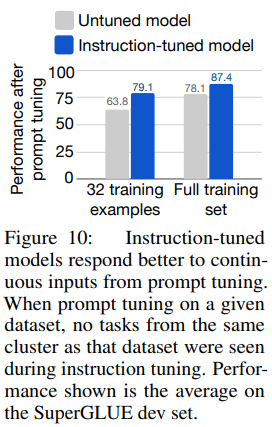
마지막으로 FLAN이 실제로 NLP 계열 문제를 수행하는데 적합해졌다면 soft prompt를 사용할 때에도 성능이 개선되어야 할 것이다. Soft prompt와 prompt tuning이 여기서 등장하는데 각각에 대한 설명은 다음과 같다.
- Soft prompt: 임베딩된 프롬프트 앞에 붙이는 학습 가능한 연속 벡터로 모델 출력 개선을 위한 학습 대상이 됨
- Prompt tuning: 기존 모델의 가중치는 고정한 채 soft prompt가 loss에 미치는 영향을 back-propagation으로 계산해 soft prompt vector를 업데이트 하는 과정
FLAN은 prompt tuning시에도 baseline 모델과 비교해 성능 향상을 보였으며 이는 instruction tuning이 NLP 문제 해결을 위한 더 적합한 체크포인트를 만들어 낼 수 있다는 것을 보여주는 또 다른 방식이다.
DISCUSSION AND CONCLUSIONS
Instruction tuning을 통해 파인튜닝의 효과가 파인튜닝에 사용되지 않은 유형의 unseen task에도 전이됨을 보였다. 또한 ablation study를 통해서 unseen task에 대한 성능은 파인튜닝에 사용되는 문제 유형의 수(number of clusters)에 비례하고, 모델 파라미터 수가 충분히 클 때에만 그 효과가 발현되고, few-shot이나 prompt tuning과 같은 프롬프팅 기법과도 동반될 수 있음을 보였다. LLM은 지금까지 특정 도메인에 특화 하는 것(specialist model)과, 범용적 과제에 적용하는 것(generalist model) 사이에서 어느 쪽을 택해야 하는지 많은 관심을 불러일으키고 있었는데 instruction tuning은 cross task generalization을 통해 도메인 특화와 범용적 적용이 상호 보완적임을 보였고 generalist model에 대한 추가적인 연구 방향을 제시한다.
느낀점
Instruction tuning은 파인튜닝에 사용되지 않은 유형의 unseen task에까지 그 효과가 전이된다는 의의를 가지며 instruction이 모델의 추론 성능 자체를 향상시킬 수 있음을 보여준다. 하지만 instruction을 포함하는 train set을 구축하는 것은 시간과 비용이 들며 기존의 벤치마크의 표현을 바꿔서 instruction을 생성했다고 했는데 그렇다면 본질적으로 다양한 유형에 대한 벤치마크가 충분히 갖춰져야 instruction tuning을 계속해서 확장할 수 있다. Instruction을 제공하는 것이 정답 청크를 생성하는데 유의미한 영향을 준다면 디코딩 과정에서 토큰 생성 확률에 instruction의 유무가 영향을 주고 파인튜닝을 통해 이를 개선할 수 있다는 것인데 이를 더 자세히 분석해보고 싶다.