Attention Is All You Need
https://arxiv.org/pdf/1706.03762
이 논문은 너무 유명해서 여러 매체에서 “세상을 바꾼 논문”이라고 표현한다. 기억상으로 ChatGPT를 처음 접한게 2023년이고 현재 GPT-6 Astra가 또 엄청난 성능으로 주목을 받고 있는데 이 모든 것의 시초가 되는 논문이 바로 “Attention Is All You Need”이다. 논문 제목과 명성은 알고 있었지만 읽어보는 것은 처음인데 다른 논문을 읽을 때와는 살짝 다른 마음가짐으로 읽어봐야겠다.
Introduction
기존까지는 RNN, LSTM, Gated-RNN과 같은 모델이 번역과 같은 시퀀스 모델링에서 가장 좋은 성능을 보였다. 이후에도 recurrent language model(순환 언어 모델)과, 인코더-디코더 구조를 개선하려는 노력이 있었다.
순환 모델은 hidden state \(h_t\)를 \(h_{t-1}\)과 \(t\)번째 입력으로 만들어낸다. 이러한 구조의 단점은 \(h_1, \dots , h_n\)을 생성하는 과정이 순차적이며 병렬화할 수 없다는 점이다. 최근 이러한 문제를 해결하기 위해 factorization이나 conditional computation 등의 방법을 사용했지만 근본적인 “순차적”이라는 문제는 해결할 수 없었다. 어텐션 매커니즘은 시퀀스 모델링에서 입력, 출력 시퀀스의 거리에 관계 없이 의존 관계를 모델링할 수 있게 해주었다. 하지만 어텐션 매커니즘은 여전히 순환 신경망과 같이 사용되었다. 이에 본 연구에서 제안하는 Transformer는 입력, 출력 의존 관계를 어텐션 매커니즘에만 의존하도록 한다.
다음으로 넘어가기 전에 RNN의 구조를 조금 살펴보자.
“The capital city of Korea is” 우리는 이 문장이 입력으로 들어왔을 때 “Seoul”이라는 단어가 출력 되게 하고 싶다. 위 문장은 총 6개의 토큰으로 구성이 되어 있고 우리는 이를 벡터로 임베딩한다.
\[\text{[The, capital, city, of, Korea, is]} \rightarrow [x_1, x_2, x_3, x_4, x_5, x_6] \text{ where }x_t=E[\text{token}_t]\]이후 우리는 토큰을 순차적으로 입력으로 넣어 hidden state을 생성한다.
\[h_t=\text{tanh}(W_x x_t+W_h\,h_{t-1}+b_h)\]\(t\)번째 hidden state에는 \(t\)번째 토큰과, \((t-1)\)번째 state인 \(h_{t-1}\)이 사용이 되며 \(h_{t-1}\)은 \((t-1)\)번째 토큰의 정보까지 포함하기 때문에 문맥을 반영할 수 있다. 이제 \(h_6\)을 사용해서 7번째로 등장할 단어인 “Seoul”을 출력해야 한다. 이때 출력층은 \(\hat{y}_t=f(W_y\,h_t+b_y)\)의 형태로 나와 우리는 다음 단어를 예측할 수 있게 된다.
이러한 유형에서 우리가 “Seoul”이라는 단어를 출력하기 위해 가장 유심히 보아야 하는 단어는 “Korea”일 것이다. 하지만 위와 같은 짧은 예시의 문장이 아니라 긴 문장에서는 \(h_i\)를 거치면서 “Korea”와 “Seoul”의 거리가 멀다면 그 관계가 희석될 수 있다. 또한, \(h_i\)를 계산하기 위해서는 반드시 \(h_{i-1}\)이 필요하다는 점에서 병렬 계산이 어렵다는 문제를 확인할 수 있다.
Background
순차적 계산을 줄이기 위해서 모든 입력/출력 위치에 대해 병렬 연산을 수행하려는 시도(ByteNet, ConvS2S)가 있었으나 단어 사이의 거리가 멀수록 연산량이 증가해 학습하기가 여전히 까다로웠다. 트랜스포머는 이를 상수번의 연산으로 고정하는 방식으로 해결할 수 있었다.
Model Architecture
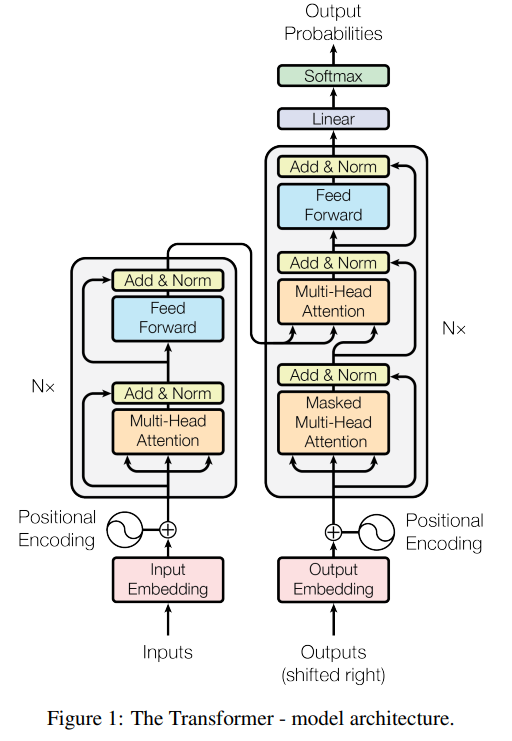
트랜스포머는 위와 같은 인코더-디코더 구조를 가진다. 인코더에서는 입력 문자열을 \(\mathbf{z}\)라는 연속적인 표현으로 변환하고 디코더는 \(\mathbf{z}\)와 shifted right outputs (이전 단계까지 생성된 문자열)을 가지고 다음 출력을 순차적으로 생성한다. 인코더와 디코더에 대해 알아보기 전에 인코더와 디코더를 구성하는 요소들을 먼저 살펴보자.
Attention
Attention은 RNN의 한계를 개선하기 위해 등장한 개념으로 다음 출력을 예측하기 위해서 중요한 토큰에 높은 가중치를 부여한다. “The capital city of Korea is”라는 입력에 “Seoul”을 출력하려면 “Korea”가 중요할 것이고 여기에 가중치를 더 부여하는 것이다.
\[e_{t, i}=\text{score}(s_t, h_i)\]여기서 \(e_{t, i}\)가 \(t\)번째 출력 위치와 \(i\)번째 입력 위치의 관련도 점수라고 하면 이는 \(s_t\)라는 디코더의 현재 상태와 \(h_i\)라는 인코더 상태로 표현이 된다. 이후 소프트맥스를 통해 \(t\)번째 출력을 위해 몇 번째 토큰이 중요한지를 수치화 한 후 context vector를 다음과 같이 생성한다.
\[c_t=\sum_i a_{t, i}\,h_i\text{ where }a_{t, i}=\frac{\text{exp}(e_{t, i})}{\sum_j \text{exp}(e_{t, j})}\]이제 \(c_t\)는 토큰의 중요도를 반영하는 벡터가 되었고 디코더에서는 \(c_t, s_t\)를 사용해서 출력 토큰을 예측한다.
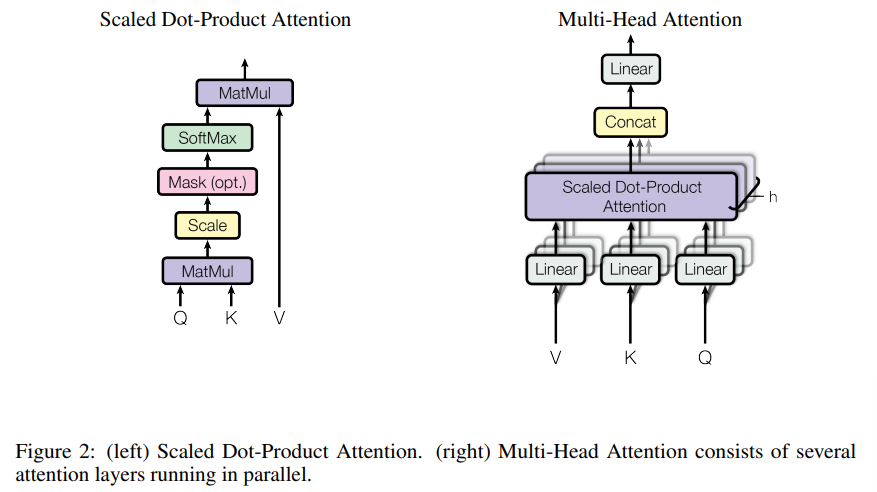
Scaled Dot-Product Attention
그렇다면, \(e_{t, i}=\text{score}(s_t, h_i)\)에서 관련성을 나타내는 \(\text{score}\)을 정의해야 한다. 본 논문에서 제안하는 scaled dot-product attention에서는 다음과 같은 구조를 사용한다.
\[\text{Attention}(Q, K, V)=\text{softmax}\!\left(\frac{QK^T}{\sqrt{d_k}}\right)V\]\(Q,K, V\)는 각각 입력 벡터에 가중치 \(W^Q, W^K, W^V\)를 곱해서 만들어진다. 비유하자면 다음과 같이 표현할 수 있다.
- \(Q\): Query (다른 단어와의 관계를 표현하는 정도를 계산할 때 사용)
- \(K\): Key (쿼리와의 비교를 통해 다른 단어가 현재 단어를 판별하는 기준이 되는 벡터)
- \(V\): Value (query, key의 관계성에 따라 최종 출력을 만들기 위해 사용)
즉 dot product인 \(QK^T\)는 두 단어의 유사도(관련도)를 제공하고, 이 값에 softmax를 취해 확률 분포로 변환 후 value를 곱해주는 형태이다. 여기서 \(\sqrt{d_k}\)로 나눠주는 이유는 내적으로 인해 특정 값이 너무 커지게 되면 소프트맥스를 취했을 때 특정 값에 확률이 쏠리게 되는데 이를 방지하기 위해 분산을 1로 맞추고자 \(\sqrt{d_k}\)로 스케일링을 해준다.
Multi-Head Attention
\[\begin{aligned} \text{MultiHead}(Q, K, V) &= \text{Concat}(\text{head}_1, \dots, \text{head}_h)\,W^O \\ \text{where } \text{head}_i &= \text{Attention}(QW_i^Q, KW_i^K, VW_i^V) \end{aligned}\]어텐션 매커니즘은 단어 간의 관계를 수치화 하지만 어텐션을 한 번만 수행하게 된다면 단어 간의 다양한 관계가 소프트맥스를 취하며 소실될 수 있다. 위와 같은 multi-head attention은 기존에 512차원 임베딩 내에서 수행하던 attention을 64차원 8개로 나누어 수행한 후 결과를 합쳐 다시 512차원으로 만든다. 8개의 sub-attention을 수행하며 문장 내에서 단어간의 관계를 더 풍부하게 학습할 수 있다.
Position-wise Feed-Forward Networks
\[\text{FFN}(x)=\max(0, xW_1+b_1)W_2+b_2\]Figure 2를 보면 multi-head attention 레이어를 통과한 후에는 feed forward network로 간다. Feed forward network에서는 선형 변환 후 ReLU 활성화 함수를 거쳐 두 번째의 선형 변환이 일어난다. 어텐션 매커니즘에서 토큰간의 문맥적 의미를 학습한 후 FFN에서 이를 비선형 활성화 함수로 융합해 단어 간의 상호 작용을 모델링하게 된다.
Positional Encoding
\[\begin{aligned} PE_{(pos,\,2i)} &= \sin\!\left(\dfrac{pos}{10000^{2i/d_{\text{model}}}}\right) \\ PE_{(pos,\,2i+1)} &= \cos\!\left(\dfrac{pos}{10000^{2i/d_{\text{model}}}}\right) \end{aligned}\]입력 토큰의 시퀀스 내부에서의 순서 정보를 제공하기 위해 positional encoding을 사용한다. Positional encoding을 위해 각 토큰마다 토큰의 순서에 따라서 순차적으로 값을 부여할수도 있지만(1, 2, 3, …) 이렇게 된다면 시퀀스가 길어질수록 위치 정보가 큰 값이 부여됨에 따라 원래 토큰의 임베딩 값을 약화시킬 수 있다. 또한 시퀀스 길이가 달라질 때에도 같은 위치의 토큰에는 같은 위치 정보가 부여되어야(10토큰 중 5번째와 100토큰 중 5번째가 같은 값을 가져야 함) 한다. 이러한 특성을 충족하기 위해 positional encoding에서는 삼각함수를 사용한다. 삼각함수는 -1~1의 값을 가지기 때문에 토큰 임베딩에 영향을 주지 않는 선에서 위치 정보를 추가할 수 있게 해준다. 또한 임베딩에서 각 차원마다 다른 주기의 삼각함수가 더해지는데 이는 서로 겹치지 않게 위치 정보를 추가할 수 있게 해준다.
Why Self-Attention
Self-attention은 다음과 같은 장점을 가진다.
- 레이어당 연산 복잡도 감소
- 병렬화될 수 있는 연산량 증가
- 장기 의존성 사이의 경로 길이 감소
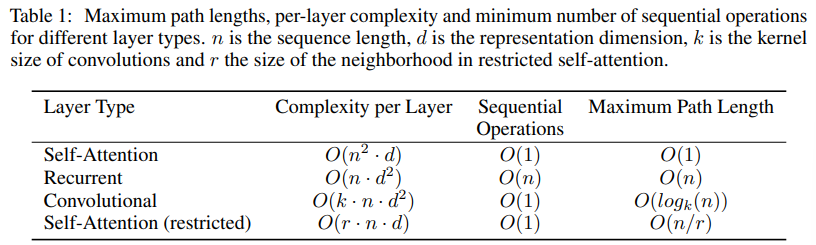
우선 기존의 RNN과 같은 sequential model은 \(n\)번째 토큰을 계산하려면 이전 \((n-1)\)번째 토큰까지의 계산 결과가 모두 필요하기에 \(O(n)\)의 시간복잡도를 가지지만 self-attention은 이것을 query-key-value 연산으로 한번에 처리하기 때문에 \(O(1)\)의 시간복잡도를 가진다. 마찬가지로 maximum path length에서도 self-attention에서는 한 번의 내적 연산으로 이를 계산하기 때문에 연산 시간복잡도에서 이점을 가진다. 총 시간복잡도는 \(O(n^2d) \text{ vs }O(nd^2)\)인데 일반적으로 512차원 임베딩을 하게 되면 입력 시퀀스는 512보다 작은 토큰 수가 들어오기 때문에 시간복잡도에서도 이점을 가진다. 물론 최근에는 입력 시퀀스가 증가함에 따라서 연산량이 폭발하기도 하는데 이는 local attention 방식으로 해결할 수 있다는 것을 향후 과제로 제시하였다.
Training & Results
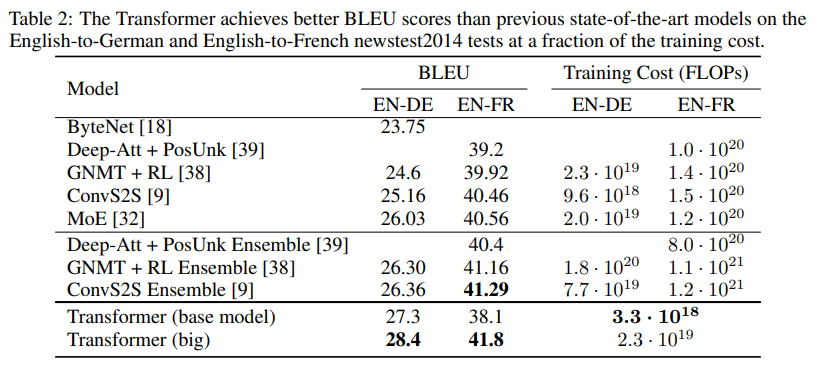
Transformer의 학습은 WMT 2014 English-German dataset과 8 NVIDIA P100 GPU, Adam optimizer이 사용되었고 기존의 기계 번역 모델인 ByteNet, ConvS2S 등을 적은 훈련 비용으로도 능가하는 성능을 보여주었다.
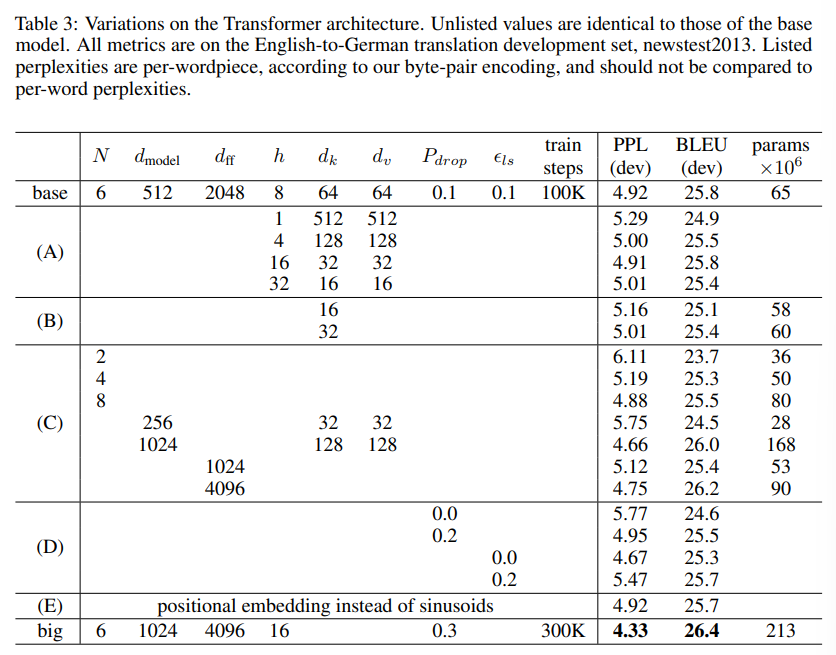
Table 3을 보면 임베딩 차원, attention layer 수, head 수와 같이 모델 아키텍처를 변경하며 실험한 결과 head 수가 너무 많거나 적으면 BLEU 점수가 떨어졌고 \(h=8\)이 가장 이상적임을 보였다. 또한, \(d_k\)가 축소 되면 모델 품질이 저하 되어 64보다 작아지면 성능이 떨어졌다. 이후 \(N, d_{\text{model}}, d_{\text{ff}}, h\)를 모두 증가한 big model에서 모델 성능이 일관되게 향상되었으며 이는 scaling law의 가능성을 보여준다.
느낀점
트랜스포머의 구조를 완전히 이해하지는 못한 것 같지만 왜 query, key, value를 사용하는 방식이 토큰 간의 관계성을 적은 연산 시간 안에 빠르게 계산할 수 있게 되는지를 알 수 있었고 기존 sequence 기반 모델의 한계를 대부분 개선한 것처럼 보인다. 하지만 아직 multi-head attention에서 저차원에서 수행한 attention을 concat하는 것 만으로 추가적인 의미, 문맥 정보를 반영한다는 효과에 대해서는 의문이 남는다. 단순히 concat하는 것이 아닌 이때 각 attention 결과 사이에도 추가적인 연관성을 추가할 수 있을 것 같다. 또한 positional encoding에서 위치 정보를 나타내는 벡터를 임베딩 벡터에 더해주는 것 만으로 위치 정보가 충분히 반영이 된다는 것이 신기하다. 여기에서도 단순 선형 결합이 아니라 가중합 등의 방식을 사용할 수 있을 것 같은데 이 부분에 대해서 더 알아보고 싶다.