Self-Consistency Improves Chain of Thought Reasoning in Language Models
https://arxiv.org/pdf/2203.11171
INTRODUCTION
이전에 chain of thought 프롬프팅으로, 다양한 분야의 문제에서(수리, 상식, 기호 등) 대형 모델의 추론 능력을 파인튜닝 없이 프롬프팅만으로 높일 수 있다는 것이 알려졌었다. 본 논문에서는 chain of thought 프롬프팅에서 사용되는 greedy decoding을 개선한 self-consistency라는 decoding 전략을 제안한다. Self-consistency는 여러 개의 추론 경로에서 각각 답을 도출한 후(sampling) 가장 일관된(consistent) 답변을 채택한다. 이는 복잡한 문제일수록 다양한 풀이 방법이 있을 수 있고, 다양한 방법이 공통적으로 내놓는 답이 정답일 것이라는 인간의 직관과도 맞아 떨어진다.
이러한 self-consistency 방식은 추가적인 검증자(verifier)이나 답변 순위를 재정렬하는 것(re-ranker)을 학습할 필요 없이 비지도방식으로 파인튜닝 없이 바로 적용이 가능하다. 또한 여러 모델을 학습시킨 결과를 앙상블 하는 방식이 아니라 단일 모델의 출력을 앙상블하는 self-ensemble이라고 볼 수 있다.
Self-consistency 방식은 UL2-20B, GPT3-175B, LaMDA-137B, PaLM-540B의 모델에서 GSM8K, SVAMP, AQuA와 같은 벤치마크에서 SOTA를 달성했다. 이는 chain of thought 프롬프팅이 자칫 역효과를 낼 수 있는 NLP 과제에서도 self-consistency는 성능 향상을 보였다는 의의가 있고 여러 앙상블 전략(sample-and-rank, beam search)도 압도한다. 한가지 눈여겨 볼만한 점은 기존에 chain of thought 프롬프팅은 100B 이상의 모델에서만 효과를 보였는데 self-consistency는 UL2-20B에서도 성능 향상을 보였다.
SELF-CONSISTENCY OVER DIVERSE REASONING PATHS
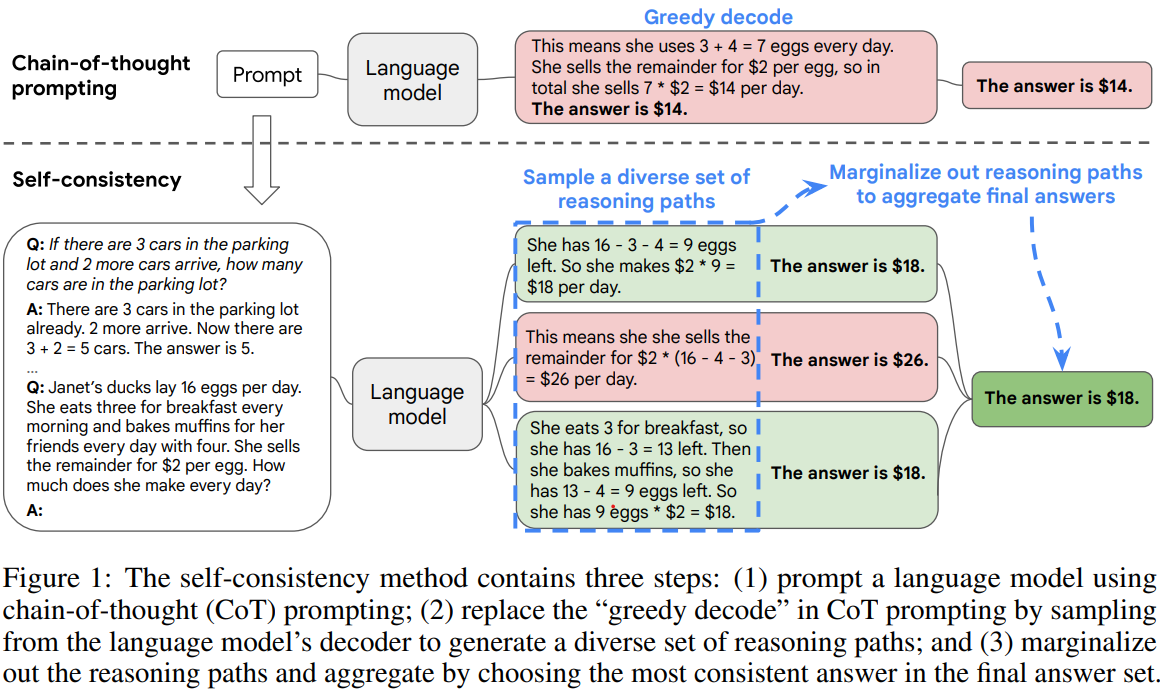
문제를 풀 때 사람마다 다른 풀이 방법을 제시하는 경우가 많고, 이는 하나의 문제에도 다양한 해결 방법이 있을 수 있다는 것을 보여준다. LLM의 디코더에서 답변을 샘플링하는 방법으로 유사한 효과를 볼 수 있다. Figure 1에서, 여러 디코딩 방식에서의 출력을 보면 모델이 문제의 정답을 맞출 수도 있고, 물론 틀린 답을 낼 수도 있다. 이처럼 LLM은 서로 다른 풀이 과정을 통해서 맞거나, 틀린 답을 낼 수 있지만 서로 다른 풀이 과정이 올바른 논리적 흐름을 따라간다면, 결국 그 답은 정답 하나로 수렴할 것이라는 가설을 세울 수 있다.
이 가설을 시험하기 위해 다음과 같은 실험을 설계한다.
- LLM을 chain of thought 방식으로 프롬프팅한다.
- 모델 디코더에서 여러 가지 추론 경로를 샘플링한다. 이때 다음과 같은 샘플링 방법이 사용된다.
- Temperature sampling
- Top-k sampling
- Nucleus sampling
- 여러 추론 경로로부터 나온 답변 중 추론 경로에 관계 없이 가장 빈도가 높게 나온 답을 최종 선택한다.
- 같은 문제에서 풀이 과정은 무시하고 가장 많이 나온 답을 선택한다.
- 즉 샘플링은 다양한 추론 경로를 만들어내기 위해서이고 추론 과정 그 자체는 답을 선정할 때 고려하지 않는다.
수식으로 표현하면 \(r_i\)라는 추론 과정을 거쳐서 \(a_i\)라는 답변이 나온다고 할 때 이때 \(a_i\)중에서 가장 많이 나온 답을 \(a\)라고 하고 이것을 최종 답변으로 선택한다. 단순히 말하면 그냥 다수결로 답을 고르는 것이다.
\[w_i = P(r_i, a_i \mid \text{prompt, question}) = \exp\!\left(\frac{1}{K}\sum^K_{k=1} \log P(t_k \mid \text{prompt, question}, t_1, \ldots, t_{k-1})\right)\]특정 프롬프트와 문제에 대해서, \(r_i\)라는 풀이 과정과 \(a_i\)라는 답을 낼 확률을 위와 같이 나타낼 수 있다. 여기서 \(\log P(t_k \mid \text{prompt, question}, t_1, \ldots, t_{k-1})\)는 \(r_i\)와 \(a_i\)에서의 \(k\)번째 토큰이 \(t_k\)일 확률로 따라서 전체 출력인 \(r_i\)와 \(a_i\)를 생성할 때 순차적으로 1번 토큰, 2번 토큰을 거쳐 마지막 토큰까지 생성될 확률을 모두 로그합으로 더한 후 토큰 개수인 \(K\)로 나누어 보정한 것이다. 이 확률을 \(w_i\)라고 하자.
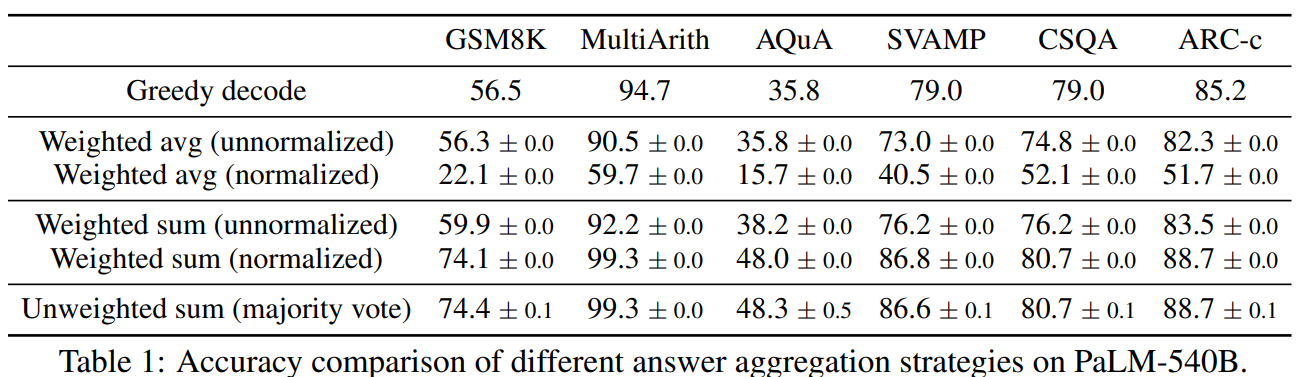
위의 표를 보면 여러 aggregation strategy에 따른 각 벤치마크에서의 test accuracy를 보여준다. 가장 아래의 unweighted sum은 이전에 말한 다수결 방식이다. 이외에도 weighted 방식이 등장하는데 이는 모델이 답한 \(a_i\)라는 답에 위의 수식의에서의 \(P(r_i, a_i \mid \text{prompt, question})\)로 가중치를 부여하는 방식이다. 즉, 가장 많이 나온 답변을 고르는게 아니라 해당 답변이 나올 확률까지도 고려한다. 각 샘플링 방법별로 답을 고르는 방식은 다음과 같이 표현할 수 있다.
- Weighted avg (normalized): \(\operatorname{argmax}_a \dfrac{\sum^m_{i=1} w_i\,\mathbb{1}(a_i = a)}{\sum^m_{i=1} \mathbb{1}(a_i = a)}\)
- Weighted sum (normalized): \(\operatorname{argmax}_a \sum^m_{i=1} w_i\,\mathbb{1}(a_i = a)\)
- Unweighted sum (majority vote): \(\operatorname{argmax}_a \sum^m_{i=1} \mathbb{1}(a_i = a)\)
Weighted와 unweighted의 차이는 토큰 길이 만큼 보정을 하느냐 하지 않느냐 차이이다. 벤치마크 결과를 보면 normalized weighted sum과 unweighted sum의 수치가 거의 동일한데 이는 모델에서 \(w_i\)가 거의 비슷하기 때문이라고 한다. 또한 weighted sum 방식에서 normalized가 unnormalized보다 큰 성능 향상을 보이고, weighted averaged 방식은 가장 성능이 떨어짐을 볼 수 있다.
기존의 연구자들은 reasoning task가 정해진 답을 가지고 있다는 점에서 greedy decoding 방식을 사용했는데 답이 정해져 있어도 추론 과정을 다양화 하는 것이 좋은 성능을 낼 수 있다는 것이 이번 실험에서 입증됐다. 하지만 이러한 샘플링 방식은 답이 정해져 있는 문제에서만 사용될 수 있고 open-text generation problem(서술형 문제 등)에서는 이를 평가할 벤치마크 등이 도입되어야 한다는 한계점이 남는다.
EXPERIMENTS
이전에 chain of thought 논문에서 수행했던 것처럼 self-consistency 방식을 평가하기 위해서 arithmetic reasoning(산술 연산), commonsense reasoning(상식 추론), symbolic reasoning(기호 추론)에 대해서 벤치마크 테스트를 진행했다.
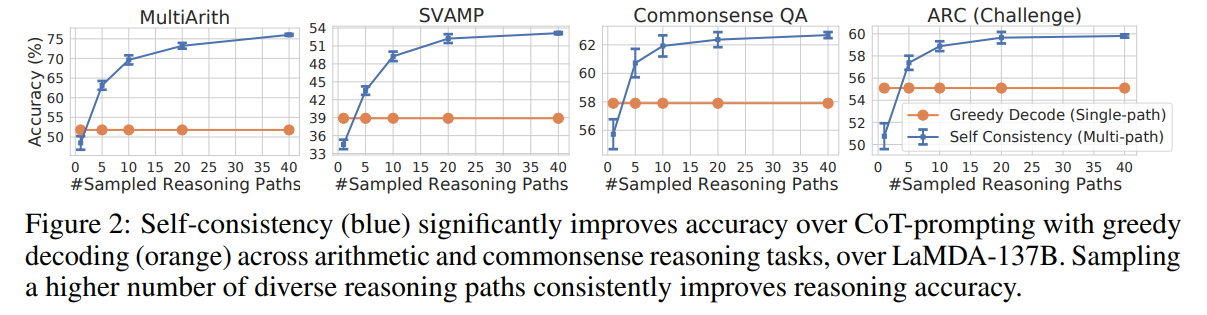
Self-consistency 방식은 chain of thought과 비교해서 arithmetic reasoning, commonsense reasoning, symbolic reasoning 모두에서 성능 향상을 보였다. 특히 기존에 chain of thought이 크게 개선을 보이지 못했던 100B 이하 모델에서도 성능 향상을 보였고 GPT-3과 같은 대형 모델에서도 추가적인 성능 향상을 보였다. 위의 표에서는 샘플링 대상이 많아질수록 정답률이 높아짐을 보이며 이는 다양한 추론 경로가 중요함을 보인다.
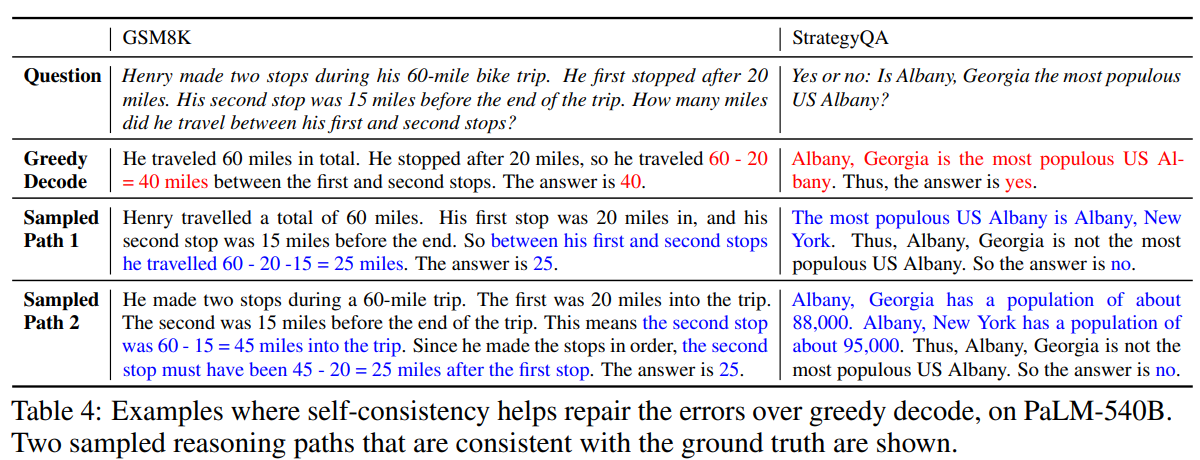
위의 표를 보면 greedy 디코딩에서는 틀린 답이 나온 반면 두 개의 sampled path에서는 정답이 나왔다. Greedy 디코딩은 각 단계에서 가장 높은 확률의 토큰을 선택하는데 확률이 높다고 해서 항상 정답은 아니라는 점이 신기한 것 같다.
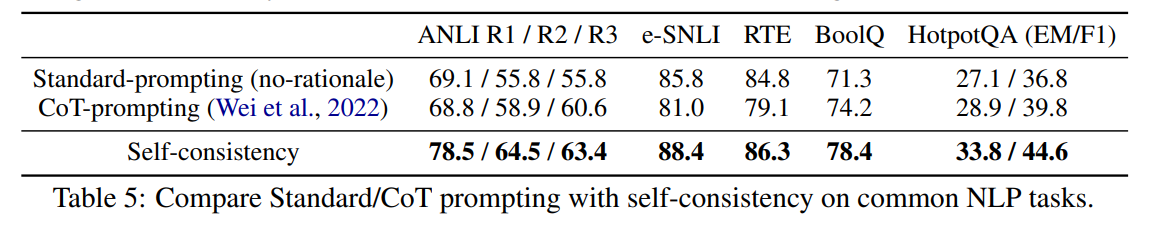
이전에 chain of thought은 정형화된 답을 내는 문제가 아닌 자연어를 정답으로 생성하는 문제에서 역효과를 보였었다. 위의 표를 보면 chain of thought이 standard prompting보다 성능이 떨어지는 것을 볼 수 있는데 self-consistency 방식은 오히려 점수가 상승했다. 여기에서도 여러 추론 경로로부터 답을 도출하는 것이 중요함을 볼 수 있다.
Self-consistency는 chain of thought의 성능만을 능가하는 것이 아니라 기존의 다른 방법론들인 sample-and-rank, beam search, ensemble-based approaches보다 뛰어난 성능을 보인다.
- Sample-and-rank: 디코더에서 여러 개의 출력을 샘플링 후 가장 log-probability가 높은 시퀀스를 선택한다.
- Beam search: 토큰 출력 후보중 beam size에 해당하는 개수의 토큰만 남기고 각 후보에서 다음 토큰을 붙여 확장한다. 이후 확장된 후보 전체에서 누적 확률이 가장 높은 beam size만큼의 후보만 남기고 이 과정을 반복한다.
- Ensemble-based approaches: prompt order permutation(예시를 프롬프트 내에서 순서를 변경), multiple sets of prompts(여러 개의 예시 집합으로 각각의 프롬프트 생성)의 방법으로 나온 답변 중 다수결로 선택(majority vote).
기존에 모델 출력을 개선하기 위한 세 가지의 방법과 비교해도 자연어 서술 벤치마크에서 self-consistency가 가장 높은 성능 향상을 보였다.
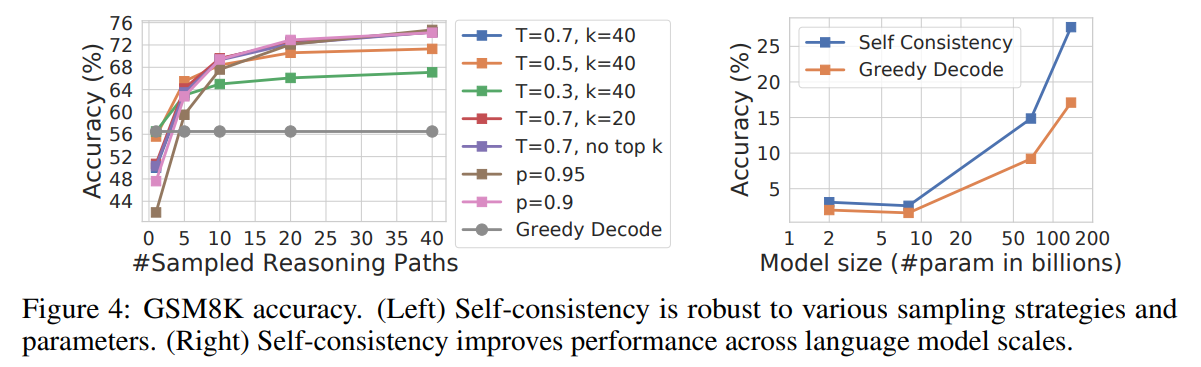
Self-consistency는 기존의 chain of thought 프롬프팅이나 sample and rank, beam search, ensemble based approach와 비교해서 모두 모델 출력을 개선함을 보였다. 더불어, self-consistency는 샘플링 전략 자체에도 강건하다. 샘플링에서 temperature을 변경하거나, \(\text{top-}k\) 샘플링에서 \(k\)를 변경할 때, nucleus 샘플링에서 \(p\)를 변경할 때에도 self-consistency는 성능 향상을 보였다. 즉 self-consistency는 특정 샘플링 방법이나 파라미터에 의존적이지 않고 추론 경로 다양화 그 자체가 효과가 있음을 입증한다. 또한, 모델 파라미터 수가 커질 수록 성능 개선 폭이 커짐 역시 Figure 4에서 볼 수 있다.
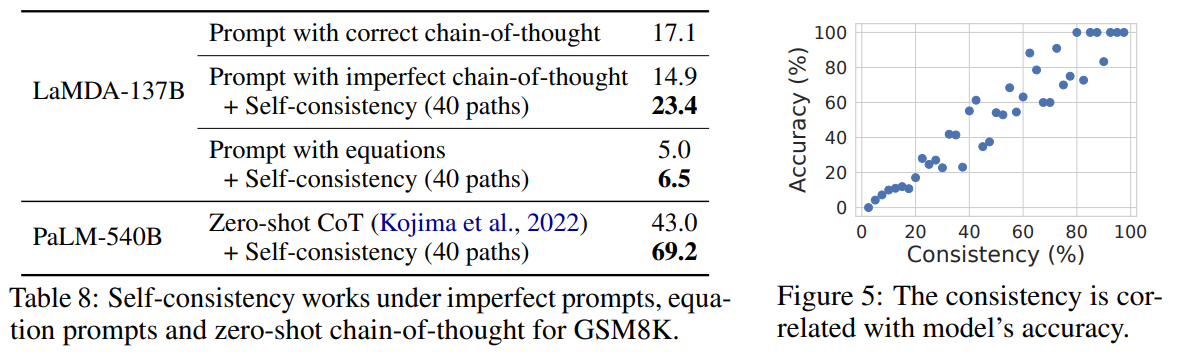
Self-consistency는 imperfect prompts에서도 강건하게 동작한다. Imperfect prompt는 프롬프트에서의 사소한 오류를 말한다.
- 사람이 2명 있는데 3명 더 온다. 2+3=6이므로 답은 6.
위와 같이 프롬프트에서 틀린 계산이나, 표현이 있어도 self-consistency는 틀린 표현으로 인해 chain of thought에서 감소하는 정답률을 보완해준다. 프롬프트에 수식을 포함하는 방식 또한 개선을 주긴는 하지만 자연어 논리 흐름을 적는 것에 비해서는 적은 개선폭을 보인다. Figure 5에서는 consistency(전체 샘플링 개수 중 선택된 답을 포함하는 비율)와 accuracy가 비례하는 경향이 나타나는데 이는 consistency를 confidence의 지표로 사용할수도 있다는 것을 보여준다.
CONCLUSION AND DISCUSSION
Self consistency는 기존의 chain of thought보다 한 단계 더 발전해 연산, 상식, 기호 등의 분야에서 뛰어난 성능을 보였다. Self consistency는 모델이 추론 과제를 수행할 때 추론의 근거를 남길 뿐만 아니라 confidence의 지표로도 사용될 수 있다는 점에서 모델의 accuracy와 confidence를 연관 짓는데 도움을 줄 수 있다. 하지만 self consistency는 샘플링을 위해 더 많은 연산을 수행해야 한다는 단점이 있다. 그러나 5~10개의 적은 샘플링 만으로도 충분한 성능 향상을 보이기는 한다. 향후 과제로 self consistency를 사용해 파인튜닝을 위한 지도학습 데이터를 구축하는 등의 방법을 고민해 볼 수 있다. 모델이 간혹 올바르지 않은 추론 경로를 따라가는 경우도 있는데 추론 근거가 사실을 더 따라가도록 개선할 필요도 있다.
느낀점
기존의 chain of thought가 프롬프팅으로 모델 성능을 개선했다면 self consistency는 추론 경로의 다양화로 모델 성능을 개선했다. 하지만 self consistency는 컴퓨팅 용량 자체를 더 많이 사용하기 때문에 tradeoff가 발생한다고 생각이 든다. Chain of thought과 self consistency 모두 모델이 가진 잠재 성능을 극대화 하는 방법이지만 결국 모델 자체의 추론 능력이 부족하다면 큰 효과를 보기 어려운 방식이다. Self consistency에서 각각의 추론 경로는 결국 모델 파라미터 수나 성능에 의존하기 때문에 결국 더 큰, 더 똑똑한 모델이 필요하기는 하다. 그럼에도 self consistency는 여러 경로의 추론, 디코딩에서 모델이 잠재적으로 맞는 답을 낼 수 있다는 것을 여러 실험을 통해 보여줬으며 디코딩 알고리즘을 변형한다고 했을 때 동일한 컴퓨팅 용량 안에서 모델 성능이 개선될 수도 있을 것 같다.