PiSSA: Principal Singular Values and Singular Vectors Adaptation of Large Language Models
https://arxiv.org/pdf/2404.02948
이번 학기 수강중인 인공지능수학 과목에서 수업시간에 다룬 PCA나 SVD가 등장하는 논문을 하나 읽고 요약하는 과제가 나왔다. 바로 직전에 LoRA 논문을 읽으면서 뭔가 가중치 행렬을 low rank 행렬로 업데이트 한다는 아이디어를 SVD를 통한 행렬의 근사 관점으로 접근할 수 있지 않을까라는 생각이 들었는데 마침 적당한 논문이 있었다. 가중치 행렬에서 “중요한” 행렬을 SVD로 판단하고, 이 행렬을 파인튜닝하는 접근이 기존 LoRA와 어떻게 차이가 있는지 살펴보자.
Introduction
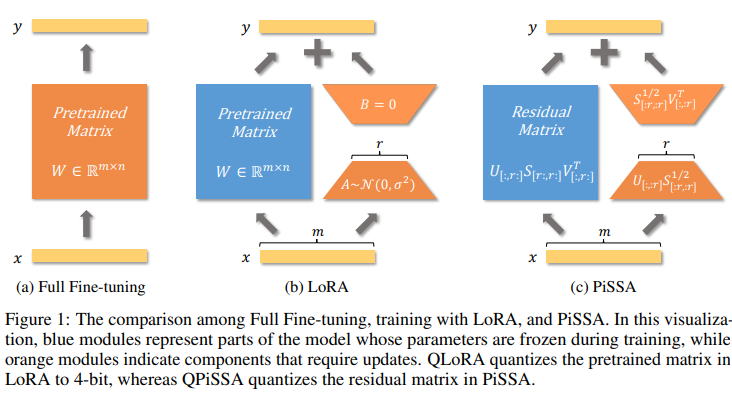
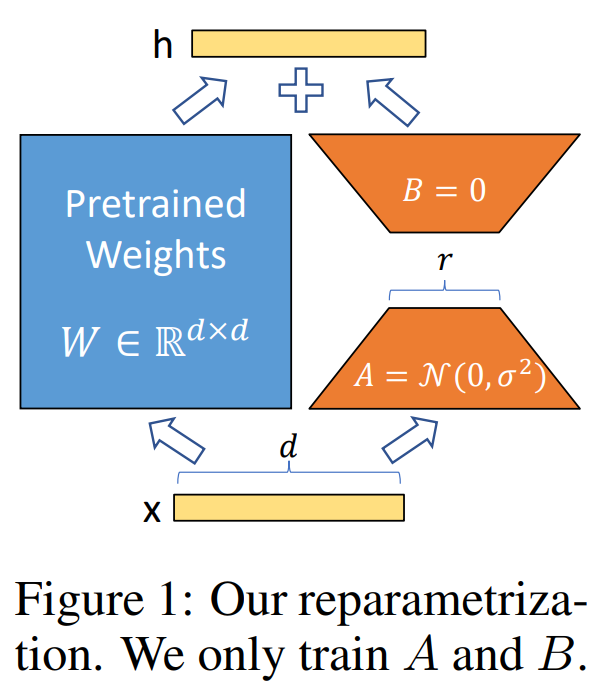
Figure 1을 보면 full fine-tuning, LoRA, PiSSA의 차이를 한눈에 볼 수 있다. 이전에 LoRA에서는 모델의 기존 가중치 행렬인 \(W\)에 \(\Delta W\)를 더해 업데이트 했는데 이때 \(\Delta W\)가 low rank matrix인 \(A, B\)로 표현이 된다. LoRA에서는 \(A, B\)의 rank를 작게 잡아 기존의 Billion 단위의 파라미터 수를 가지는 \(W\)를 직접 업데이트하는 것이 아닌 \(A, B\)를 학습해 성능과 연산 속도를 모두 잡을 수 있었다. PiSSA에서는 가중치 행렬을 residual matrix와 principal matrix로 분해한 후 principal matrix를 학습한다. 이후 더 자세히 다루겠지만 PiSSA는 LoRA와 비교해 더 빠른 수렴속도와 낮은 loss를 보이게 된다.
PiSSA: Principal Singular Values and Singular Vectors Adaptation
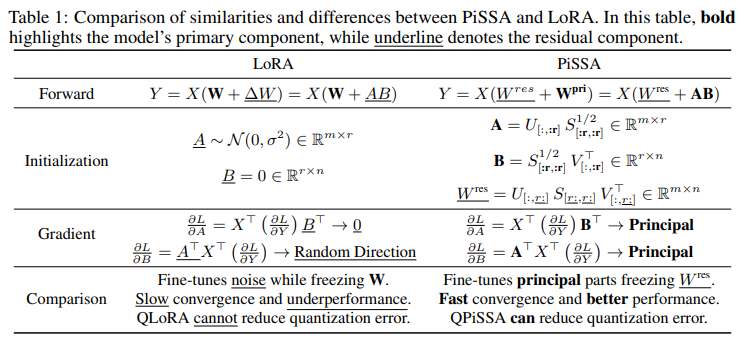
- \[\text{Residual matrix}: W^{res}=U_{[:, r:]}S_{[r:, r:]}V^\top_{[:, r:]}\in \mathbb{R}^{m \times n}\]
- \[\text{Principal matrix}: W^{pri}=AB=(U_{[:, :r]}S^{1/2}_{[:r, :r]})(S^{1/2}_{[:r, :r]}V^\top_{[:, :r]}), A \in \mathbb{R}^{m \times r}, B\in\mathbb{R}^{r \times n}\]
수식을 살펴보면 SVD 수행 후 singular value를 크기순으로 정렬 후 top-r singular value와 vector로 principal matrix를, 나머지 singular value와 vector로 residual matrix를 구성했다. Eckart-Young Theorem은 어떤 행렬을 low rank 행렬로 가장 잘 근사하기 위한 최적의 행렬이 top-r singular value와 vector을 사용해 근사하는 행렬이라는 것을 말해준다. 이와 같이 PiSSA에서도 원본 가중치 행렬을 가장 잘 근사하는 low rank 행렬로 SVD를 통해 얻었고 이 행렬을 파인튜닝의 대상으로 삼는다. 이때 Residual matrix는 건드리지 않고 “freezed”된 상태로 유지한다. LoRA와 PiSSA 모두에서 가중치 행렬에서 intrinsic dimension에 중요한 정보 대부분이 들어있을 것이라는 직관에서 시작해 저차원 행렬을 학습하는 접근을 사용하지만 PiSSA에서는 수학적으로 원본 행렬을 가장 잘 근사하는 행렬을 SVD로 찾아 이를 파인튜닝 한다는 점에서 직관에 대한 이론적 근거를 가진다. LoRA와 비교해서 PiSSA는 다음과 같은 장점을 가진다.
- LoRA는 초기에 \(A\)를 random gaussian으로, \(B\)를 영행렬으로 두고 시작하는데 이는 원본 가중치 행렬의 특징을 반영하지 못한다. 하지만 PiSSA는 \(A, B\)가 원본 가중치 행렬의 최적 저차원 근사에서 시작하기 때문에 무작위 공간이 아닌 intrinsic dimension에서 파인튜닝이 시작된다.
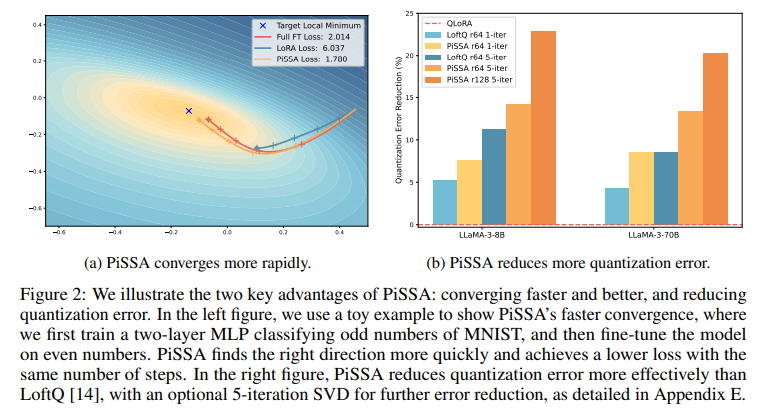
- LoRA는 초기에 무작위 값에서 시작해 파인튜닝 초반 가중치를 업데이트를 하는 방향을 찾을 때 스텝이 소비가 되어 수렴 속도가 느리지만 PiSSA에서는 불필요한 초기 탐색을 건너뛰어 수렴 속도가 빠르다.
이외에도 양자화 오차가 줄어든다는 장점도 있다고 하지만 아직 양자화에 대해서는 공부하지 않았기 때문에 넘어가도록 한다.
Experiments
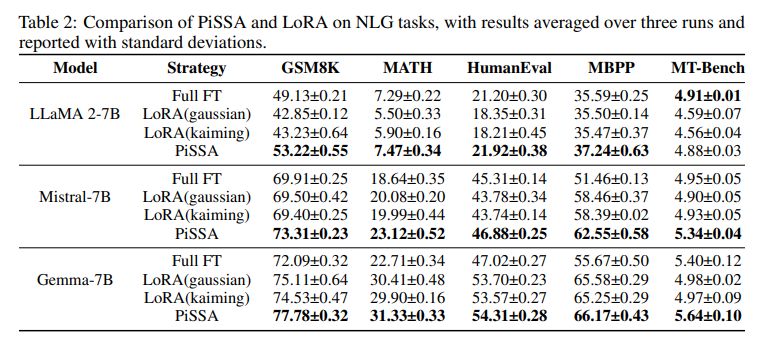
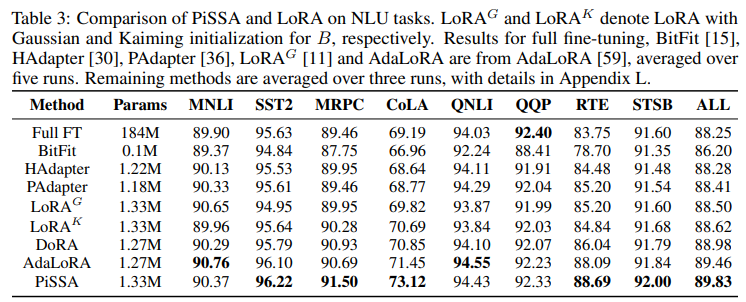
PiSSA는 NLG, NLU 태스크에 대해서 full fine-tuning이나 LoRA와 비교해서 개선된 성능을 보였다. 특히 AdaLoRA가 PiSSA보다 좋은 성능을 보인 MNLI 태스크에서도 PiSSA의 마지막 epoch에서의 평균 loss는 0.17으로 LoRA의 0.24보다 낮았고 이는 PiSSA가 수렴성에서는 LoRA보다 좋음을 보여준다.
느낀점
지금까지 논문을 읽을 때에는 논문을 이해하기 위해 수식이나 이론적 배경을 이해하는데 시간이 많이 걸렸는데 수업시간에 SVD와 SVD의 의의를 배우고 이 논문을 읽으니 PiSSA가 제안하는 방법론과 그 아이디어가 어디에서 출발했는지 더 쉽게 이해할 수 있었다. 우선 SVD로 원본 가중치 행렬을 low rank로 근사한다고 할 때 rank에 따라서 모델 성능이 얼마나 변하는지 확인해보고 싶다. PiSSA에서는 singular value가 큰 행렬을 업데이트 하고 이는 모델의 intrinsic dimension이 이 행렬에 포함된다는 직관에 기반하는데 그렇다면 large singular value를 가지는 행렬을 업데이트 한다면 오히려 파인튜닝 대상이 아닌 다른 태스크에서 모델 성능이 저하되지는 않을까 궁금하다. LoRA는 원본 행렬을 유지하고 새로운 low rank 행렬을 추가하는 반면 PiSSA에서는 large singular value를 가지는 행렬 자체를 업데이트 하기 때문에 모델 자체 성능의 방향성이 크게 변할 수 있을 것 같다. 이를 비교하려면 LoRA에서 추가되는 행렬의 singular value를 구한 후 원본 모델 singular value와 비교해 어느 정도 스케일에 있는지 판단 후 이를 PiSSA에 적용해 학습에 사용할 singular value의 스케일을 선정하거나 하는 등의 방법을 생각해 볼 수 있을 것 같다.