LoRA: LOW-RANK ADAPTATION OF LARGE LANGUAGE MODELS
https://arxiv.org/pdf/2106.09685
INTRODUCTION
많은 NLP 연구에서 LLM의 세부 분야 적용을 위해 파인튜닝을 하는 접근을 시도했다. 하지만 파인튜닝된 모델은 원본 모델과 같은 수의 파라미터를 가지게 되고 이는 점점 더 파라미터 수가 커지는 모델에 대해서 비효율적이게 된다. 그래서 이를 해결하기 위해 특정 task를 위한 사전 학습 파라미터만 불러오는 등의 방법을 사용했지만 이는 추론 시간 증가, 입력 토큰 수 감소 등의 문제가 있었고 근본적으로 파인튜닝보다 성능이 떨어진다.
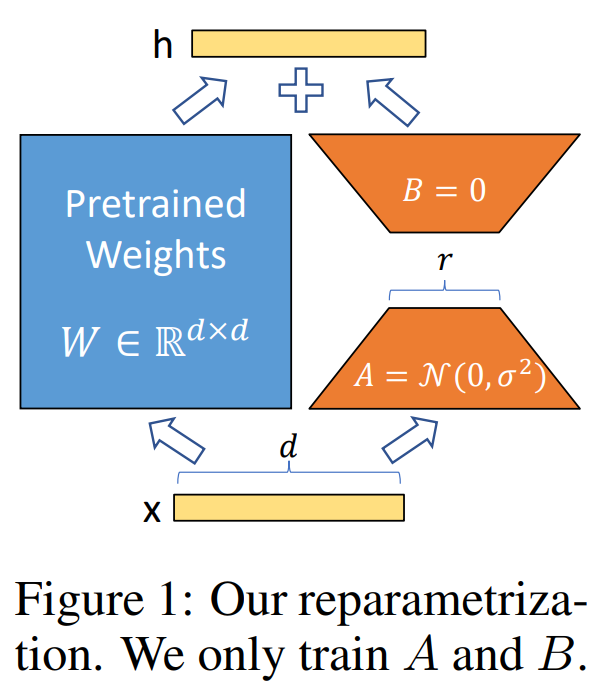
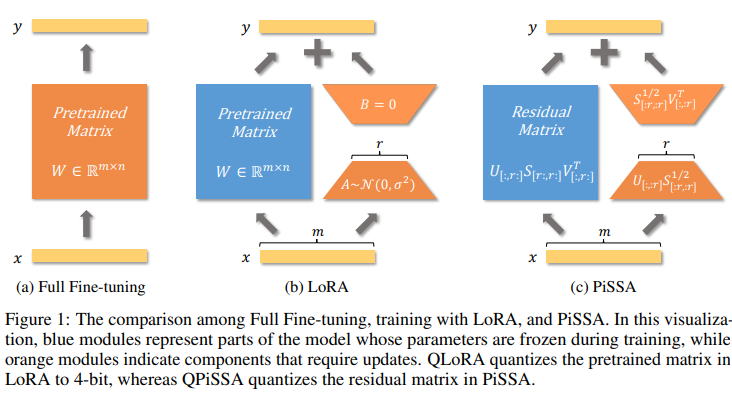
본 논문에서는 Low-Rank Adaptation (LoRA)를 제안한다. LoRA는 기존의 사전학습 가중치 행렬에서 특정 task에 영향을 미치는 원소는 극히 일부일 것이라는 직관(low intrinsic rank)하에서 전체 가중치 행렬을 학습하는 것이 아닌 낮은 rank 행렬을 학습해 학습해야 하는 파라미터의 수를 획기적으로 줄인다.
PROBLEM STATEMENT
사전학습된 모델 \(P_\Phi(y\vert{}x)\)가 있다고 해보자. 이때 우리는 이 모델의 특정 task에 대한 성능을 개선하고 싶고 이를 위한 학습 데이터가 \(\mathbf{Z}=\{(x_i, y_i)\}_{i=1, \dots, N}\)과 같이 주어진다. 예를 들어 한국어 영어 번역을 학습하고 싶다고 하면 \(x_i\)는 한국어 문장, \(y_i\)는 영어 문장이 된다. 쉽게 말하면 문제, 정답 쌍이 주어진다는 것이다. 기존의 full-tuning에서는 다음과 같이 가중치 \(\Phi\)를 업데이트 한다.
\[\max_{\Phi}\sum_{(x, y)\in\mathbf{Z}}\sum^{|y|}_{t=1}\log(P_\Phi(y_t|x, y_{<t}))\]위 수식을 풀어보자면 모든 학습 데이터 쌍에 대해서 언어 모델이 자기회귀적(autoregressive)으로 토큰을 생성한다고 할 때 각 입력 토큰에 따른 각 단어별 예측 확률이 된다.
\[\begin{aligned} &x=\text{사과는 맛있다},\ y=\text{Apple is delicious}\\ &\sum^{|y|}_{t=1}\log(P_\Phi(y_t|x, y_{<t}))=\log(P_\Phi(\text{Apple}|\text{사과는 맛있다}))+\log(P_\Phi(\text{is}|\text{사과는 맛있다, Apple}))+\log(P_\Phi(\text{delicious}|\text{사과는 맛있다, Apple is})) \end{aligned}\]이렇게 이전 토큰까지가 입력으로 주어졌을 때 다음 토큰이 나올 확률의 합을 최대화 하는 것이 목표이고 이를 모든 데이터 쌍에 대해 수행한다. 이때 현재 파인튜닝 방식의 문제점은 \(\Phi\)와 동일한 크기의 파라미터를 매번 태스크에 대해 파인튜닝할 때 학습해야 한다는 것이며 최근의 모델들은 billion 단위의 파라미터 수를 가지기 때문에 이는 매우 비효율적이다.
\[\max_{\Theta}\sum_{(x, y)\in\mathbf{Z}}\sum^{|y|}_{t=1}\log(P_{\Phi_0+\Delta\Phi(\Theta)}(y_t|x, y_{<t}))\]본 논문에서는 \(\Phi\) 대신 \(\Theta\)라는 원본 모델의 파라미터 수보다 훨씬 적은 수의 가중치를 학습해 연산량과 메모리 효율성을 높이는 방법을 제안한다.
OUR METHOD
\[W_0+\Delta W=W_0+BA\]LOW-RANK-PARAMETERIZED UPDATE MATRICES
기존의 가중치 행렬 \(W_0\)을 업데이트할 때 우리는 \(\Delta W\)를 더하는 방식으로 생각할 수 있는데 이때 \(\Delta W=BA\)와 같이 분해한다. 예를 들어 \(W_0\)가 100 by 100 행렬이라고 해보자. 그러면 \(W_0\)는 10000개의 원소를 가지고 있고 \(\Delta W\)를 구할 때에도 10000개의 원소를 학습해야 한다. 이때 우리가 \(B\)가 100 by 1, \(A\)가 1 by 100으로 두고 \(B, A\)를 학습시킨다면 각각 100개씩 총 200개의 원소만 학습을 해도 \(BA\)는 100 by 100이 되어 가중치를 업데이트할 수 있다. 이때 \(B\)는 0행렬로, \(A\)는 가우시안 분포를 따르게 해 초기 \(BA\)가 0행렬이 되게 만들어 초기값에서도 baseline 모델의 성능을 그대로 보존한 상태에서 출발할 수 있도록 한다.
이러한 접근은 특정 task에 맞게 모델을 튜닝하기 위해서는 intrinsic dimension에 해당하는 부분만 건드려도 충분하다는 직관에서 나온다. 즉 수십억개 이상의 파라미터 중 특정 파라미터 몇 개(low intrinsic dimension)만 조정해도 전체 파라미터를 업데이트 하는 것과 동일한 성능이 나온다는 것이다.
LoRA에서는 \(r <\min(d, k)\)로 설정한다. 즉 원래 파라미터보다 작은 rank를 사용해 학습해야 하는 파라미터 수를 줄여 계산상의 이점을 취한다. 하지만, 이때 \(r=\min(d, k)\)이라면 이는 원본 가중치 행렬과 같은 rank의 행렬을 학습시키는 것과 같고 사실상 기존 파인튜닝과 동일하다. 따라서 LoRA는 full fine-tuning의 일반화된 버전이라고 할 수 있다. LoRA는 기존 가중치 행렬에 학습된 행렬 \(BA\)를 선형 결합하기 때문에 연산 속도에 거의 차이가 없다. 또한 여러 가지 task에 대해서 LoRA 파인튜닝 가중치를 변경하는 것이 자유롭기도 하다. 이는 추가 학습 레이어를 붙이는 등의 접근과 달리 연산량과 편의성 모두에서 이점이 있다.
APPLYING LoRA TO TRANSFORMERS
LoRA를 트랜스포머에 적용할 때 어텐션 레이어의 가중치 \((W_q, W_k, W_v, W_o)\)에만 적용하도록 했다. LoRA를 적용했을 때 필요한 VRAM 용량이 감소했고, model checkpoint가 35MB로 감소했으며(low-rank 행렬만 저장하면 되기 때문에 기존 350GB에서 큰 감소) full-tuning과 비교해서 학습 속도도 25%나 빨라졌다. 그럼에도 LoRA는 서비스 측면에서 봤을 때에는 \(B_1A_1\) 가중치가 필요한 질문과 \(B_2A_2\) 가중치가 필요한 질문이 들어왔을 때 두 가지 입력을 동시에 처리할 수는 없다는 문제점을 가지기는 한다.
UNDERSTANDING THE LOW-RANK UPDATES
다른 추가 학습 기법과 비교해서 LoRA는 좋은 성능을 보이는 것을 실험을 통해 확인할 수 있었다. 그렇다면, 트랜스포머를 사용하는 모델에서, 어느 가중치에 LoRA를 적용해야 할까? LoRA에서 “rank”를 얼마로 설정해야 할까? \(\Delta W\)와 \(W\)는 얼마나 큰 연관성과 차이를 가질까?
WHICH WEIGHT MATRICES IN TRANSFORMERS SHOULD WE APPLY LoRA TO
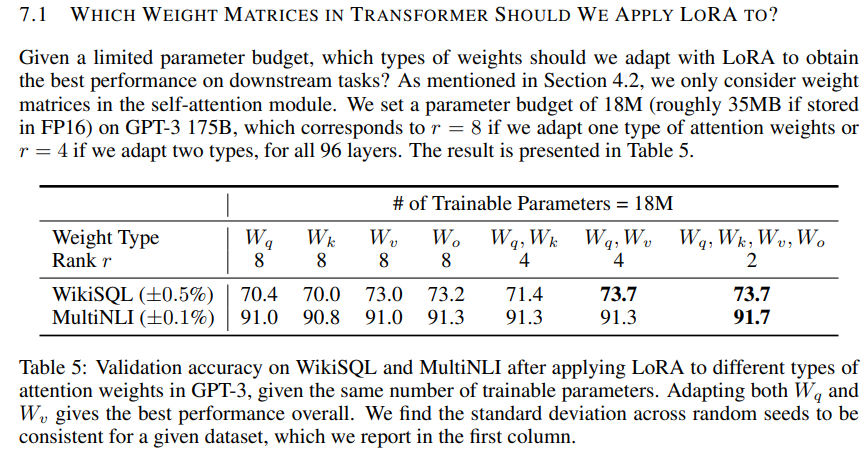
Table 5를 보면 학습 파라미터 수를 고정한 상태에서 rank와 LoRA를 적용하는 가중치 종류(\(W_q, W_k, W_v, W_o\)) 조합을 변경해가며 실험했을 때 하나의 가중치에 큰 \(r\)을 몰아주는 것보다 여러 종류의 가중치에 낮은 \(r\)을 나누어 적용하는 것이 더 좋은 성능을 보였다. 따라서 큰 rank로 가중치 하나만 학습하는 것보다 낮은 rank로 여러 종류의 가중치를 함께 학습하는 것이 효과적이다.
WHAT IS THE OPTIMAL RANK \(r\) FOR LoRA
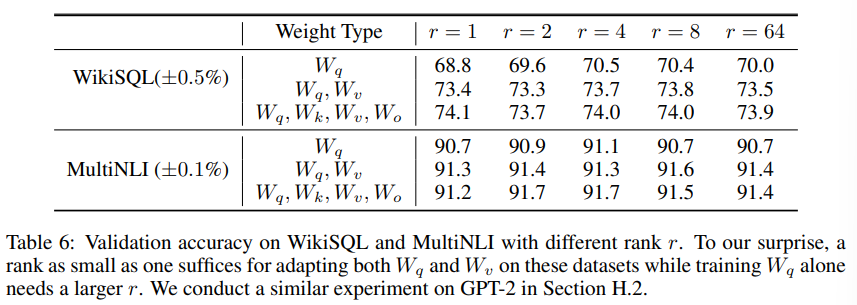
rank를 변경하며 실험했을 때 작은 r에서도 충분한 학습 성능을 보였다. 이는 \(\Delta W\)가 아주 작은 intrinsic rank를 가지고 있음을 보이며 유의미한 subspace를 구성하기 위해서 큰 rank가 필요하지 않음을 보인다.