Generative Modeling by Estimating Gradients of the Data Distribution
https://yang-song.net/blog/2021/score/#controllable-generation-for-inverse-problem-solving
Introduction
- 현재의 생성 모델들은 확률 분포를 어떻게 표현하는지에 따라서 두 가지로 구분될 수 있다.
- likelihood-based models
- maximum likelihood를 추정해 확률 밀도(질량) 함수를 직접 학습한다.
- autoregressive models, energy-based model(EBMs), variational auto-encoders(VAEs) 등을 포함한다
- implicit generative models
- sampling process를 통해 확률 분포를 표현한다.
- generative adversarial networks(GANs): 신경망에 랜덤한 Gaussian vector을 전달해 새로운 샘플을 만들어낸다.
- likelihood-based models
- 두 가지 종류의 모델 모두 한계를 가진다. Likelihood-based model은 model architecture에 제한을 가지는데 likelihood를 계산할 때 tractable normalizing constant를 보장하기 위해서이다. Implicit generative model은 adversarial training을 종종 요구하는데 이는 불안정한 경우가 있다.
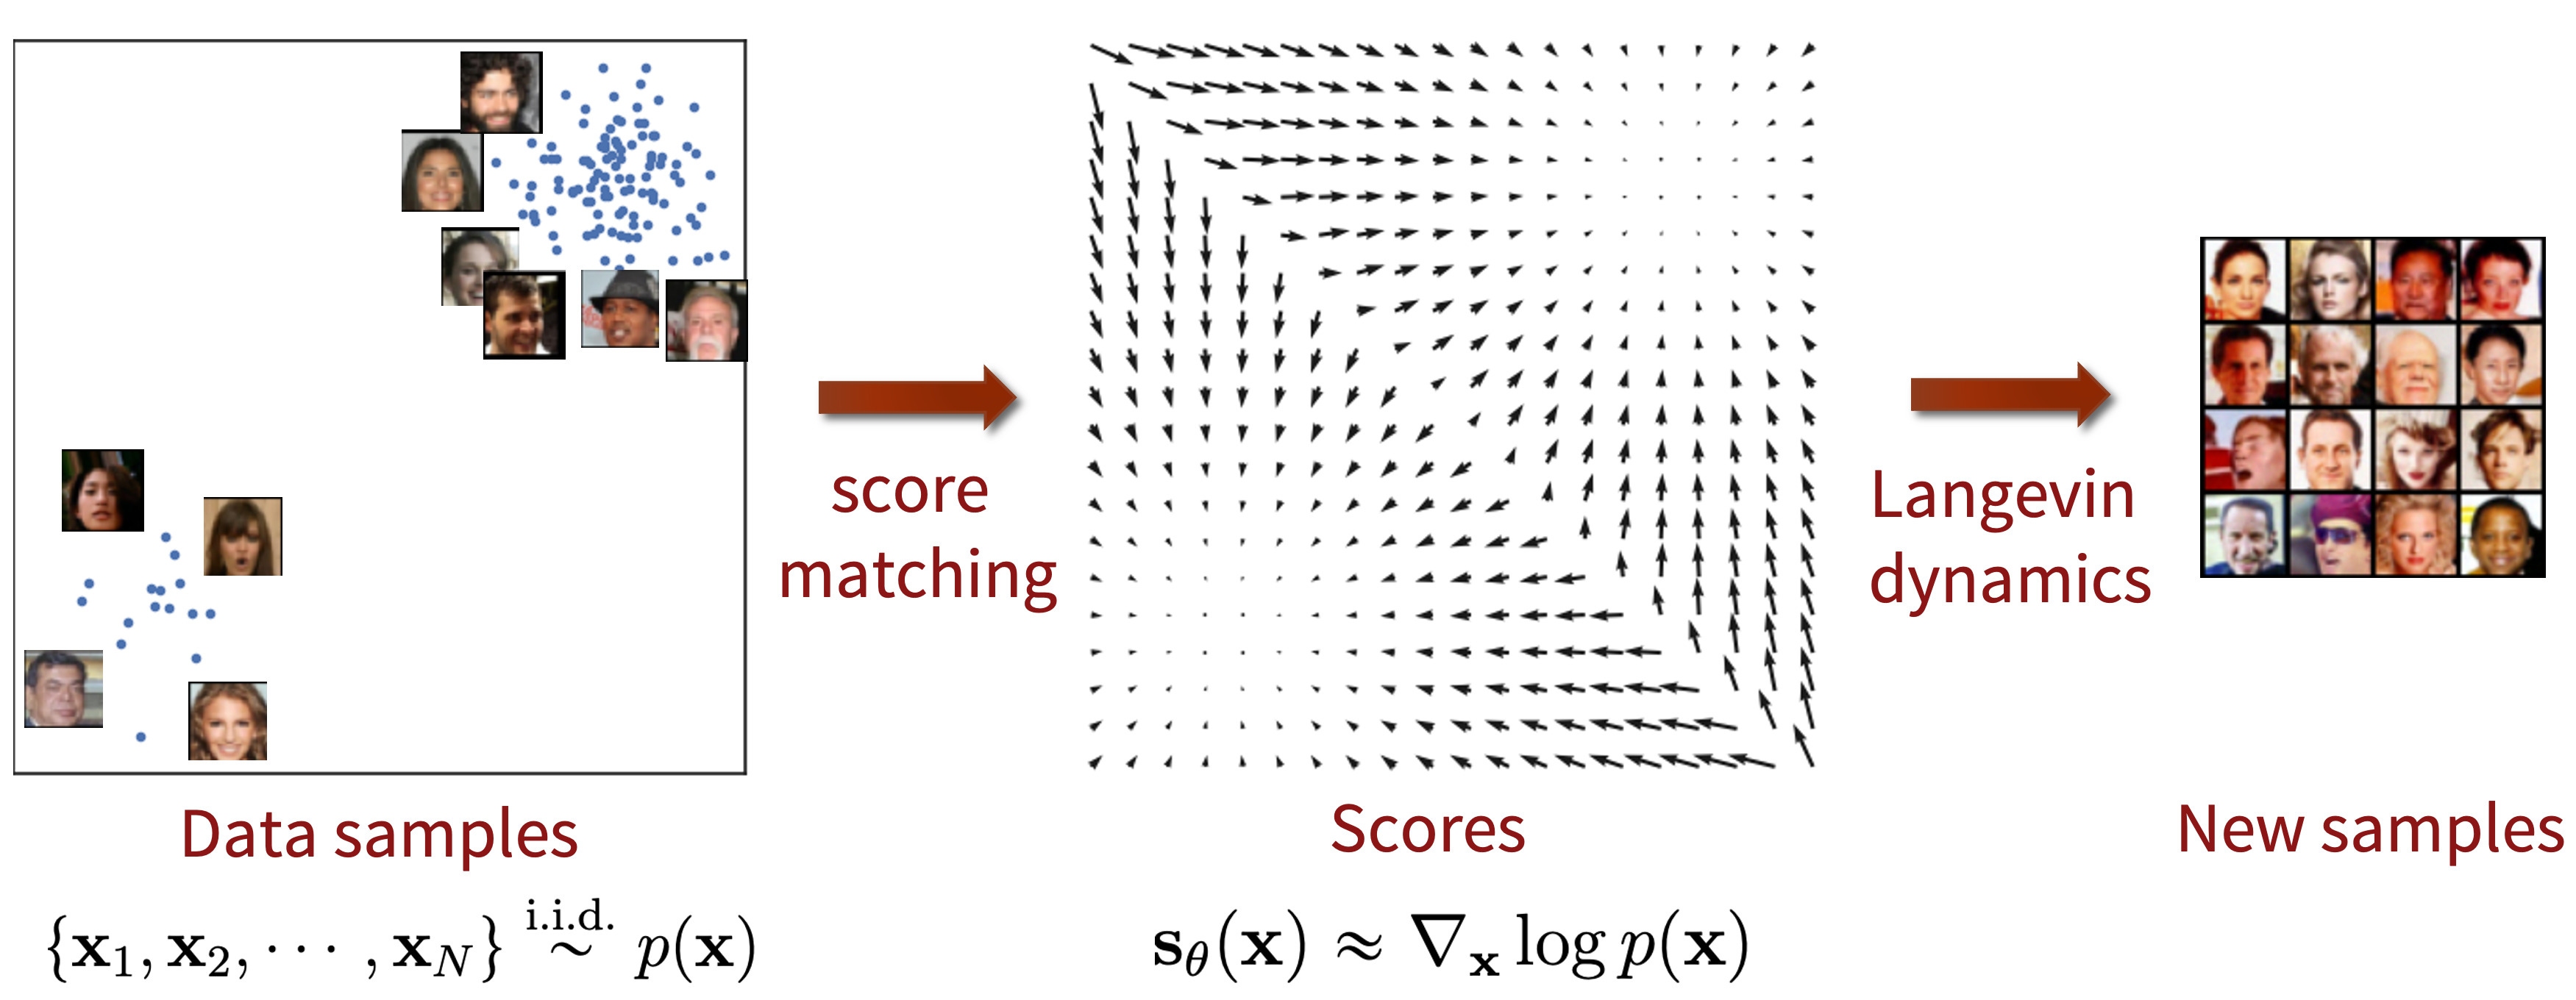
- 본문에서는 이러한 제약을 피해서 확률 분포를 표현하는 방법을 다룬다. 아이디어의 핵심은 gradient of the log probability function을 모델링하는 것이다. 이 값은 score function으로 알려져 있으며 score-based model들은 tractable normalizing constant를 요구하지 않고 직접적으로 score matching을 통해 학습이 가능하다.
The score function, score-based models, and score matching
- 데이터 분포에서 독립적으로 선택된 N개의 데이터를 보유하고 있다고 하자. 생성 모델의 목표는 이 데이터를 통해 데이터 분포를 학습해서 해당 분포를 통해 새로운 데이터를 만들어내는 것이다. 이러한 생성 모델을 만들기 위해, 우리는 확률 분포를 표현하는 방법을 알아야 한다. Likelihood-based-model에서 사용되는 방법으로, 확률밀도(질량)함수를 learnable parameter(theta)를 통해 직접 학습할 수 있다. 아래의 식에서 Z > 0은 정규화 상수이다. 함수 f는 주로 unnormalized probabilistic model이나 energy-based-model이라고 불린다. p는 log-likelihood를 최대화 하는 방향으로 학습된다.
- 이 방법은 단점이 있는데 위의 식에서 likelihood를 최대화 하는 p를 찾으려면 p가 normalized-probability-distribution을 따라야 한다는 조건이 필요하고 이를 위해서 Z를 계산해야 하는 일이 발생한다. 따라서 maximum likelihood training을 가능하게 하려면 Z를 계산 가능하게 하기 위해서 model architecture가 제한된다. 아니면 Z를 근사해야 하는데 이는 computation cost를 많이 발생시킨다.
- Normalizing constant를 찾기 어렵다는 단점을 해결하기 위해 score function이 도입되었다. score function은 다음과 같은 형태로 나타난다.
- Score function을 사용했을 때의 장점을 수식을 통해 판단해보자. p에서 Z가 분모에 존재하는데 log를 취했을 때는 곱셈을 덧셈으로 변형할 수 있고 그래디언트를 취하면 Z는 상수항으로 사라진다. p를 추정하는 대신에 f만 추정하면 되는 문제로 바뀌었다. Score-based model을 학습할 때에는 Fisher divergence를 사용하게 된다.
- Fisher divergence는 score와 score-based model의 ground-truth data score의 거리를 비교한다. 하지만 이 방법은 직접적으로 알 수 없는 \(\nabla_\mathbf{x} \log p(\mathbf{x})\)을 필요로 한다. 하지만 ground-truth data score을 직접 구할 필요 없이 Fisher divergence를 구할 수 있는 score matching이라는 방법이 존재한다. Score matching objectives는 데이터로부터 직접적으로 stochastic gradient descent를 통해 optimized될 수 있다. Score-based model은 adversarial optimization을 사용하지 않고 score matching object를 최소화하는 방향으로 학습된다.
- Score matching objective를 사용하는 것은 모델을 유연하게 사용할 수 있도록 한다. Fisher divergence에서의 \(s_\theta(x)\)는 score function과의 거리만 비교하기 때문에 실제 score function의 형태에 대한 가정이 필요하지 않으며 score-based model의 유일한 조건은 vector-valued function이 되어야 한다는 것 뿐이다.
Langevin dynamics
- Score-based model을 학습한 후, 샘플을 만들어내기 위해 Langevin dynamics이라는 과정을 거친다. Langevin dynamics는 MCMC(Markov Chain Monte Carlo)과정을 통해 분포로부터 score function 만을 이용해 분포를 만들어 낼 수 있도록 한다.
- prior distribution \(x_i\)가 임의의 분포를 따를 때 그 다음 state는 위와 같이 표현 가능하다. \(\mathbf{z}_i \sim \mathcal{N}(0, I)\)이고 \(\epsilon\)이 0으로 가고, \(K\)가 무한대로 갈 때 위의 과정은 \(p(x)\)로부터의 샘플로 수렴하게 된다. \(\epsilon\)이 충분히 작고, \(K\)가 충분히 크다면 오차는 무시할 수 있게 된다. 위에서 score matching objective를 통해 \(s_\theta(x)\)를 score based function으로 근사했고 이를 적용하면 샘플을 \(s_\theta(x)\)를 이용해 만들어 낼 수 있게 된다.
Naive score-based generative modeling and its pitfalls
- 이전까지 score-based model을 score matching을 통해 학습시키고, Langevin dynamics를 이용해 샘플을 생성해내는 과정을 다루었다. 하지만, 이러한 접근은 실제 적용에서 한정적인 성과만을 내었다. Score-based model이 가지고 있는 함정에 대해서 다루어보고자 한다.
- Score-based model이 가지고 있는 단점은 low density regions에 대하여 정확성이 떨어진다는 점이다. 우리는 아래 식과 같이 Fisher divergence를 최소화하는 방법으로 score function을 추정했다.
- Fisher divergence를 계산하는 과정에서 \(p(x)\)가 작은 low density region에서는 제대로 학습이 되지 않을 수 있다. Langevin dynamics을 통해 데이터를 샘플링 할 때, initial sample는 low density region에서 만들어질 것이다. low density region에서 만들어진 샘플은 score가 부정확하기 때문에 input data에 대한 부분으로 이동할 수 없고 높은 품질의 샘플을 만들지 못하게 된다.
Score-based generative modeling with multiple noise perturbations
- Low density region에 대한 문제를 해결하기 위해서 다음과 같은 방법을 사용한다: perturb data points with noise and train score-based models on the noisy data point. 데이터에 노이즈를 추가한 후 score-based model을 학습하는 방법이다. 노이즈가 충분히 크다면, low density region에서 estimated score가 accurate하도록 데이터를 변형된다. 그렇다면 perturbation process를 위한 적절한 noise scale은 어떻게 설정할 수 있을까? 더 큰 노이즈는 더 많은 low density region에서 score estimation이 가능하도록 하겠지만 original distribution과 차이가 줄어들어 score가 original distribution을 찾아가지 못하게 할 수도 있다. 반대로, 노이즈가 너무 적다면, original distribution의 특성을 보존하기는 하겠지만, low density region을 적합하게 cover할 수 없다는 문제가 생긴다(해당 영역에서 score가 initial distribution을 찾아갈 수 없도록 함).
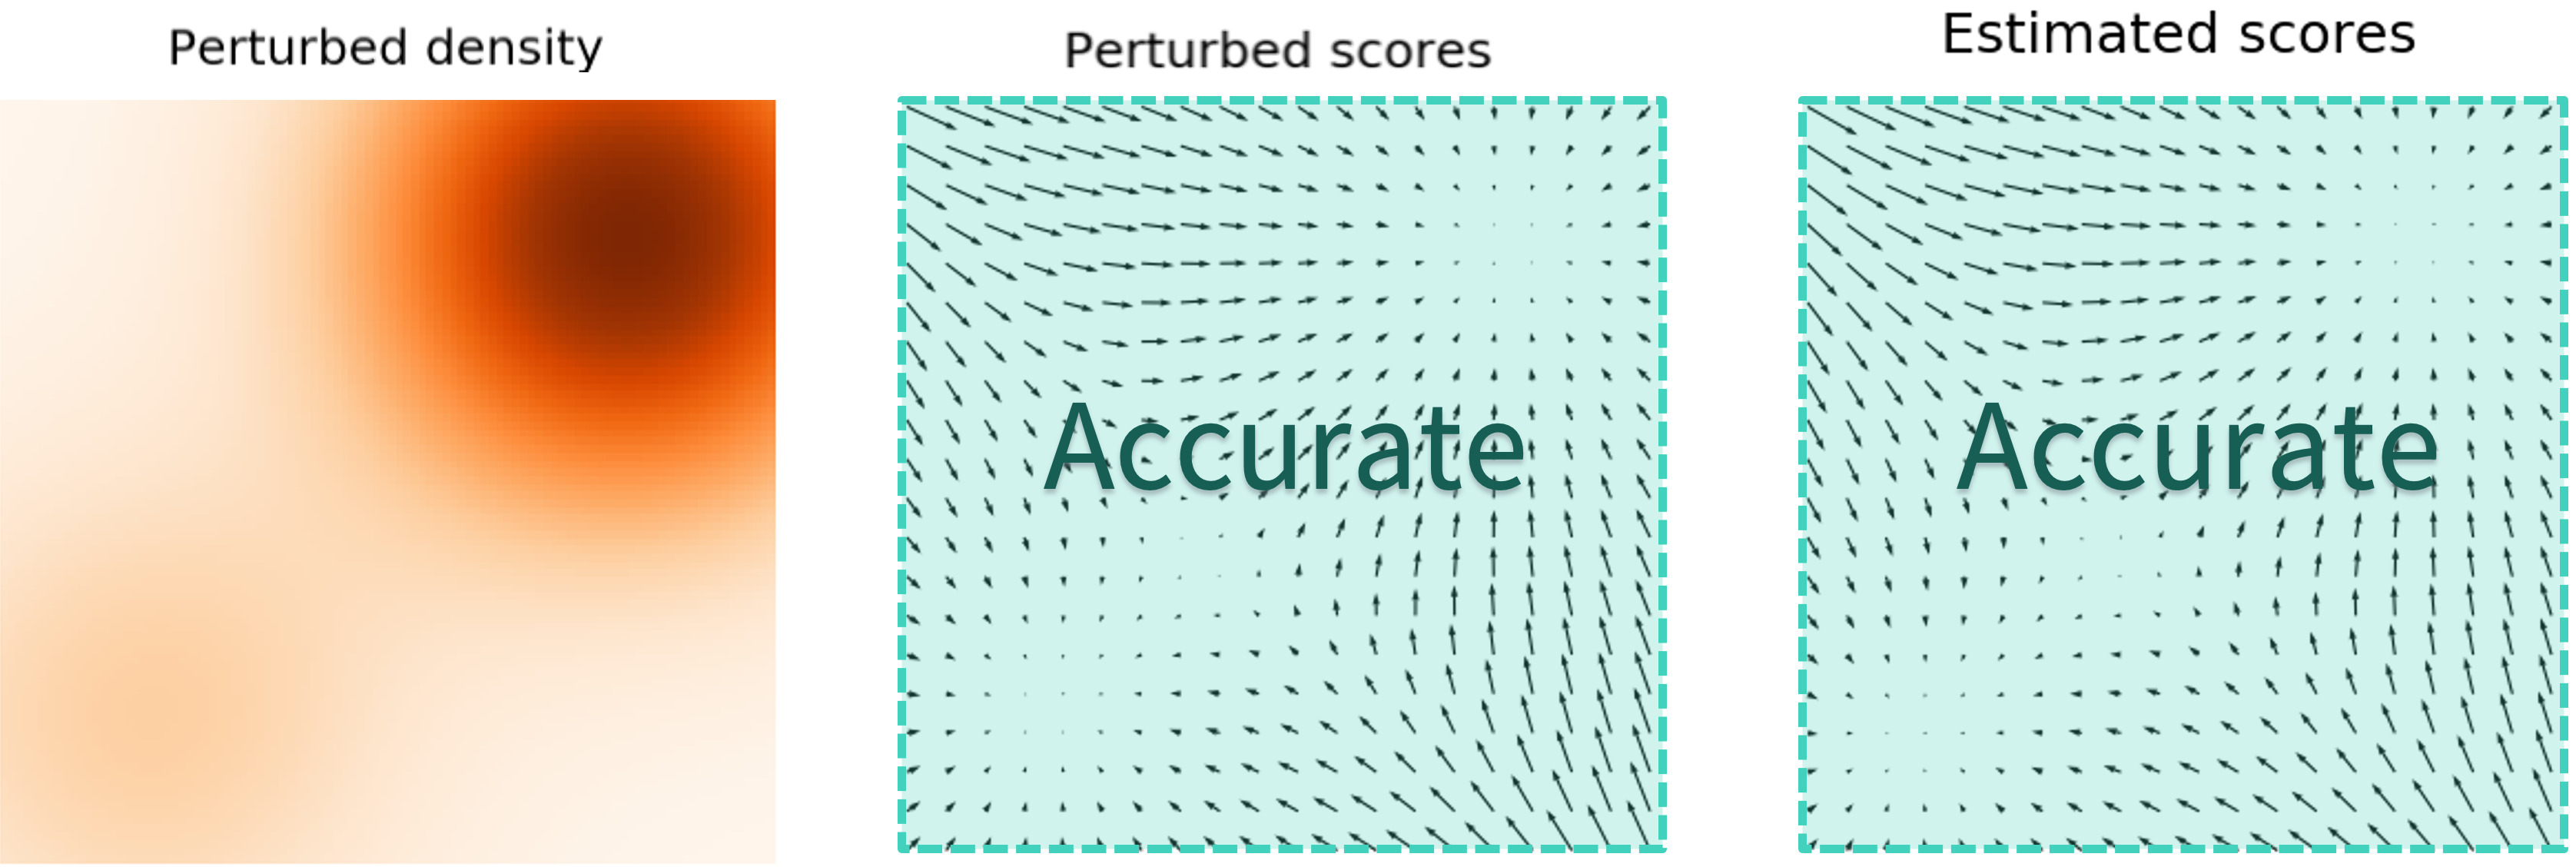
- 결국 “적절한” 수준의 노이즈를 추가해야 하는데, 이에 대한 방법으로 다양한 scale의 perturbation을 동시에 적용한다. Isotropic Gaussian noise를 따라서 data를 perturb한다고 생각해보자. 그리고 L개의 증가하는 표준편차가 존재한다. 우리는 데이터 분포 \(p(x)\)에 Gaussian noise \(\mathcal{N}(0, \sigma_i^2 I), i=1,2,\cdots,L\)를 추가해 noise-perturbed distribution을 얻는다.
- 위의 샘플은 \(\mathbf{x} \sim p(\mathbf{x})\)에 대하여 \(\mathbf{z} \sim \mathcal{N}(0, I)\)을 계산함으로써 얻을 수 있다. 이후 각각의 noise-perturbed distribution에 대하여 score function을 Noise Conditional Score Network(NCSN)을 통해 학습시킬 수 있다. \(\mathbf{s}_\theta(\mathbf{x}, i) \approx \nabla_\mathbf{x} \log p_{\sigma_i}(\mathbf{x})\)이때 score function이 score matching을 통해 매개화 되었을 때 추정이 가능해진다.
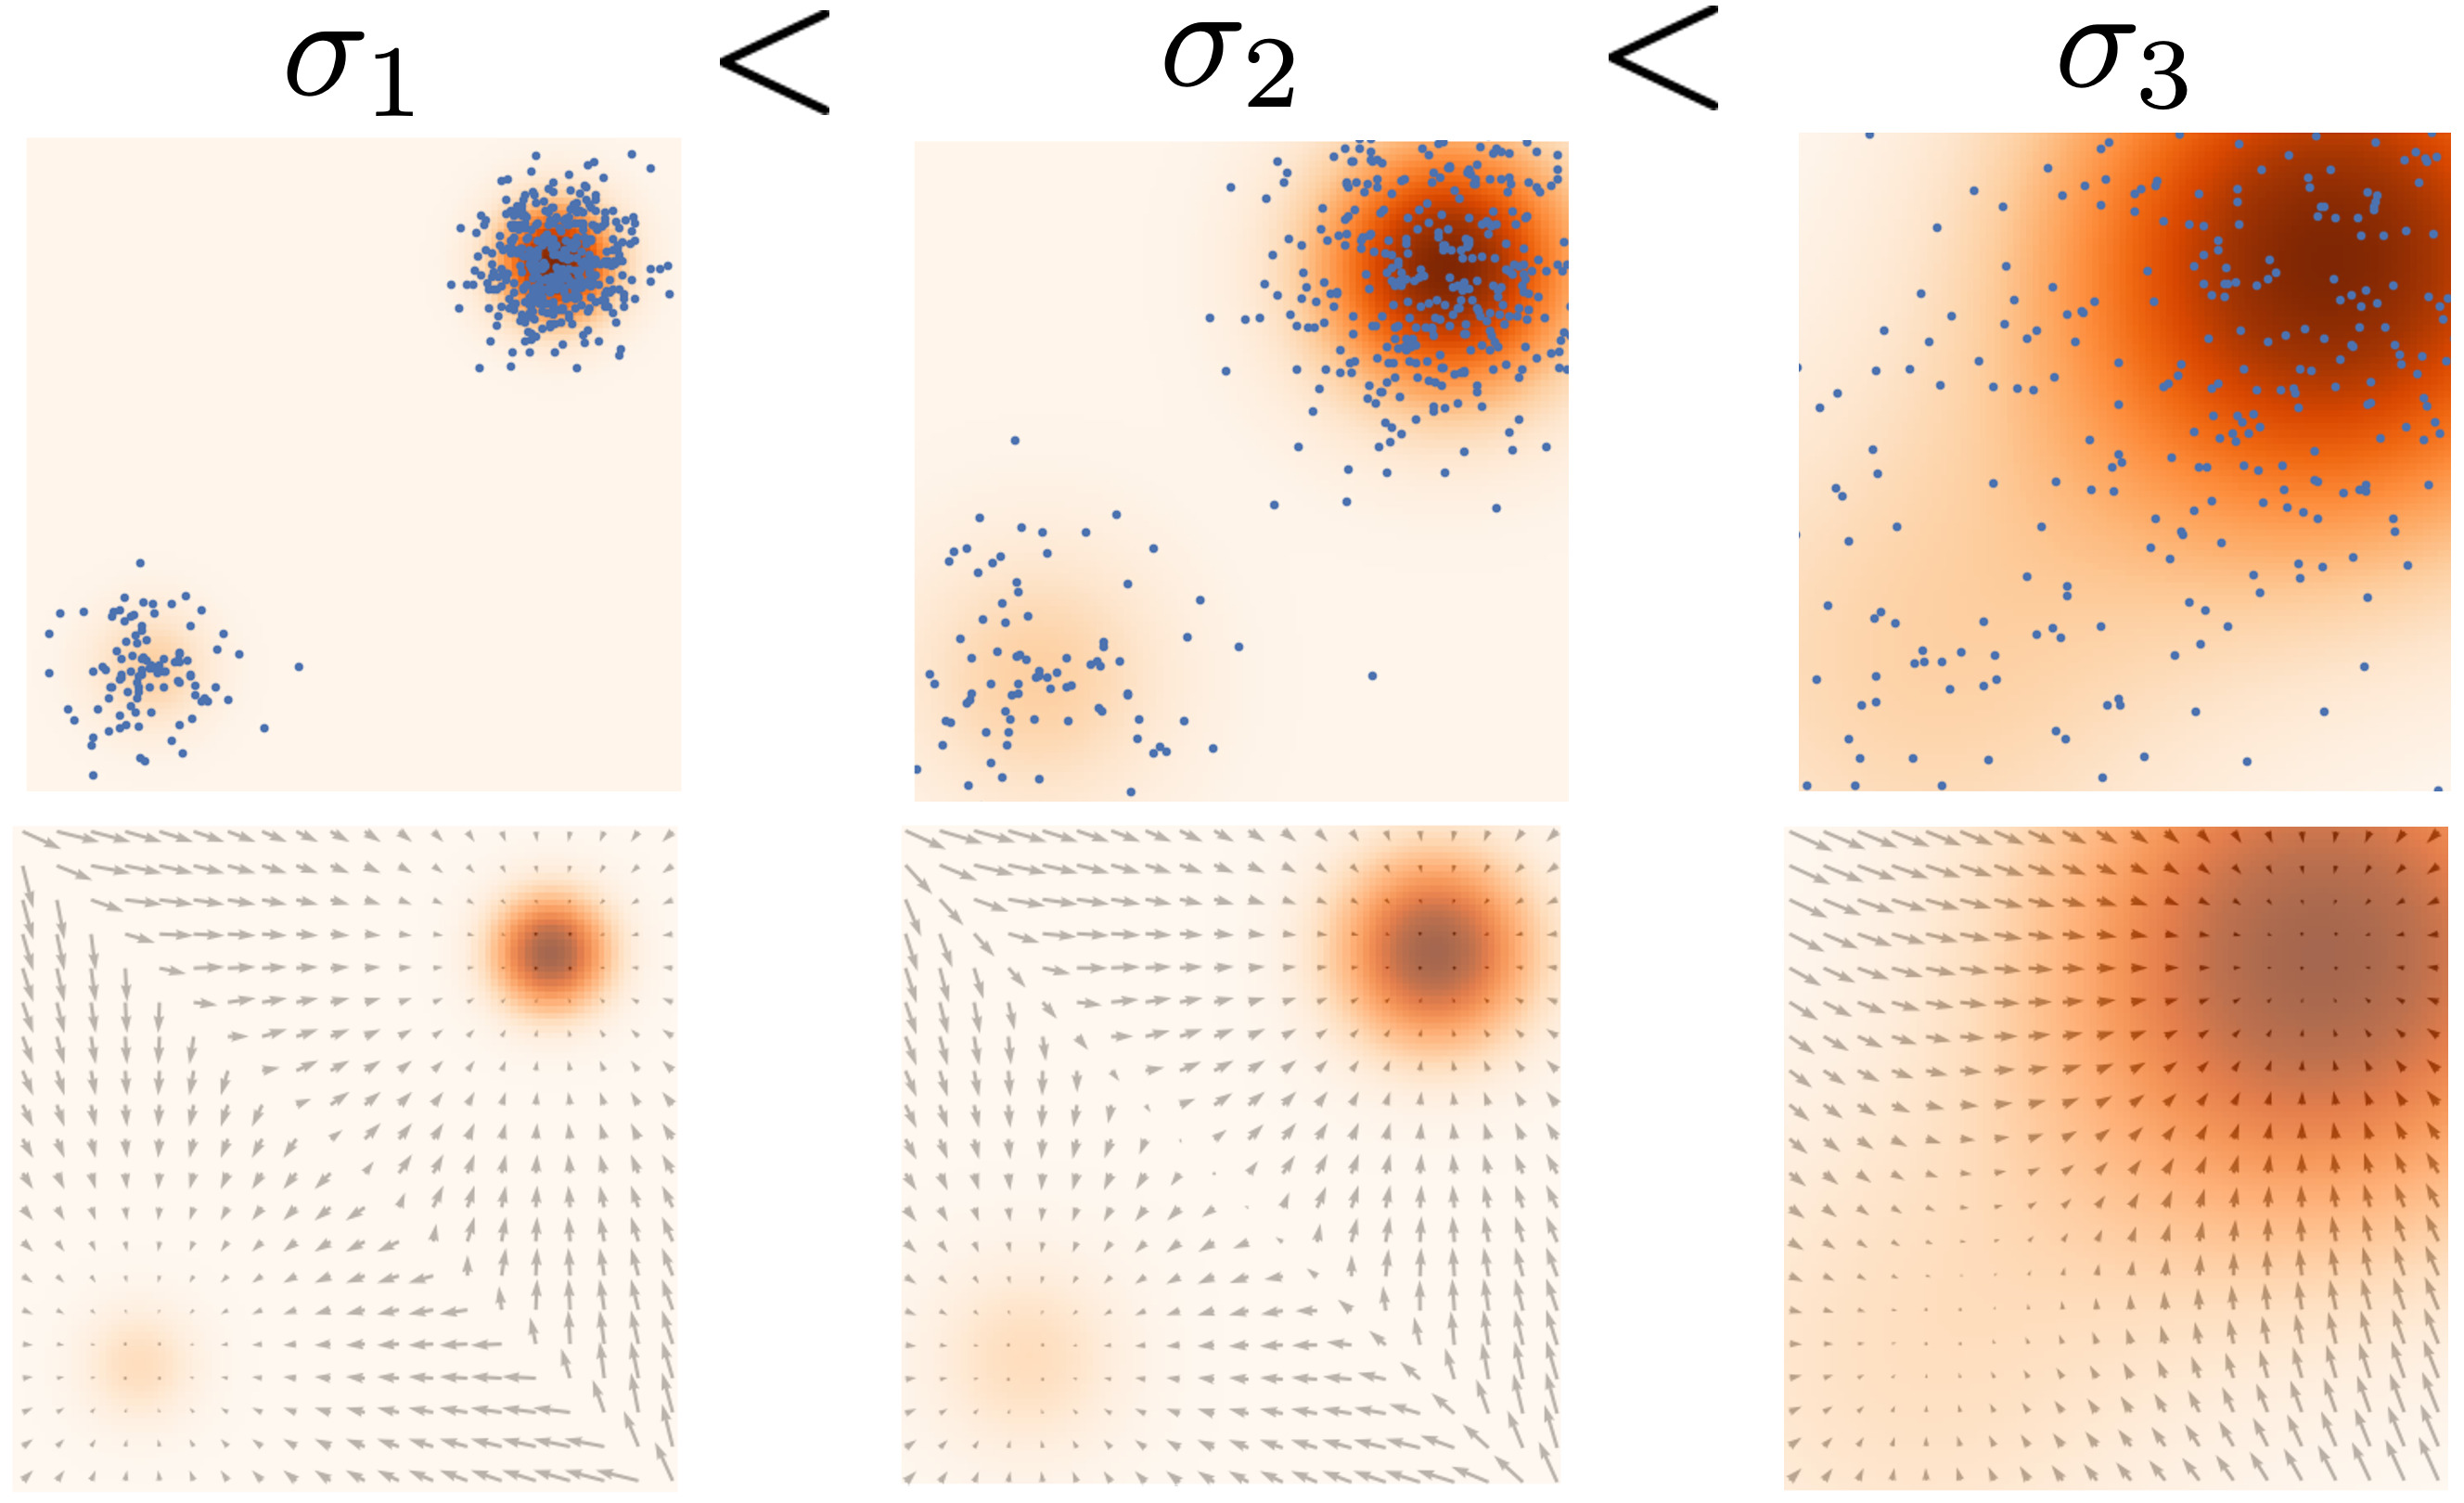
- \(s_\theta(x, i)\)를 학습시킬 때의 목적 함수는 모든 noise scale에 대한 Fisher divergence의 가중합이다.
- \(\lambda(i) \in \mathbb{R}_{>0}\)은 양의 실수 범위를 가지는 가중치 함수이고 주로 \(\lambda(i) = \sigma_i^2\)로 선택이 된다. 위의 목적함수는 score matching을 통해 optimized된다.
- 모델을 학습시킨 후 샘플을 Langevin dynamics를 통해 만들어낼 수 있다. 이 과정은 annealed Langevin dynamics라고 불리며 이 과정에서 noise scale \(\sigma_i\)는 점점 줄어든다. Score-based generative model을 tuning할 때에는 다음과 같은 방법을 사용하면 좋다.
- \(\sigma_1 < \sigma_2 < \cdots < \sigma_L\)가 지수적으로 증가하도록 선택한다. \(\sigma_1\)과 \(\sigma_L\)이 충분한 차이를 보이도록 해 모든 training data points에 대하여 maximum pairwise distance에 대하여 comparable한 차이를 보이도록 할 수 있어야 한다. L은 수백, 수천 정도의 수로 설정한다.
- \(s_\theta(x, i)\)를 U-Net skip connection으로 매개화한다.
- score-based model의 가중치에 exponential moving average를 적용한다.
Score-based generative modeling with stochastic differential equations(SDEs)
- multiple noise scales를 추가하는 것은 score-based generative models를 학습하는데 핵심적으로 작용한다. noise scale의 수를 무한히 늘리면, 좋은 품질의 샘플을 얻을 수 있고, 정확한 log-likelihood를 계산할 수 있으며, inverse problem solving을 조절할 수 있게 된다.
Perturbing data with an SDE
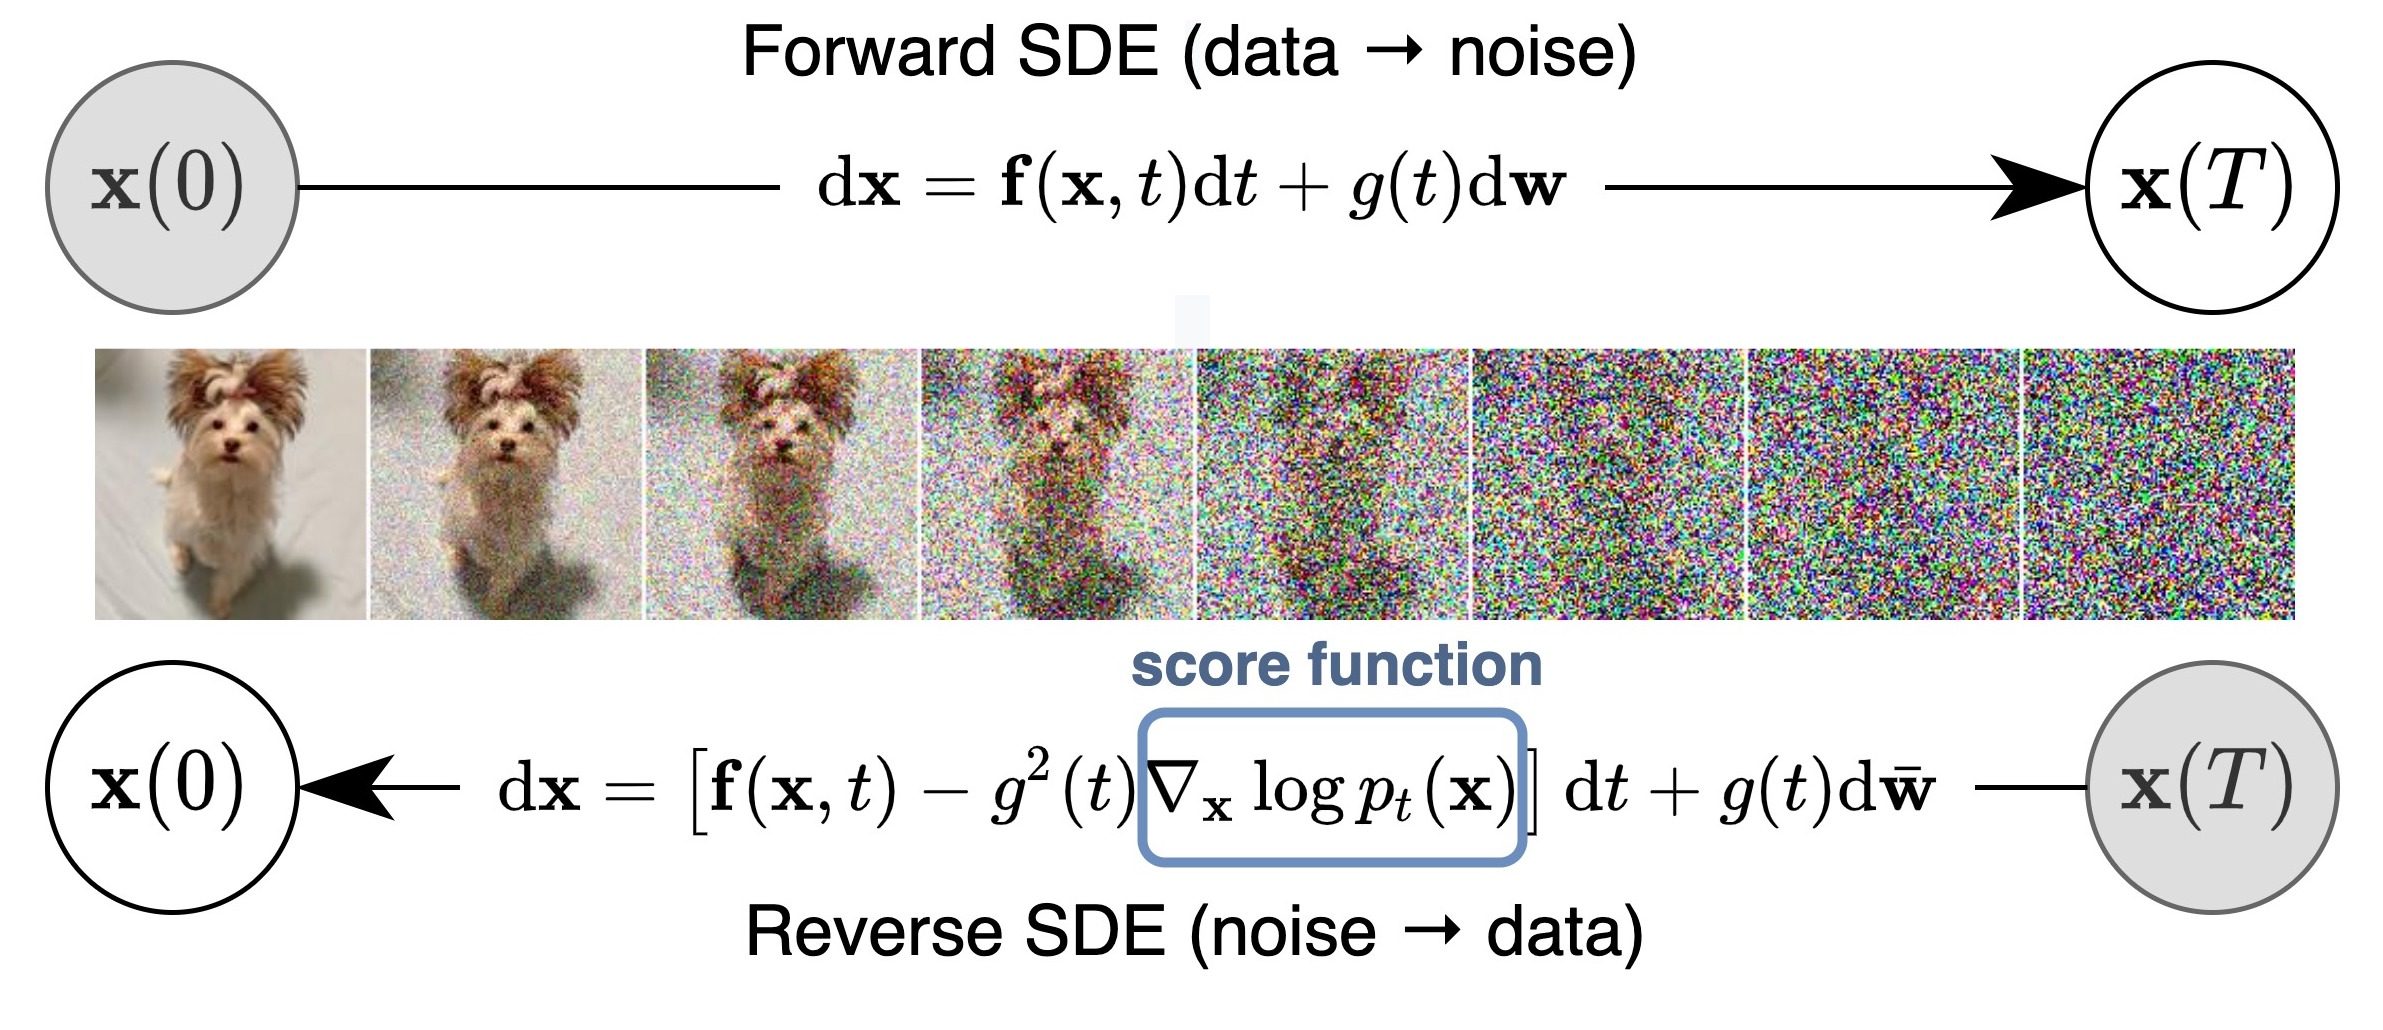
- noise scale 개수가 무한하게 증가하면, 우리는 데이터 분포에 점진적으로 증가하는 노이즈를 추가할 수 있고, 이렇게 된다면, noise perturbation process는 time-stochastic process가 된다. 그렇다면, stochastic process를 어떻게 표현할 수 있을까? 많은 stochastic process는 SDE의 해의 형태로 나타나게 된다. 일반적으로, SDE는 다음과 같은 형태를 가진다.
- \(f(x, t)\)는 drift coefficient라고 불리는 vector-valued function이다. \(g(t)\)는 diffusion coefficient라고 불리는 실수 범위 값을 갖는 real-valued function이다. w는 standard Brownian motion을 나타내고, \(dw\)는 infinitesimal white noise라고 생각할 수 있다. Stochastic differential equation의 해는 random variable \(\{ \mathbf{x}(t) \}_{t\in [0, T]}\)의 연속적인 집합으로 표현된다. 이러한 random variables들은 t가 증가함에 따라 stochastic trajectory를 따른다. 이때 \(p_t(X)\)가 marginal probability distribution function \(X(t)\)를 따른다고 하면 유한한 개수의 noise scale에 대하여, \(p_t(X)\)는 \(p_{\sigma_i}(X)\)와 유사해진다. \(p_0(X)=p(X)\)는 perturbation이 추가되지 않은 상태를 나타낸다. 이후 \(p(X)\)를 충분한 시간 T만큼 perturbate해 얻은 \(p_T(X)\)는 \(p_{\sigma_L}(X)\)와 유사해지게 된다.
- 이전에 sigma가 지수적으로 증가하도록 설정하겠다고 했는데 이를 적용한 SDE의 한 예시는 다음과 같다.
- 위의 SDE에서는 데이터를 \(\mathcal{N}(0, \sigma_1^2 I), \mathcal{N}(0, \sigma_2^2 I), \cdots, \mathcal{N}(0, \sigma_L^2 I)\) 순서에 따라 perturb하는 것을 나타낸다.
Reversing the SDE for sample generation
- Annealed Langevin dynamics를 이용해 perturbation process를 역변환해 샘플을 만들어낼 수 있다는 것을 앞서 다루었다. 무한한 noise scale에 대해서 우리는 reverse SDE를 통해 perturbation process를 analogously reverse해 샘플을 만들어낼 수 있다. 모든 SDE는 reverse SDE를 가지고 있으며 그 형태는 다음과 같다.
- \(dt\)는 negative infinitesimal time step을 나타낸다(SDE가 거꾸로 풀어져야 하기 때문). Reverse SDE를 구하기 위해서는 \(\nabla_\mathbf{x} \log p_t(\mathbf{x})\)를 알아야 하는데 이는 score function과 정확히 같은 형태이다.
Estimating the reverse SDE with score-based models and score matching
- Reverse SDE를 푸는 것은 \(p_T(X)\)와 score function을 아는 것을 필요로 한다. \(\nabla_\mathbf{x} \log p_t(\mathbf{x})\)를 추적하기 위해서, 우리는 Time-Dependent Score-Based Model \(s_\theta(X, t)\)를 학습시켜 \(\mathbf{s}_\theta(\mathbf{x}, t) \approx \nabla_\mathbf{x} \log p_t(\mathbf{x})\)이 되도록 만들어야 한다. 유한한 scale의 노이즈에 대해서는 \(\mathbf{s}_\theta(\mathbf{x}, i) \approx \nabla_\mathbf{x} \log p_{\sigma_i}(\mathbf{x})\)이라고 표현할 수 있다. \(s_\theta(X, t)\)에 대한 학습의 목적은 Fisher divergence에 대한 연속적인 가중치 조합을 찾는 것이다.
- \(\mathcal{U}(0, T)\)는 0~T까지의 time interval에 대한 uniform distribution이고 lambda는 양의 실수 범위를 가지는 weighting function이다. 일반적으로 다양한 score matching에 대하여 크기를 맞추기 위해 \(\lambda(t) \propto 1/ \mathbb{E}[\Vert{} \nabla_{\mathbf{x}(t)} \log p(\mathbf{x}(t) \mid \mathbf{x}(0))\Vert{}_2^2]\)과 같이 lambda를 설정한다.
- Fisher divergence의 가중치 조합은 score matching method로 효율적으로 최적화 될 수 있다. Score-based model이 학습되면, 이를 reverse SDE 수식에 대입해 estimated reverse SDE를 얻을 수 있다.
- \(X(T)\)가 \(\pi\)를 따르는 것으로 시작할 수 있고, reverse SDE를 풀어 sample \(X(0)\)를 얻을 수 있다. Score-based model이 잘 학습되었다면 \(p_\theta \approx p_0\)을 얻을 수 있다.
- \(\lambda(t) = g^2(t)\)라면 Fisher divergence의 가중치 조합과 KL divergence간의 연관성을 찾을 수 있다. 그래서 앞의 관계를 likelihood weighting function이라고 부른다. 이 함수를 사용하면 우리는 score-based generative model을 굉장히 높은 likelihood를 가지도록 학습시킬 수 있다.